担当者よりプロモーションコードをお送りいたします。
体験してみてください。
体験してみてください。
体験してみてください。
体験してみてください。
体験してみてください。
体験してみてください。
体験してみてください。
体験してみてください。
体験してみてください。
スロークエリの原因分析とチューニング
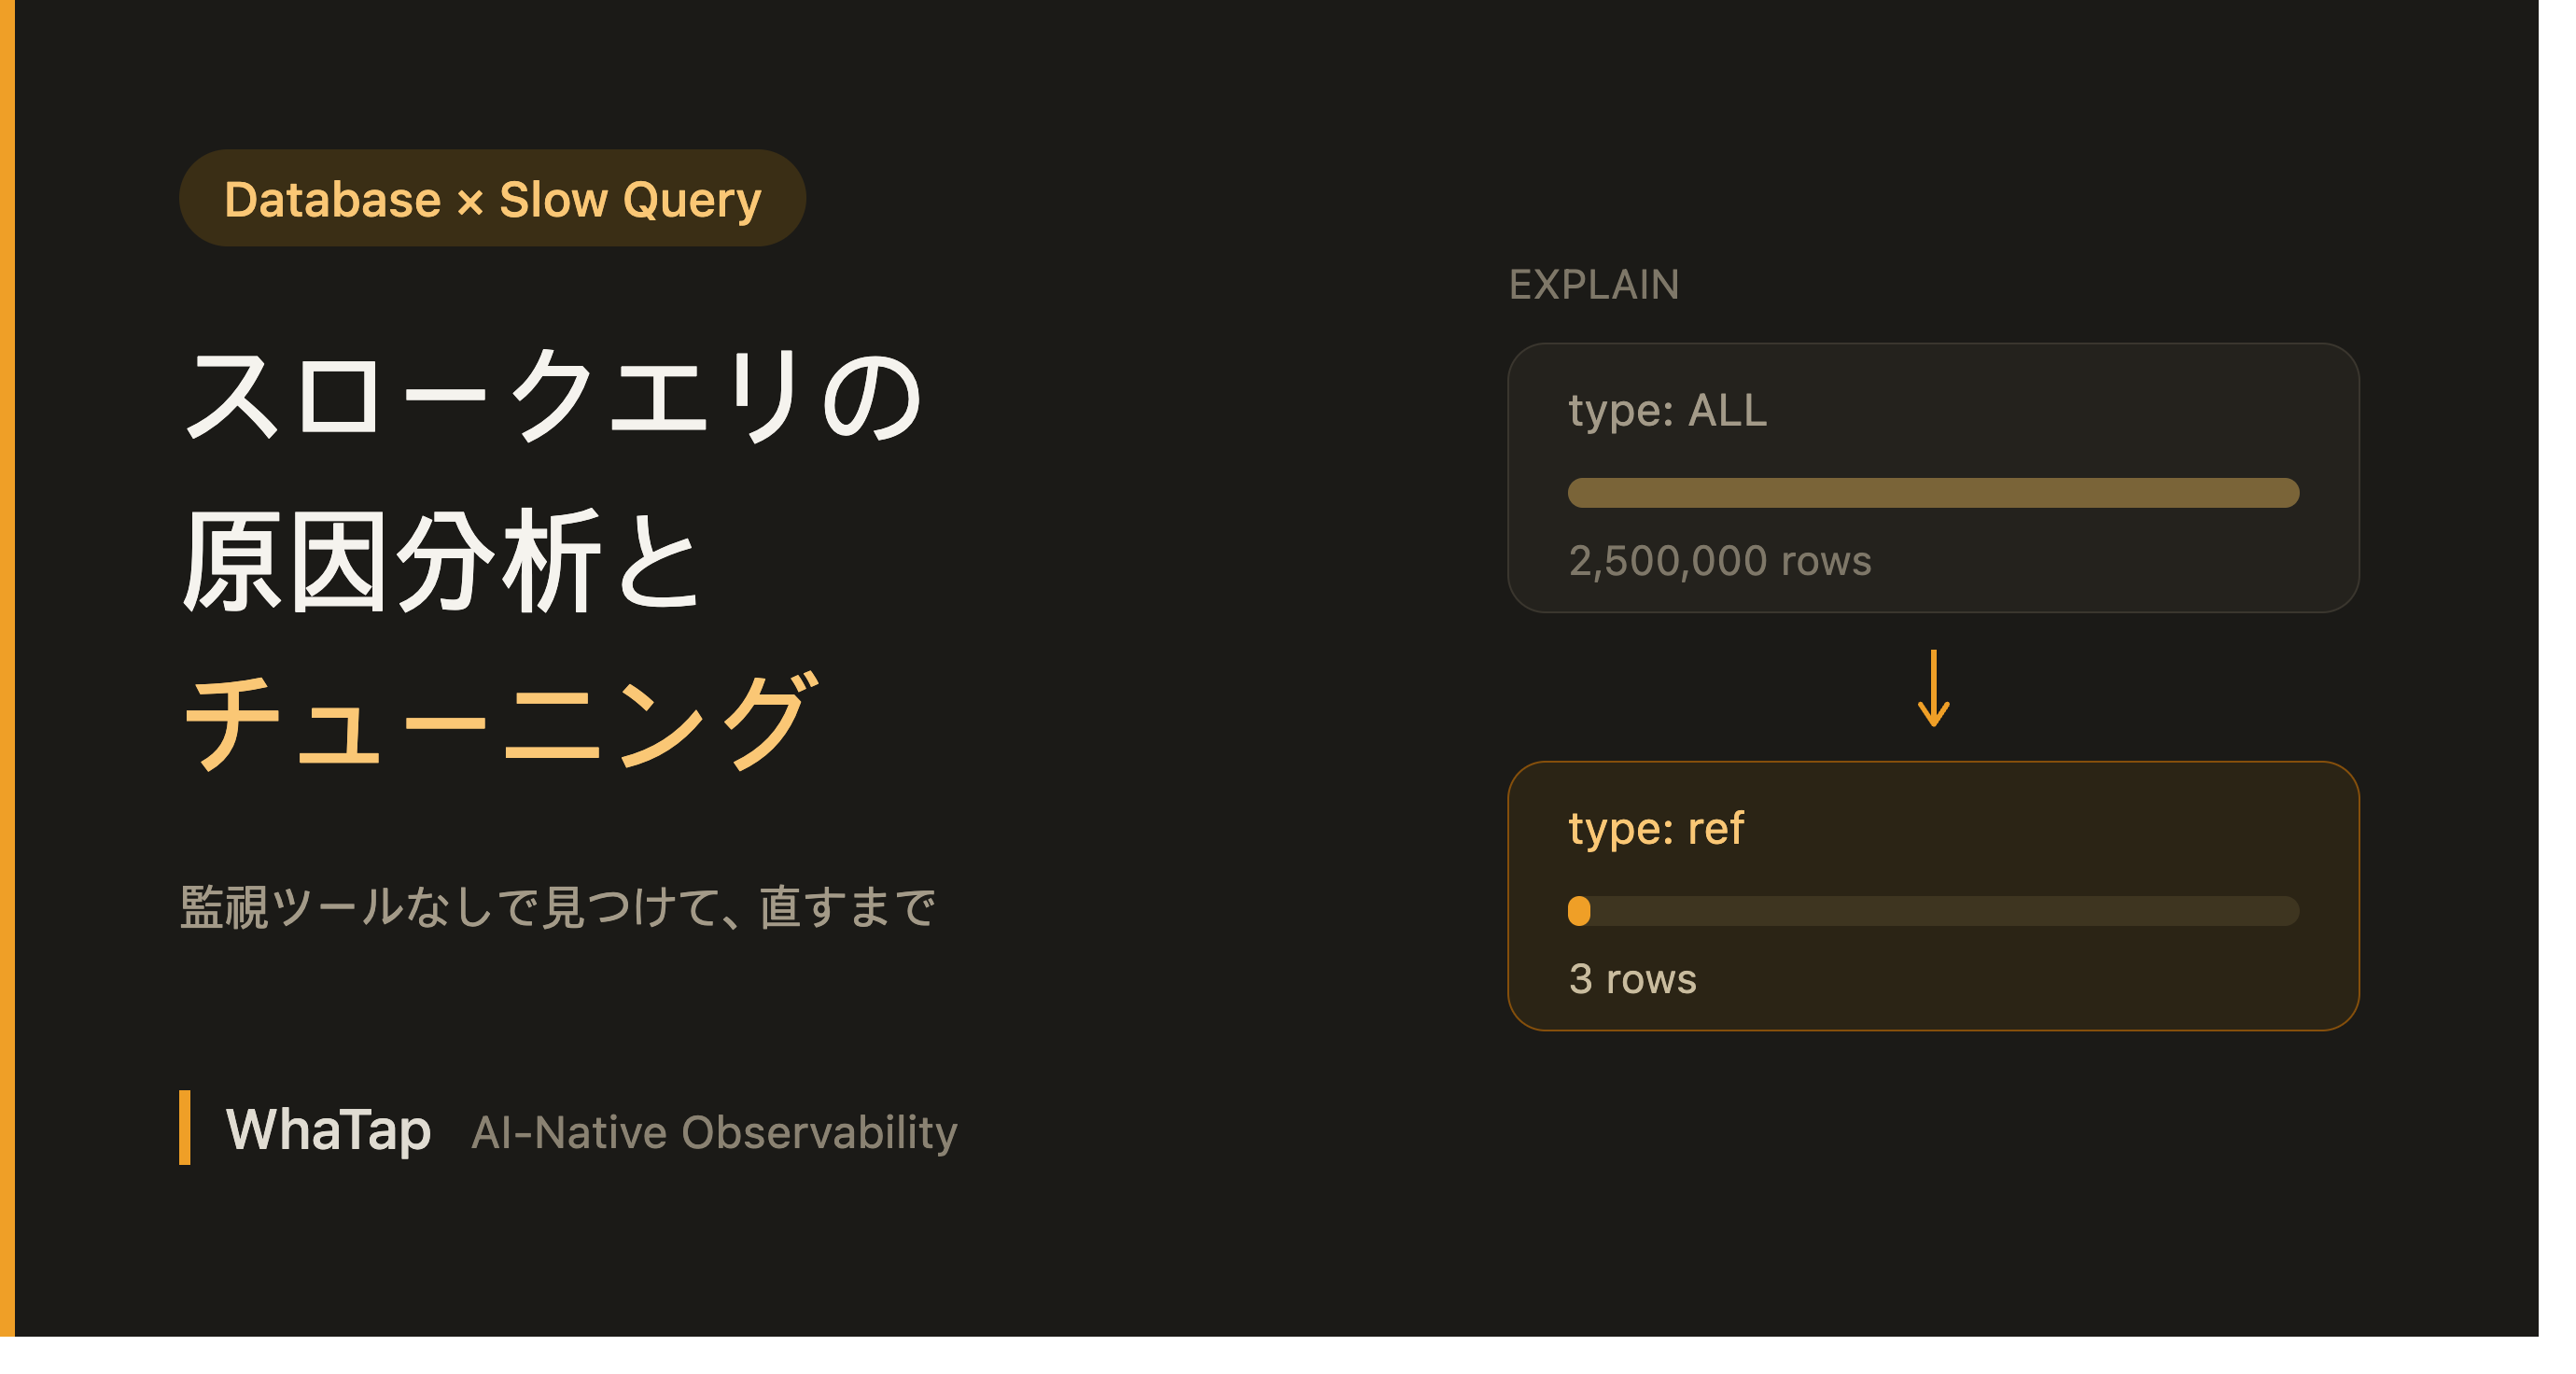
💡 APMもDPMもない状態でスロークエリを見つける方法。ログ、統計ビュー、セッションビューで遅いクエリを特定し、実行計画で原因を確認したうえで、インデックスから順に沿ってチューニングします。
こんにちは。AIネイティブなオブザーバビリティプラットフォーム、WhaTap(ワタップ)です。
デプロイが終わってサービスの状態を確認していると、APIの応答時間が最初は3秒、次は5秒と伸びていきます。リクエストが積み重なり、最終的にはタイムアウトで切断されます。こうしたとき、真っ先に疑うべきものの一つがDBのスロークエリです。
APM(アプリケーション性能監視)もDPM(DB性能監視)もない状態でデータベースを運用している状況があります。小規模なサービス、社内ツール、立ち上げたばかりのスタートアップ、引き継いだばかりのレガシーシステム等でよく見られます。
それでも心配は要りません。ほとんどのリレーショナルデータベースは、遅いクエリの記録、実行統計、現在セッションの照会機能を標準で備えています。
この記事では、データベースの標準機能を使ってスロークエリを見つけ、原因を分析したうえでチューニングする方法をMySQL・PostgreSQLを例に分かりやすくご紹介します。
この記事でわかること
✅ スロークエリを見つける3つの方法
✅ EXPLAINで確認すべきポイント
✅ インデックスを追加すべき判断基準
✅ SQLを書き換えるタイミング
✅ 監視ツールが必要になるケース
スロークエリの分析は、通常次の手順で行います。
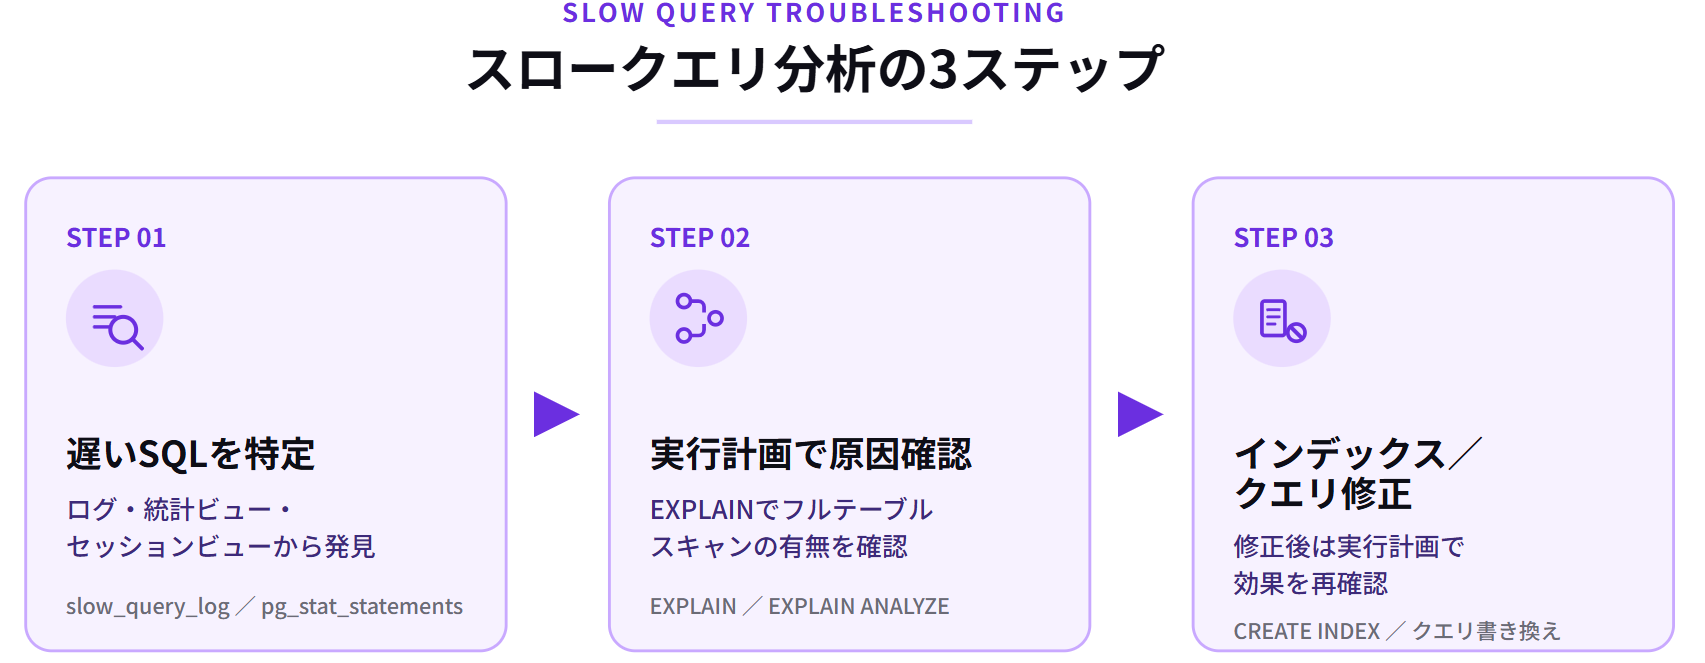
スロークエリ分析の3ステップ
STEP 01. どのSQLが遅いかを見つける
この記事では、上記の手順でスロークエリを分析する方法を見ていきます。
遅いクエリを見つける3つの方法
遅いクエリは、ログだけでも見つけられます。ただし簡単ではありません。ログは普段オフになっていることが多く、オンにしていても実行内容を1行ずつ並べるだけなので、数千行を集計してようやく実際に負荷を生んでいるSQLが見えてきます。また、しきい値より速いものの非常に頻繁に実行されるクエリや、いままさに実行中のクエリはログに現れません。
そこで、遅いクエリを見つける方法を3つに分けます。すでに実行が終わったクエリはログと統計ビューで確認し、現在実行中のクエリはセッションビューで確認します。この3つの情報だけで、ほとんどのスロークエリは見つけられます。
① エンジンのスロークエリログ(実行済みのクエリ)
もっとも直感的な方法です。しきい値を超えたクエリを、データベースがログに記録します。
MySQL、MariaDBはslow_query_logをオンにし、long_query_timeで基準時間を決めます。
SET GLOBAL slow_query_log = 'ON';
SET GLOBAL long_query_time = 1;
SET GLOBAL log_queries_not_using_indexes = 'ON';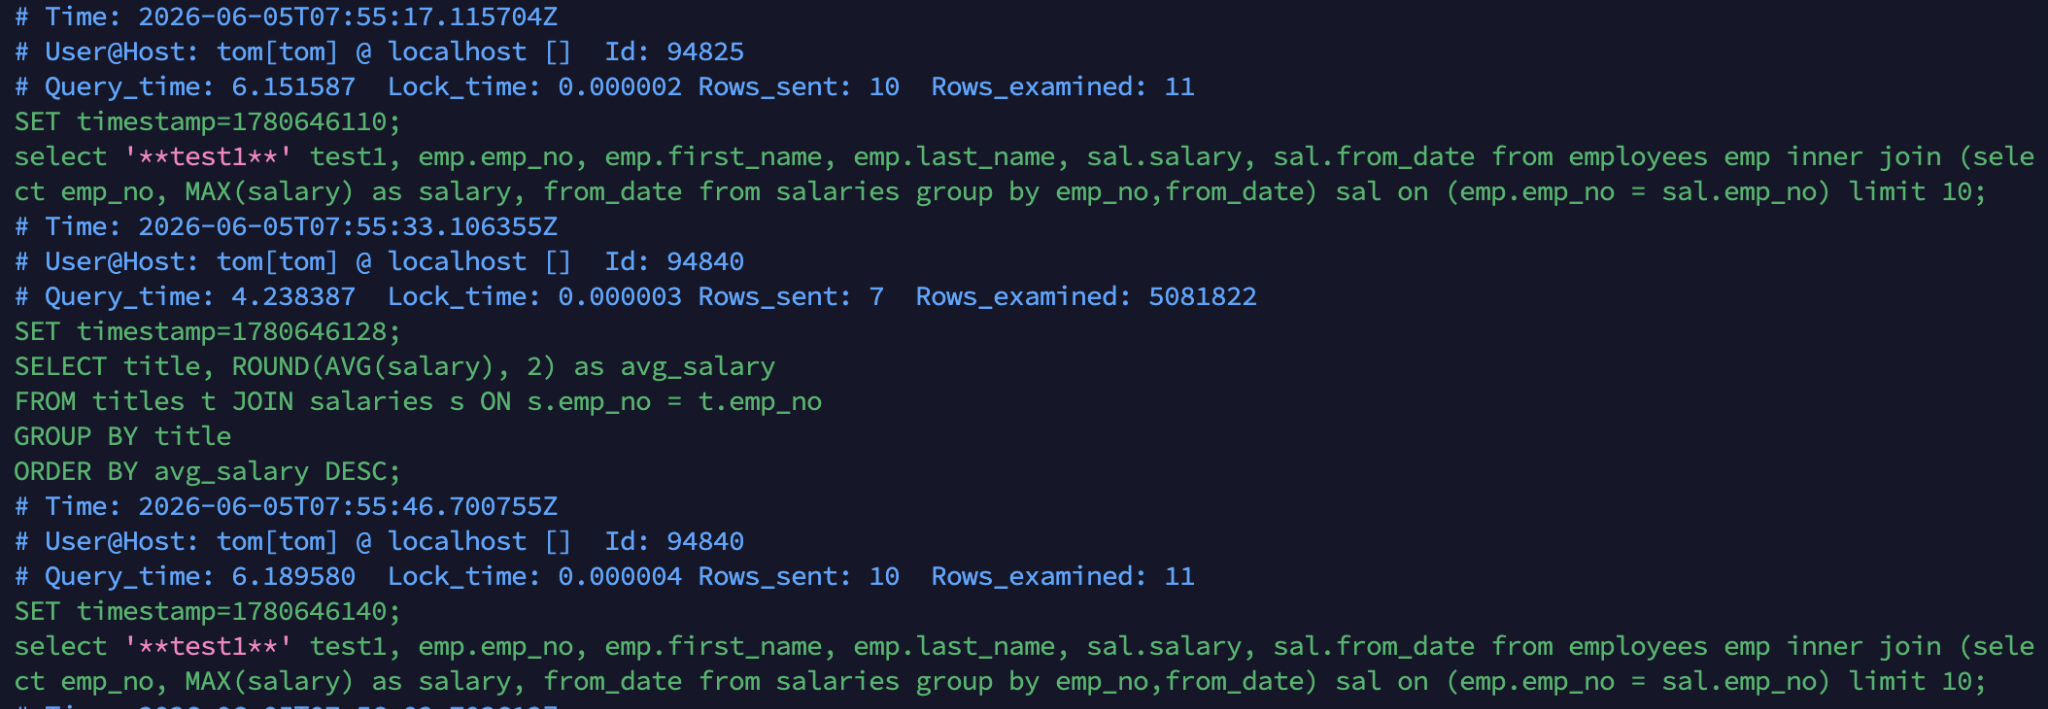
PostgreSQLはlog_min_duration_statementで基準時間を設定します。
SET log_min_duration_statement = 1000;SQL ServerはQuery Storeで実行履歴を保存でき、OracleはAWR・ASHまたはStatspackを通じて負荷の高いSQLを確認できます。
スローログの利点は、「どのSQLがどれだけ時間がかかったか」を正確に残せる点です。障害が過ぎたあとでも当時実行されたSQLを確認できるため、原因分析の出発点になります。
ただし、ログだけでは限界があります。しきい値より速いものの非常に頻繁に実行されるクエリは記録されず、現在実行中のクエリもまだログには残りません。こうした場合には、以下の2つの方法が必要になります。
② 累積統計ビュー(総実行時間基準)
ログが個別の実行記録を見せてくれるのに対し、統計ビューは同じ形のSQLをまとめて累積結果を見せてくれます。PostgreSQLではpg_stat_statementsが代表的です。
SELECT query, calls, total_exec_time, mean_exec_time
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 10;
MySQLはPerformance Schemaのevents_statements_summary_by_digest、OracleはV$SQL、SQL Serverはsys.dm_exec_query_statsを活用します。
ここで重要なのは並び替えの基準です。単発の実行時間ではなく、総実行時間(累積実行時間) で並び替える必要があります。
5秒かかるクエリが1日1回実行されれば、累積時間は5秒です。一方、0.5秒かかるクエリが1日1万回実行されれば、累積時間は5,000秒になります。実際にデータベースのリソースをより多く使っているのは後者です。
③ いま実行中のセッション
障害が現在進行中であれば、セッションビューがもっとも早い手がかりになります。
SELECT pid,
       now() - query_start AS duration,
       state,
       query
FROM pg_stat_activity
WHERE state = 'active'
ORDER BY duration DESC;MySQLはSHOW FULL PROCESSLIST、OracleはV$SESSION、SQL Serverはsys.dm_exec_requestsを使います。
現在実行中のSQLと待機状態を確認でき、長時間実行されている処理もすぐに見つけられます。
📌 こんな場面に有効! (APM/DPMなしで運用する小規模サービス担当者) 専用の監視ツールがなくても、この3つのビューだけで「いま何が起きているか」を把握できます。まずはセッションビューで現在実行中のクエリを確認し、落ち着いてから統計ビューで根本原因を洗い出す、という流れがおすすめです。
実行計画で原因を確認する
遅いクエリを見つけたら、なぜ遅いのかを見ていきます。ほとんどのデータベースが実行計画を提供しています。MySQLとPostgreSQLはEXPLAIN、実際の実行時間まで見るにはPostgreSQLのEXPLAIN ANALYZEを使います。OracleはEEXPLAIN PLANとDBMS_XPLAN、SQL Serverは実際の実行計画を表示させた状態でクエリを実行します。
たとえば、次のクエリが遅いと仮定してみます。
SELECT *
FROM orders
WHERE customer_id = 12345;
実行計画を確認します。
EXPLAIN
SELECT *
FROM orders
WHERE customer_id = 12345;
MySQLでは、次のような結果が出ることがあります。
table: orders
type: ALL
rows: 2500000ここでtype=ALLは、インデックスを使わずテーブル全体を読んでいるという意味です。取得結果は数件だけなのに数百万件を読んでいるなら、インデックスがないのか、あるいはインデックスを使えていないのかをまず確認します。
最初から実行計画のすべてを理解する必要はありません。フルテーブルスキャンをひとつ見つけるだけでも、多くの問題を検出できます。
開発環境では問題なかったクエリが、本番環境でだけ遅くなるケースもよくあります。本番はデータ量がはるかに多くフルスキャンのコストが大きくなること、オプティマイザが参照する統計情報が古くなっていること、WHERE DATE(created_at) = ...のようにカラムを関数で包んでインデックスを回避してしまうことがよくある原因です。本番データで実行計画を取り直し、統計情報が古ければ更新(ANALYZE、Oracleの場合はDBMS_STATS)から試してみます。
📌 こんな場面に有効! (新人バックエンドエンジニア) 実行計画を全部読み解こうとしなくて大丈夫です。まずはtype: ALL(フルテーブルスキャン)が出ていないかだけを確認する習慣をつけましょう。それだけでも多くの遅いクエリの原因にたどり着けます。
問題解決はインデックスとクエリから確認
原因が分かったら、もっとも単純な方法から適用します。
STEP 01. インデックス
WHERE、JOIN、ORDER BYでよく使われるカラムを中心にインデックスを検討します。
先ほどの例のクエリにインデックスを追加してみます。
インデックス作成
CREATE INDEX idx_customer_id
ON orders(customer_id);
インデックスを追加した後、もう一度実行計画を確認します。
type = ref
rows = 3
先ほどはインデックスを使わず約250万件を読んでいましたが、インデックス追加後はわずか3件しか読んでいないことが分かります。同じ結果を得るために読む必要のあるデータ量が、大幅に減ったということです。
実行計画で使われていないインデックスは、保存領域を占有し、書き込み処理のコストだけを増やすことがあります。そのため、インデックスを追加したあとは、実際に使われているかを実行計画で再度確認することが重要です。
STEP 02. クエリ
インデックスだけで解決しない場合は、クエリ自体を修正します。
- 繰り返し実行されるサブクエリをJOINに変更
SELECT *の代わりに必要なカラムだけを取得
STEP 03. アーキテクチャ
インデックスとクエリの改善でも解決しない場合は、構造的な対応を検討します。
- 読み取り専用レプリカの追加
- アプリケーションキャッシュの導入
- 集計結果の事前計算
ただし、この段階は運用の複雑度を高めるため、前の段階で解決できないかを先に確認することをおすすめします。
再び遅くならないために、スローログとしきい値の管理
一度問題を解決したら終わり、ではありません。スロークエリログを常に有効にしておけば、次に問題が発生したときすぐに原因を追跡できます。
本番環境では、slow_query_logまたはlog_min_duration_statementを常時有効にしておくケースが多く見られます。
しきい値は本番環境に合わせて調整します。
- 単発1秒で警告、3秒で危険を初期値として使用
- 同じSQLが10分以内に5回以上しきい値を超えたら重点的に確認
- 最初はやや高めに設定し、段階的に調整していく
また、スロークエリを修正するたびに原因と対応内容を簡単に記録しておくと、同じ問題が再発したときにずっと早く対応できます。
📌 こんな場面に有効! (シニアDBA/アーキテクト) しきい値の初期値やエスカレーション基準は、チームで一度言語化しておくと属人化を防げます。「単発1秒/3秒」「同一SQLが10分で5回」といった具体的な数字をNotionやRunbookに残しておくことをおすすめします。
おわりに
監視ツールがなくても、データベースの標準機能だけでスロークエリを見つけて分析できます。ログ、統計ビュー、セッションビューで問題を見つけ、実行計画で原因を確認したうえで、インデックスから順に沿って改善していくことが要点です。
一方で、システム規模が大きくなると、ログ分析や複数サーバーの比較には多くの時間がかかります。数千行のログを自分で分析し、複数のサーバーを比較しなければならないからです。監視ツールを使えば、特定の時間帯のスロークエリを素早く絞り込み、複数のデータベースの状態を1つの画面で確認でき、調査・分析・改善のサイクルを効率化できます。
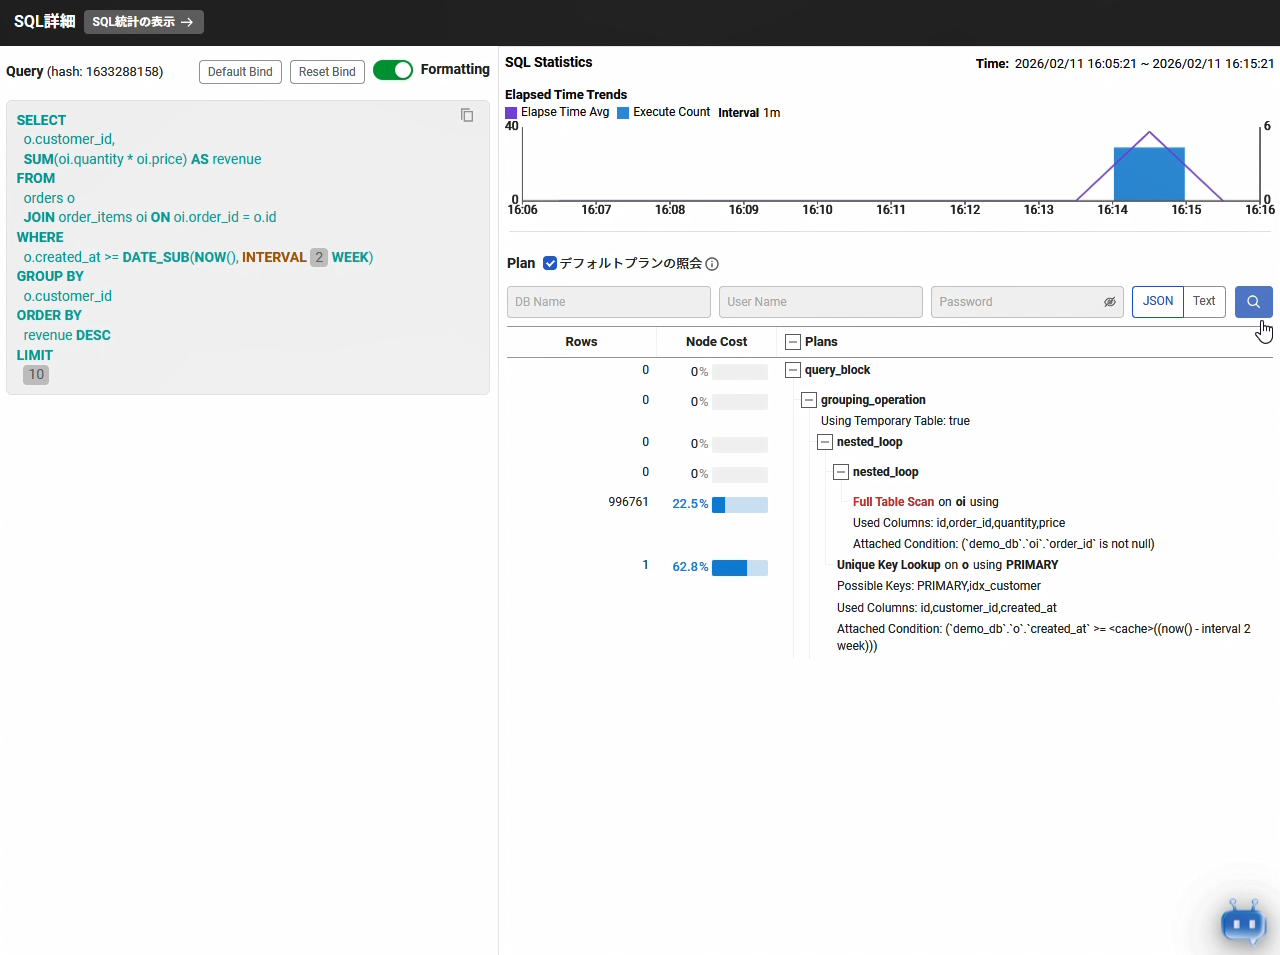
手作業によるログ分析を減らし、スロークエリの原因特定から改善までを効率化したい方は、WhaTapデータベース監視の15日間無料でお試しください。実行計画の分析とインデックスの改善提案をまとめてくれるAI分析も併せて提供しています。
WhaTap Database Monitoringでスロークエリ分析を効率化しませんか。
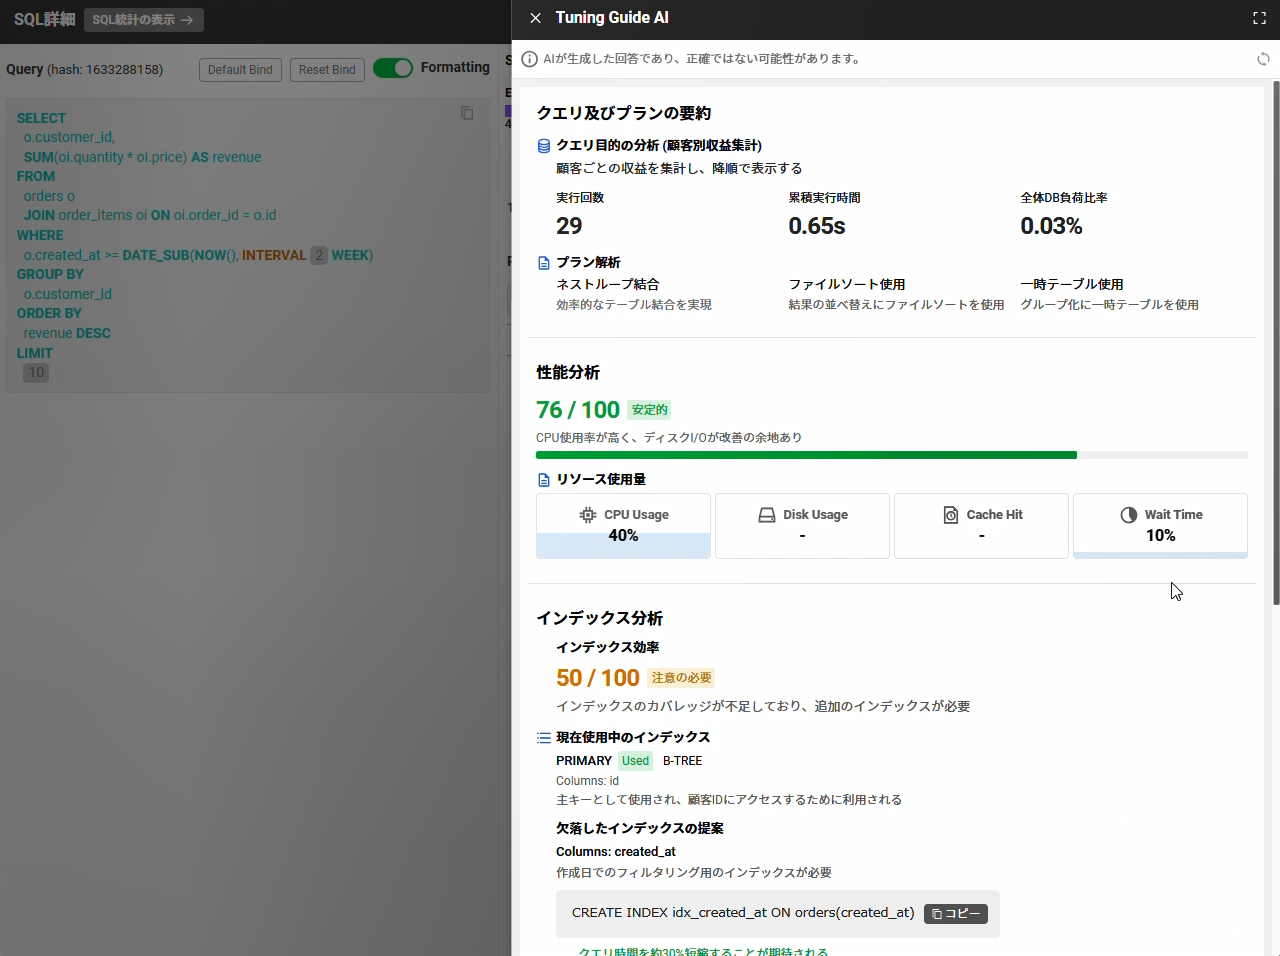
WhaTapを初めてご利用の方は、無料トライアルからお試しいただけます。
もっと詳しく
- MySQLモニタリングを始める(WhaTap公式ドキュメント)
- PostgreSQLモニタリングを始める(WhaTap公式ドキュメント)
- Use The Index, Luke(インデックスとSQL性能を扱う無料のオンライン教材・英語)