🎤
マジセミ x WhaTap 無料ウェビナー
|5月20日(水) 10:00
Top
問合せ
WhaTap Monitoringを体験してみましょう。
難しかったモニタリングと分析が容易に実現できます。
個人情報(eメール)収集に同意します。
個人情報保護方針
WhaTapスターターパック申し込み
申請書をご提出いただければ、登録されたメールに
担当者よりプロモーションコードをお送りいたします。
WhaTap Monitoringを体験してみましょう。
難しかったモニタリングと分析が容易に実現できます。
個人情報(eメール)収集に同意します。
個人情報保護方針
今すぐWhaTapを
体験してみてください。
WhaTap Monitoringを体験してみましょう。
難しかったモニタリングと分析が容易に実現できます。
個人情報(eメール)収集に同意します。
個人情報保護方針
今すぐWhaTapを
体験してみてください。
WhaTap Monitoringを体験してみましょう。
難しかったモニタリングと分析が容易に実現できます。
個人情報(eメール)収集に同意します。
個人情報保護方針
今すぐWhaTapを
体験してみてください。
WhaTap Monitoringを体験してみましょう。
難しかったモニタリングと分析が容易に実現できます。
個人情報(eメール)収集に同意します。
個人情報保護方針
今すぐWhaTapを
体験してみてください。
WhaTap Monitoringを体験してみましょう。
難しかったモニタリングと分析が容易に実現できます。
個人情報(eメール)収集に同意します。
個人情報保護方針
今すぐWhaTapを
体験してみてください。
WhaTap Monitoringを体験してみましょう。
難しかったモニタリングと分析が容易に実現できます。
個人情報(eメール)収集に同意します。
個人情報保護方針
今すぐWhaTapを
体験してみてください。
WhaTap Monitoringを体験してみましょう。
難しかったモニタリングと分析が容易に実現できます。
個人情報(eメール)収集に同意します。
個人情報保護方針
今すぐWhaTapを
体験してみてください。
WhaTap Monitoringを体験してみましょう。
難しかったモニタリングと分析が容易に実現できます。
個人情報(eメール)収集に同意します。
個人情報保護方針
今すぐWhaTapを
体験してみてください。
WhaTap Monitoringを体験してみましょう。
難しかったモニタリングと分析が容易に実現できます。
個人情報(eメール)収集に同意します。
個人情報保護方針
今すぐWhaTapを
体験してみてください。
WhaTap Monitoringを体験してみましょう。
難しかったモニタリングと分析が容易に実現できます。
個人情報(eメール)収集に同意します。
個人情報保護方針
ログイン
新規登録
公共機関向け
KO
KO
EN
JA
サービス
Application Monitoring
Server Monitoring
Database Monitoring
Kubernetes Monitering
Log Monitoring
URL Monitoring
Browser Monitoring
Network Performance Monitoring
GPU Monitoring
Network Monitoring(NMS)
OpenMetrics
AI Agent Observability
導入事例
インサイト
料金
会社紹介
WhaTap Japan
WhaTap Labs
ニュース
ドキュメント
サポート
お問い合わせ
Contact us
KO
KO
EN
JA
サインイン
無料で試す
公共機関向け
JA
KO
EN
JA
ホーム
サービス
AI Agent Observability
LLMサービスの運用状況を、ひと目で。
AI Agent Observability
ブラックボックス化して見えなかったLLMサービスの性能、コスト、
品質を、WhaTapがひとつの流れとして可視化と分析します。
お問い合わせ
なぜAI Agent Observabilityが必要なのか
LLMを活用したサービスは、APIが正常に稼働しているかの監視だけでは、運用状態を正しく判断できません。
LLM呼び出しの応答品質、レイテンシー、トークンコストまでをリアルタイムに把握。
マルチモデルのワークロードを効率的に管理することは、ビジネス上の重要な課題です。
予測しがたいトークンコスト
モデル、プロンプト長さ、応答サイズによって、1件あたりのコストは10倍以上も変わっていきます。エラーのリクエストにもトークンコストは発生します。
見えない品質リスク
正常応答(HTTP 200)の裏に潜むハルシネーションはブランド信頼の低下や事業損失に直結します。推定損失額(2024年)は$67.4Bに達するとされています。
平均値に隠れた性能劣化
平均応答時間は正常でも一部のユーザーだけが経験するp99のレイテンシーは見えません。呼び出し時のコンテキストが確保できず、再現すら難しいです。
マルチモデル、インフラ運用の複雑さ
LLMサービスは、複数のモデルやAPI、GPUインフラ、Kubernetes環境と組み合わせて運用されるケースが多々あります。これらのリソース状態をサイロ化して確認すると、原因特定が遅れがちです。
WhaTap AI Agent Observability
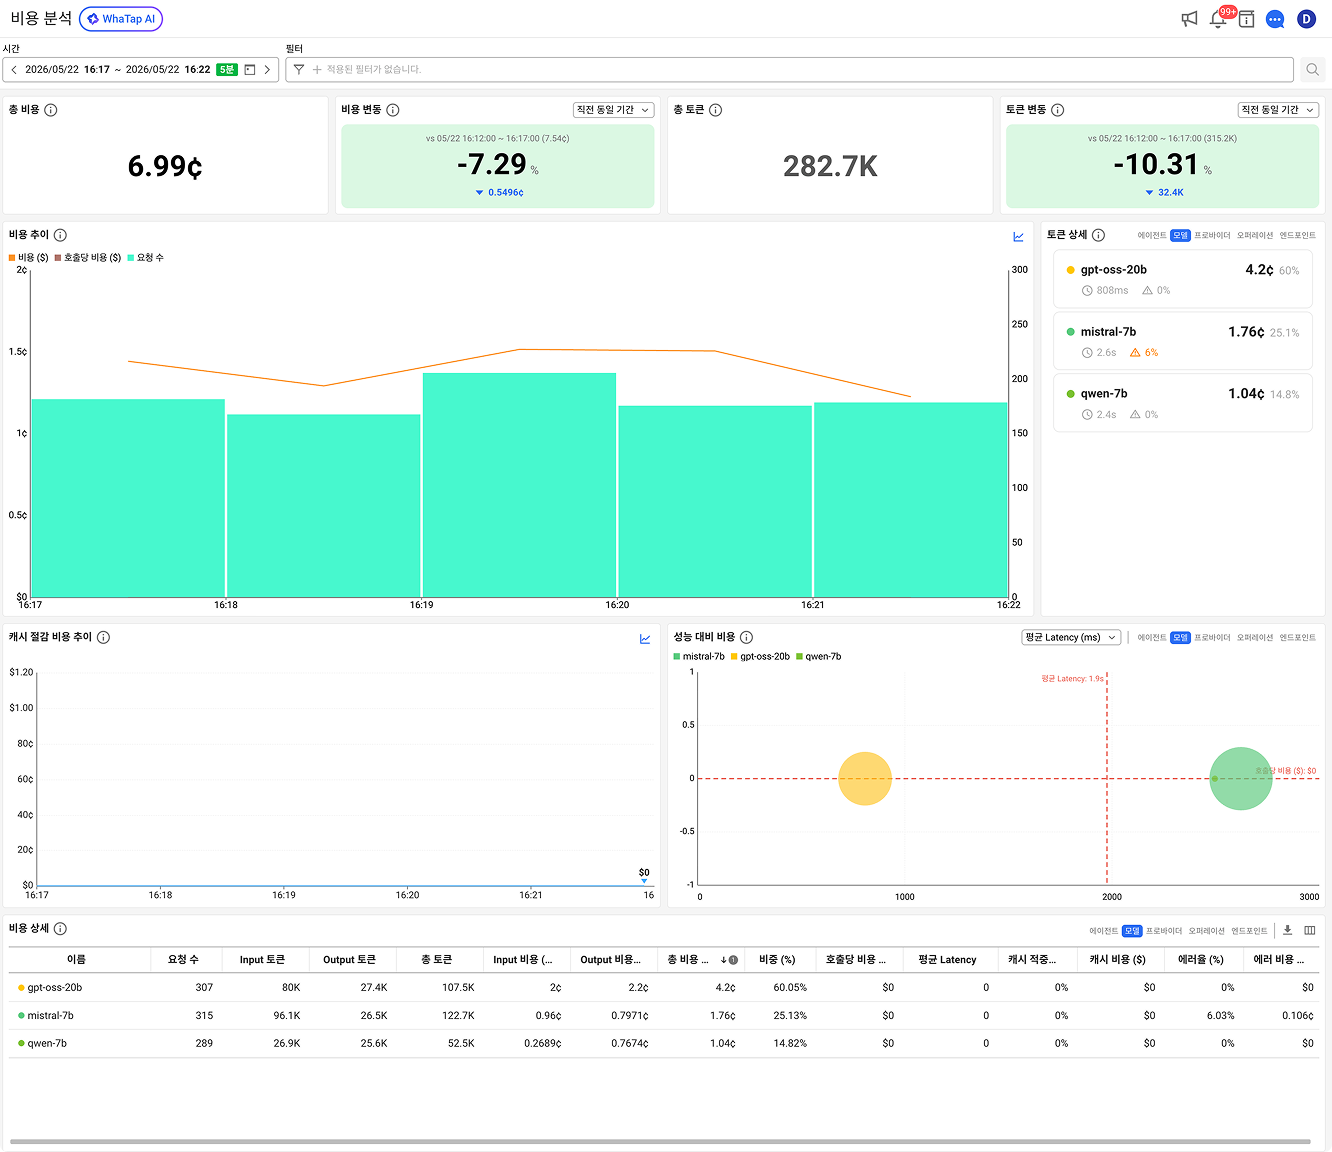
LLM API呼び出しのフロー、トークン使用量、モデル別の性能を単一のダッシュボードで可視化
トレース単位のドリルダウンにより、レイテンシー遅延箇所とコスト浪費箇所がひと目で把握できます。
WhaTap AI Agent Observabilityが選ばれる理由
WhaTapは、LLMアプリケーションからGPUインフラ、KubernetesのPod、そして呼び出しトレースまで、
全区間をEnd-to-Endで横断する統合インサイトを提供します。
呼び出しコンテキスト全体をひとつのトレースとして保存
システムメッセージ、プロンプト、ツール呼び出しまで、すべての入力を原本データのまま保存。障害発生時にもすぐに再現できます。
性能とコストを併せて見る運用視点
モデル別の応答速度、トークン使用量、エラー率、コストの流れを並べて比較。性能を重視するサービスにも、コスト効率を重視するサービスにも、最適な運用判断を支援します。
LLMとAIインフラ(GPU、K8s)の統合トレース
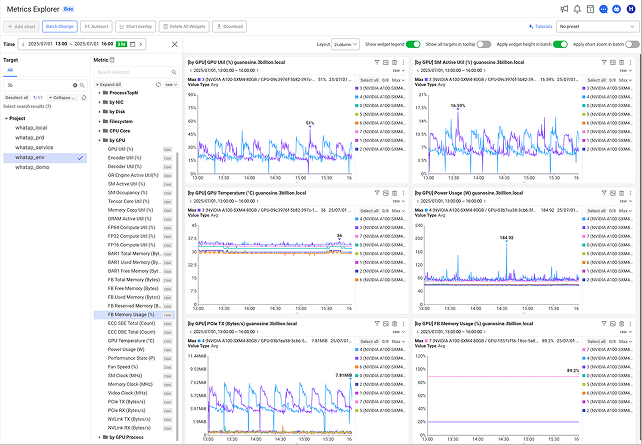
レイテンシ遅延の原因がLLM処理側にあるのか、GPUリソース側のボトルネックにあるのかを、単一の画面で切り分け。WhaTapが持つフルスタックのオブザーバビリティと結びついた、唯一無二のアプローチです。
主な機能
LLMサービス運用の可視性の確保からコスト最適化まで、効率的なAIサービス運用に欠かせない機能をひとつにまとめました。
LLM統合ダッシュボード
リアルタイムな状態 → リクエストと性能 → トークンとコスト → モデル間の比較という流れで、現状把握から詳細分析までを1ページで完結できます。アクティブトランザクションスピード、LLM呼び出しタイプ、ヒットマップにより、異常の兆候をすぐに把握できます。
LLM性能指標とモデル間比較分析
TTFT、TPOTをパーセンタイルで追跡し、平均値に隠れたレイテンシ遅延や性能ボトルネックを正確に特定します。モデル間の速度、コスト、エラー率を総合的に比較し、サービスの目的に合った最適なサービングエンジンやモデルを、データに基づいて選択と切り替えできるようにします。
トークン使用量とコスト分析
時間帯別の入力/出力トークン使用量、リクエスト当りの平均トークン数、日次の累計コストを追跡します。トークン使用量とコストを照らし合わせて非効率な呼び出し区間を特定。モデル間のコスト影響度からコスト最適化の優先順位が判断できます。
LLM APIトレース分析 + GPU連携
トレース単位で入力/出力メッセージ、トークン数、コスト、レイテンシ、ホストの位置を確認しながら、同時点のGPU使用量、VRAM、温度などのGPU状態を併せて分析します。レイテンシの原因がLLM側の処理にあるのか、GPUリソース側のボトルネックにあるのかを切り分けられる、唯一の統合分析環境を提供します。
応答品質とプロンプト分析
LLM応答に対する自動評価と性能、品質分析により、問題状況をすぐにモニタリング。プロンプトバージョンをコードのように体系的に管理、最適化できる、統合的な運用環境を提供します。
ログとイベントの統合アラート
しきい値ベースのイベント設定とSlack、Telegram、Teams、Pagerduty、Opsgenie、ilert、LINE、Webhookなど多様なチャネル連携により、コスト急増やエラー率上昇、レイテンシ遅延などをリアルタイムに検知し、対応できます。
今すぐ、LLMサービスの運用状況を可視化しましょう
WhaTapは、プロバイダー環境のLLMサービス、
ローカル環境のLLMサービスのどちらでもLLMワークロードを最適に運用できるようサポートします。
お問い合わせ
Top
問合せ