担当者よりプロモーションコードをお送りいたします。
体験してみてください。
体験してみてください。
体験してみてください。
体験してみてください。
体験してみてください。
体験してみてください。
体験してみてください。
体験してみてください。
体験してみてください。
LLMオブザーバビリティとは? その必要性
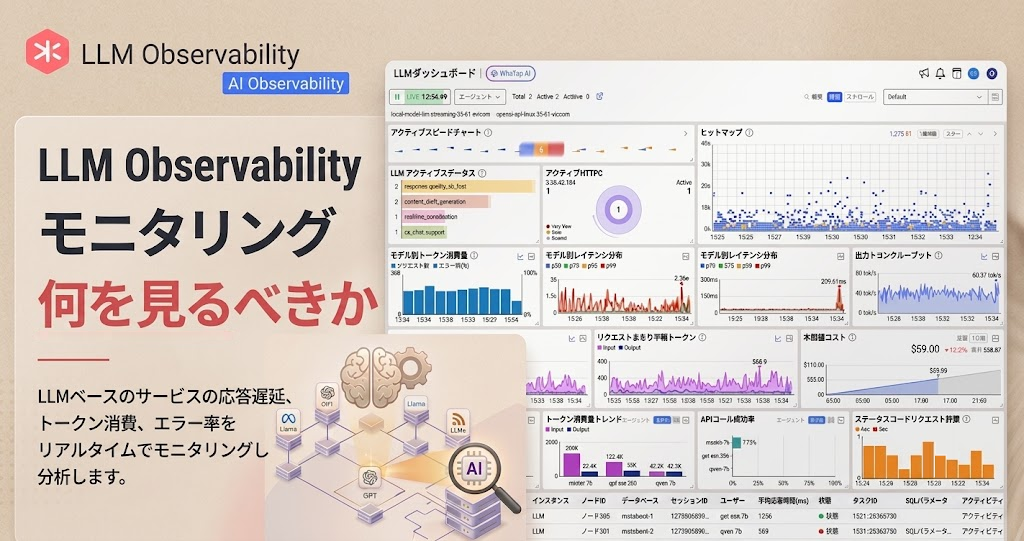
💡 LLMオブザーバビリティ(LLM Observability)とは、LLMを活用するアプリケーションのリクエストフロー・性能・コスト・品質をリアルタイムに可視化・監視する仕組みです。ハルシネーション、トークンコスト、AI Agentのデバッグまで、LLMオブザーバビリティが必要な理由と5つの観測対象を整理しました。
こんにちは。AIネイティブなオブザーバビリティプラットフォーム、WhaTap(ワタップ)です。
GPT、Claude、GeminiなどLLM APIひとつで顧客対応から文書要約、コードレビューまで自動化できる時代です。しかし、いざ本番環境に適用してみると、まったく違う種類の不安が始まります。
「この回答、本当に合っているのだろうか」
「今月のトークンコストがなぜこんなに増えたのか」
「昨日まで問題なく動いていたのに、なぜ急におかしな回答をするようになったのか」
既存のモニタリングツールだけでは、こうした質問に答えるのは困難です。もしこの不安に心当たりがあるなら、この記事が解消の糸口になるかもしれません。
LLMアプリケーションが 1)既存のソフトウェアとどう違うのか、2)何を観測すべきか、3)なぜフルスタックの統合観測が不可欠なのかを、順番に見ていきます。
LLMアプリケーション、既存ソフトウェアとの違い
| 区分 | 従来のアプリケーション | LLMアプリケーション |
|---|---|---|
| 出力方式 | 同じ入力 → 常に同じ出力(固定) | 同じ入力 → 毎回異なる出力(非固定) |
| 内部動作 | コードフローを追跡できる | モデル内部はブラックボックス |
| リソース単位 | CPU、メモリ、ディスク | トークン(→コストまたはGPU消費) |
LLMアプリケーションは、従来のアプリケーションとは異なります。その(核心的な)違いは3つに要約できます。
LLMは同じ質問でも回答が変わることがあり(非固定)、内部でどんな過程を経て回答を作ったのか追跡しにくく(ブラックボックス)、リソースをトークン単位で消費します。そのため、従来のアプリケーションで使っていた検証方式やコードレベルのデバッグ、CPU・メモリ中心のリソース管理方式を、そのまま適用するのは困難です。
この予測不可能なLLMアプリケーションの運用を管理するには、従来の方式とは全く違う新しい仕組みが必要になります。それがLLMオブザーバビリティです。
LLMオブザーバビリティとは
LLMオブザーバビリティ(LLM Observability)とは、LLMを活用するアプリケーションのリクエストフローと性能、コスト、品質を追跡・分析することを意味します。核心は、モデル自体を観測することではなく、モデルを使う全過程を観測することにあります。
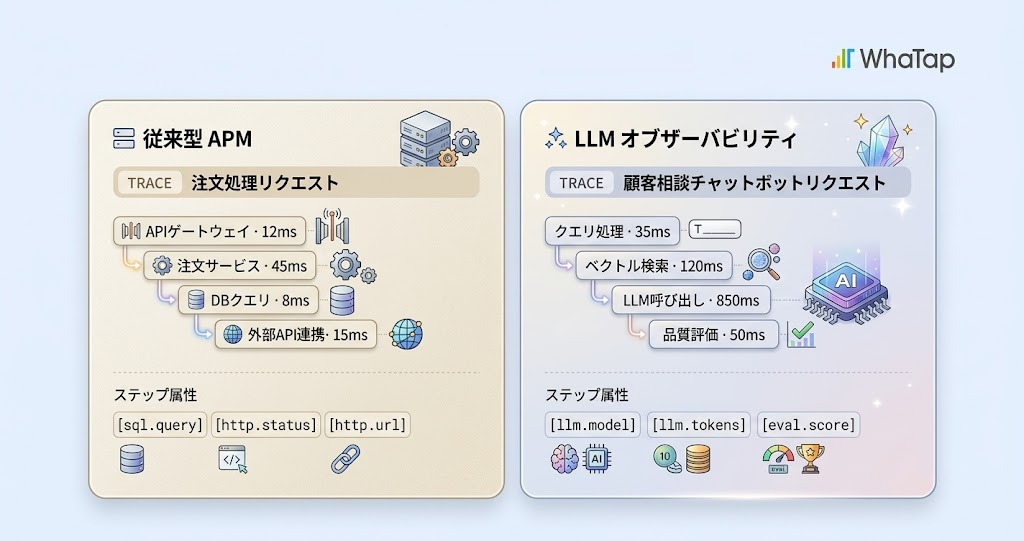
興味深いことに、LLMオブザーバビリティは従来のAPM(Application Performance Monitoring)と技術的に同様の構造を持ちます。従来のAPMがひとつのHTTPリクエストをトレースとしてまとめ、その中でDBクエリや外部API呼び出しをステップ(スパン)として記録するように、LLMオブザーバビリティもひとつのユーザーリクエストをトレースとしてまとめ、ベクトル検索、LLM API呼び出し、ツール実行をステップとして記録します。Trace-Metrics-Logsという基本構造も同じです。
違いはステップの中に記録される属性(Attribute)にあります。従来のAPMがカバーしきれないLLM固有の領域が存在するためです。
- 応答品質: HTTP 200を返しながら、完全に間違った回答をすることがあります。ハルシネーション(Hallucination)はステータスコードでは捕捉できません。
- トークンとコスト: プロンプトの長さ、モデル選択、キャッシュの有無によって、リクエストごとのコストが劇的に変わります。
- プロンプトとコンテキスト: LLMの挙動を決めるのはコードではなくプロンプトです。
- LLM固有のセキュリティ: プロンプトインジェクション、PII漏洩、システムプロンプトの露出は、SQL InjectionやXSSとは異なる次元の脅威です。
- GPU性能: 既存のアプリケーションでは収集していなかったGPU指標が重要になります。
構造は似ていても観測すべき属性が異なるなら、具体的に何をどう観測すればよいのでしょうか。
LLMオブザーバビリティの5つの観測対象
LLMアプリケーションは単純なAPI呼び出しではなく、複数のコンポーネントが有機的に結びついたシステムであるため、観測対象も多層的です。
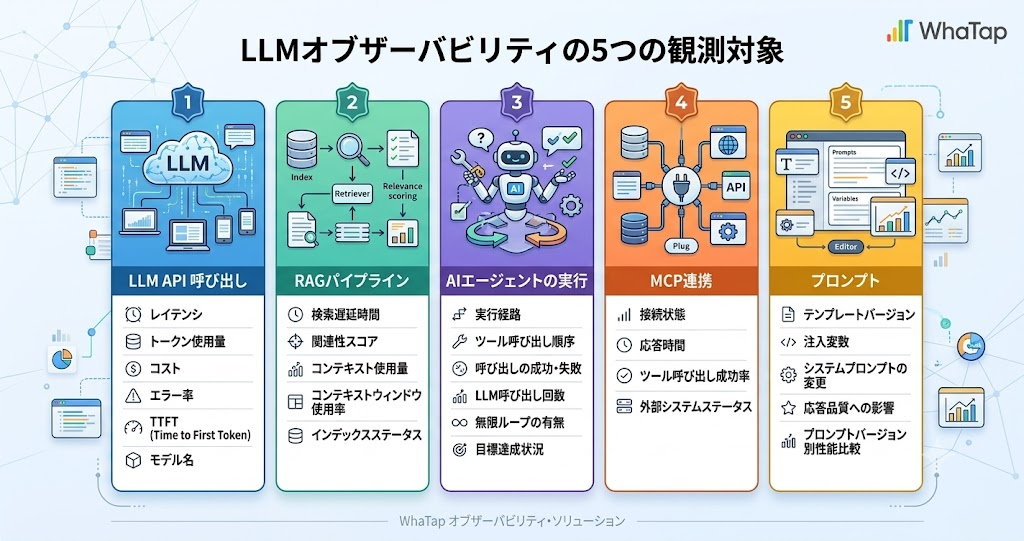
- LLM API呼び出し: レイテンシ、トークン使用量、コスト、エラー率、モデル名、TTFT(Time to First Token)などを追跡します。もっとも基本的な観測対象です。
- RAGパイプライン: インデックス化(チャンキング→埋め込み→ベクトルDB保存)とクエリ処理(質問→ベクトル検索→コンテキスト組み立て→LLM生成)の段階で構成されます。検索レイテンシ、関連度スコア、コンテキストウィンドウ使用率が主要な指標です。
- AIエージェント実行: 全体の実行ステップ、ツール呼び出しの順序と成功・失敗、LLM呼び出し回数、無限ループの発生有無、目標達成有無を追跡します。実行経路が毎回動的に決まるため、トレーシングなしではデバッグが事実上困難です。
- MCP連携: MCP(Model Context Protocol)で接続された外部システムの接続状態、応答時間、Tool呼び出し成功率を観測します。
- プロンプト: テンプレートのバージョン、注入変数、システムプロンプトの変更が応答品質に与える影響を追跡します。プロンプトバージョン別の性能比較も重要です。
では、LLMオブザーバビリティを導入すると、実際に何が変わるのでしょうか。
既存のツールだけでは対応が難しかった問題を、どう解決できるのでしょうか。その答えは、次の5つの核心的な価値に整理できます。
LLMオブザーバビリティがもたらす 5つのメリット
1. 全過程の追跡 : 性能ボトルネックを見つけます
「チャットボットの応答が遅い」という報告が入ったとき、既存のツールではサーバーのCPU使用率やネットワーク遅延程度しか確認できません。しかしLLMアプリケーションでのボトルネックの原因は、ベクトル検索かもしれませんし、LLM API自体かもしれませんし、Agentの不要な繰り返し実行かもしれません。
LLMオブザーバビリティは、ユーザーリクエストが入ってきた瞬間から応答が返る瞬間までの全過程をTrace単位で記録します。たとえば、クエリの前処理に35ms、ベクトル検索に120ms、LLM呼び出しに850msかかった、というように段階別の時間を確認できます。
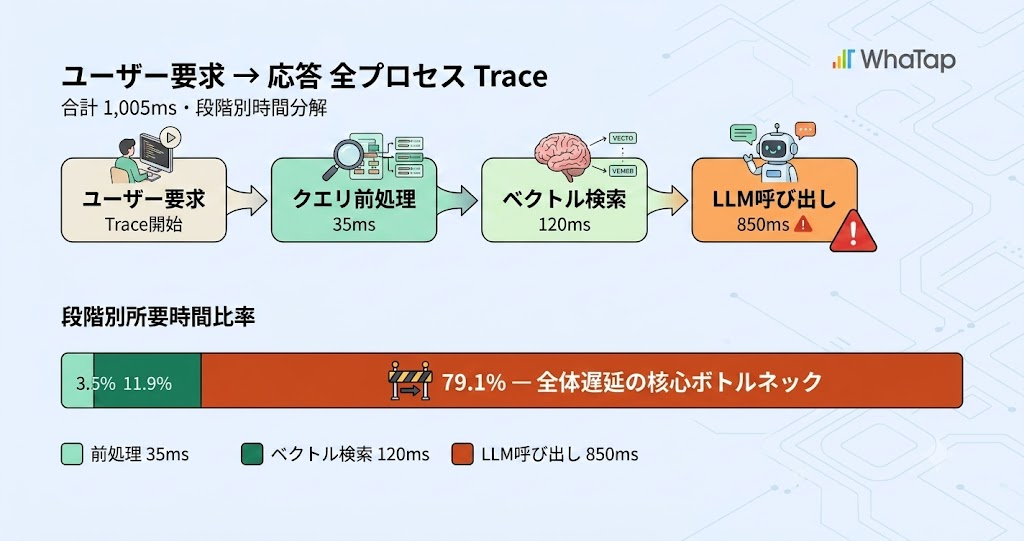
こうなると、「LLM呼び出しが全体レイテンシの79%を占めているので、プロンプトキャッシングを適用するか、より高速なモデルに切り替えよう」といった判断が可能になります。TTFT(Time to First Token)、ベクトル検索のレイテンシ、エージェントの反復回数といったLLM固有の性能指標も、ここに含まれます。
2. トークン・コストの可視化 :コストがどこで漏れているか見えます
LLMのコストは予測しづらいものです。プロンプトを少し変えるだけでトークン使用量が2倍に増えることもありますし、特定ユーザーの質問パターンによってAgentが同じ作業を10回以上繰り返し呼び出すケースも発生します。Provider API環境ではこれが請求金額として現れ、ローカルモデル環境ではGPUリソース消費につながります。
トークン・コストモニタリングは、すべてのLLM呼び出しの入力・出力トークンを、リクエスト単位・機能単位・モデル単位で追跡・集計します。たとえば「カスタマーサポート機能が全体コストの60%を占めており、そのうち半分は不必要に長いシステムプロンプトから発生している」というインサイトが得られてこそ、実際の最適化が可能になります。
3. 応答品質の評価 : ハルシネーションを顧客より先に発見します
LLMのもっとも危険な失敗は、静かに発生します。エラーログもなく、ステータスコードも200なのに、回答内容は完全に間違っている場合です。これは既存のモニタリング体系には存在しなかった、新しい観測領域です。
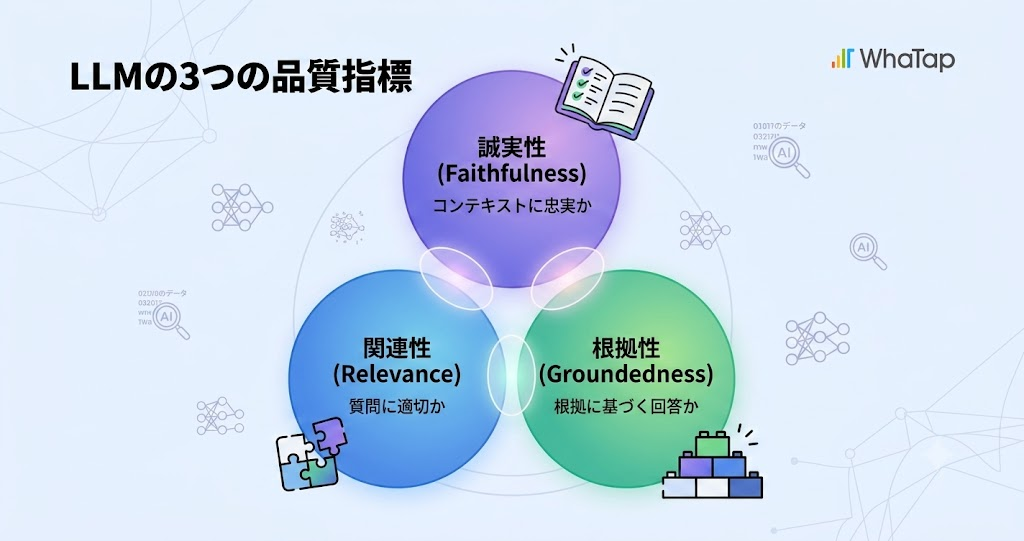
品質評価は、LLMの応答を自動で採点します。提供された文書やコンテキストをどれだけ忠実に反映しているか(Faithfulness)、質問に適切に答えているか(Relevance)、実際の根拠に基づいた回答か(Groundedness)といった指標を、リクエスト単位またはサンプリングベースで評価すれば、「今日の午後からFaithfulnessスコアが15%低下した」という兆候を即座に検知できます。
4. ガードレール : 出してはいけないものを止めます
プロンプトインジェクションによってシステムプロンプトが露出したり、ユーザーが入力した個人情報がLLM APIに渡ってしまったり、不適切な応答が顧客に露出したりする状況は、実際の運用環境で十分に起こり得ます。この領域では、エラー率やリトライ率だけでなく、ハルシネーション発生率、プロンプトインジェクションの試行、PII漏洩、有害コンテンツ生成といったLLM固有のセキュリティ脅威まで併せて観測する必要があります。
ガードレールは、LLMの入力と出力の両方で動作する安全装置です。重要なのは、ガードレール自体の動作状態も観測対象だという点です。フィルタリングされたリクエストの割合、脅威タイプ別の分布、False Positive(誤検知)率などを継続的に追跡してこそ、ガードレールの精度を改善できます。
5. フィードバックループ : 運用データが改善につながります
LLMアプリケーションはデプロイで終わりません。モデルは継続的にアップデートされ、ユーザーの質問パターンは変化し、データは時間とともに古くなっていきます。一度うまく動いたからといって、今後もずっとうまく動く保証はありません。
ユーザーフィードバック(いいね・よくない)、品質評価スコアの変化、コスト変動パターン、エラー発生頻度といったデータは、プロンプト改善・モデル入れ替え・RAGパイプラインのチューニングの根拠になります。たとえば「先週の品質低下の原因は検索の関連度低下だと判明 → リランキングモデルを追加 → Faithfulnessが12%上昇」というような改善サイクルが、勘ではなく実際の運用データに基づいて繰り返される必要があります。
以上が、LLMオブザーバビリティがもたらす主要な5つのメリットです。
観測対象の可視化から、性能・コスト・品質・セキュリティ・改善ループの構築まで、LLM運用においてなぜオブザーバビリティが不可欠なのか、イメージが湧きましたでしょうか。
ここまでの内容は主にクラウドのLLM APIを利用する一般的な構成を前提としていましたが、ローカルLLMを自社インフラで直接運用する環境においては、観測すべき範囲がはるかに広がります。
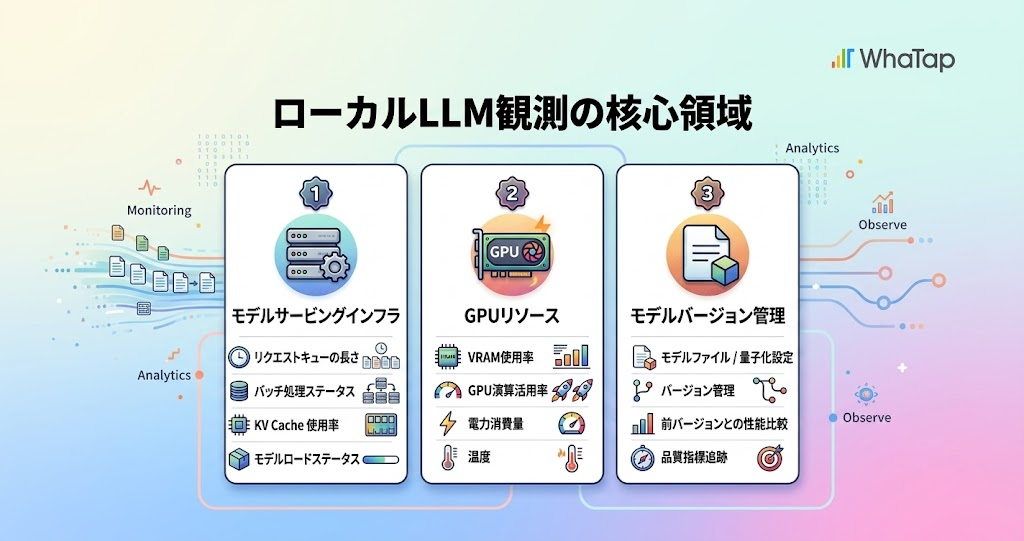
ローカルLLM : モデルサービングインフラ、GPUリソース、バージョン管理まで観測が必要です
Provider API(OpenAI、Claude、Geminiなど)を使う場合は、モデルサービングをProviderが代わりに処理してくれるため、アプリケーションレイヤー中心に観測すれば十分です。しかし、ローカル環境にモデルを直接デプロイする場合は、Providerが担っていた領域まで自前で運用する必要があるため、観測範囲も大きく広がります。
- モデルサービングインフラ — vLLM、TGI(Text Generation Inference)のようなサービングエンジンの状態自体が、LLMの性能に直接影響します。リクエストキューの長さ、バッチ処理の状態、KV Cacheの使用率、モデルのロード状態といった項目が、新しい観測対象に含まれます。
- GPUリソース — VRAM使用率、GPU演算使用率、消費電力、温度などは、応答速度と同時処理性能に直接的な影響を与えます。たとえば「午後3時からLLMの応答が遅くなった」という問題が発生した場合、VRAM不足でモデルが使うキャッシュが十分に活用できていないのか、別のワークロードがGPUリソースを占有しているのかまで確認する必要があります。
- モデルバージョン管理 — モデルファイル自体と量子化(Quantization)設定、以前のバージョンと比べた品質維持の有無まで直接追跡する必要があります。たとえば「INT4量子化を適用して速度は2倍速くなったが、Faithfulnessは8%低下した」といったトレードオフも、データに基づいて判断される必要があります。
ここまで見てくると、ローカルLLM環境では観測対象がインフラレベルまで拡張されることが分かります。しかし実際には、これはローカル環境だけの話ではありません。Provider APIを使う場合でも、LLM観測は結局フルスタックの視点の上でしか正しく機能しません。
LLMオブザーバビリティは、なぜフルスタック統合が必要か
Provider APIを使っていても、LLMアプリケーションは単独では動作しません。API Gatewayの後ろでトラフィックを処理し、Kubernetes Pod上で実行され、ベクトルDBと一般的なDBに接続され、MCPを通じて外部システムと通信します。障害はこれらのレイヤーをまたいで発生します。
LLMだけを見ていては、根本原因を見つけられません
「カスタマーサポートのチャットボットの応答が5秒以上に伸びた」というアラートが発生したと仮定してみます。LLM専用ツールだけでは「LLM呼び出しが遅い」というレベルまでしか確認できません。
しかし、実際の原因ははるかに多様です。ベクトルDBノードのディスクI/Oボトルネックかもしれませんし、Podのメモリ不足でOOM Killが繰り返されている状況かもしれませんし、API GatewayのRate Limitingの問題かもしれません。
逆のケースもあります。インフラ指標はすべて正常なのに、顧客の不満が増えている状況です。品質評価指標を確認してみると、Faithfulnessスコアが昨日から20%低下していました。原因はProvider側のモデルアップデートでした。こうした問題は、インフラモニタリングだけでは絶対に発見できません。
ひとつのTraceでつながる必要があります
ユーザーの1件のリクエストは、結局インフラ(サーバー、Kubernetes、GPU)→アプリケーション(APM)→LLM(RAG、Agent、品質評価)をすべて貫きます。この全体の流れがひとつのTraceでつながって初めて、「ベクトル検索が遅い原因はPodのメモリ不足のためだ」という判断が可能になります。
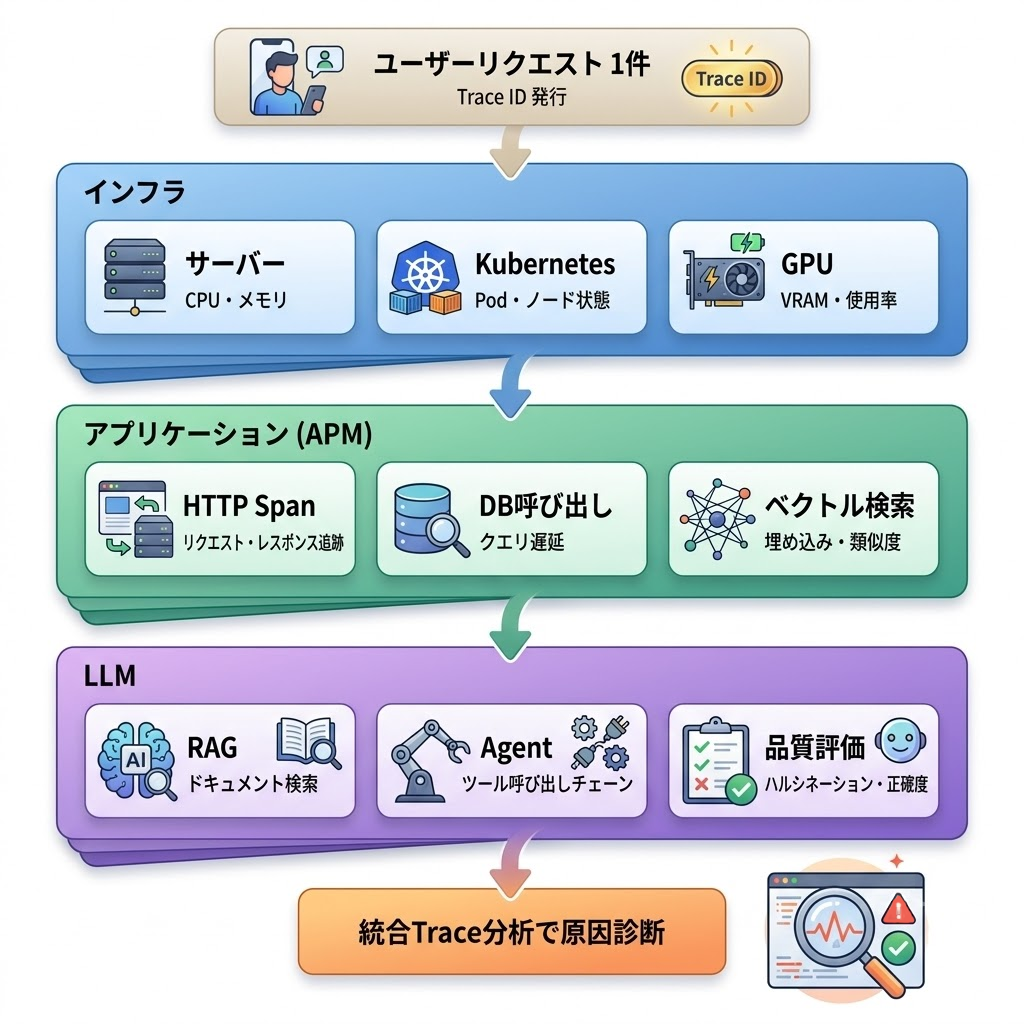
ツールがそれぞれ分離していると、運用担当者は3つ以上のダッシュボードを行き来しながら、頭の中で相関関係を推論しなければなりません。結局、障害対応の時間は長引かざるを得ません。一方、統合プラットフォームでは、「LLM呼び出し遅延→ベクトルDBクエリ遅延→Pod CPU Throttling→ノードリソース不足」まで、瞬時に1つの画面でドリルダウン方式で確認できます。
こうした流れは、特定の現場の実務者だけが体感している変化ではありません。業界全体もまた、同じ方向へ急速に動いています。
急成長するLLMオブザーバビリティ市場
LLMオブザーバビリティはまだ初期市場ですが、成長スピードは非常に速いです。
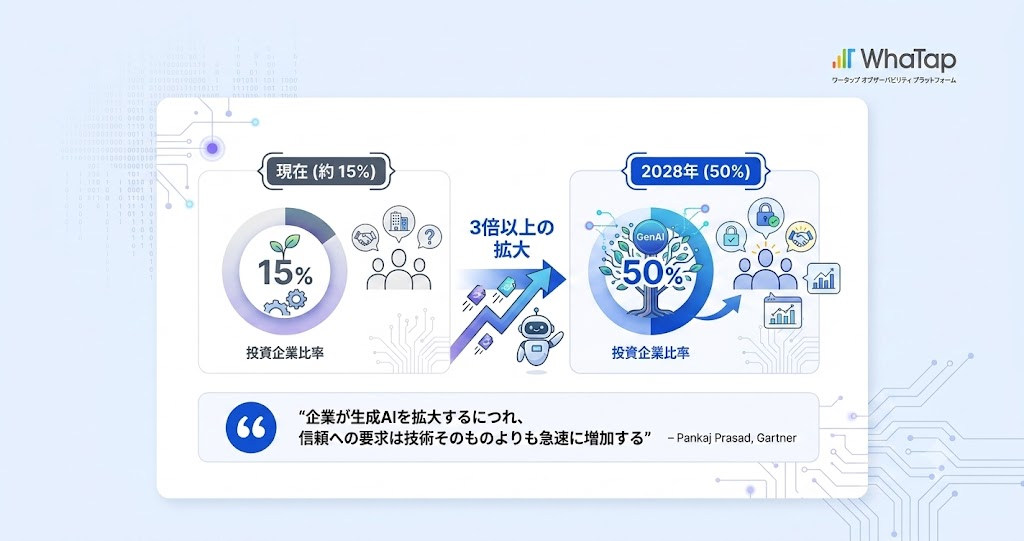
Gartnerは2026年3月、2028年までにGenAIを導入した企業の50%がLLMオブザーバビリティに投資すると予測しました。現在の比率が約15%水準であることを考えると、3倍以上に拡大する数値です。GartnerのPankaj Prasad氏は「企業がGenAIを拡張するほど、信頼への要求は技術自体より速く増大する」と説明しています。
既存のAPMの強豪各社も素早く動いています。Dynatraceは2025年1月にAI Observabilityを発表し、Datadogは2025年6月にAgent AIモニタリングとLLM実験機能を公開しました。また、Arize AIは2025年3月、LLMオブザーバビリティ専門企業Velvetを買収しました。
こうした成長を牽引する核心的な技術トレンドは、大きく2つあります。
1) OpenTelemetryの標準化 : データ収集方式が統一されつつあります
オブザーバビリティのデータ収集方式も急速に標準化されています。OpenTelemetry(OTel)はすでに分散トレーシングの事実上の標準として定着しており、ここにLLM関連のSemantic Conventionが追加されたことで、モデル名・トークン数・プロンプト・コストといったLLM属性まで標準化された方式で記録できるようになりつつあります。OTel v1.37からはgen_ai.request.model、gen_ai.usage.input_tokens、gen_ai.provider.nameといったGenAI専用の属性が正式スペックに含まれました。
この流れが重要な理由は、ベンダーロックインを減らせるからです。たとえばLangSmithはLangChain中心の環境に最適化されており、LlamaTraceはLlamaIndexベースの環境との連携性が高いです。一方OpenTelemetryベースでは、どのフレームワークを使っていても、どのモニタリングプラットフォームを使っていても、同じ方式でデータを収集・分析できます。市場の初期段階で標準が形成されつつあるということは、いま導入を始めても、のちに技術的負債につながる可能性が低いという意味でもあります。
2) AI Agentの拡散 :観測なしでは運用できない時代です
LLMオブザーバビリティの必要性をもっとも強く押し上げている流れは、AI Agentの拡散です。
初期のLLMアプリケーションは比較的シンプルでした。プロンプトを送り、応答を受け取る。それだけでした。ユーザーリクエスト1件あたりLLM呼び出し1回。観測すべき対象も多くありませんでした。
しかし、いまは違います。RAGを通じて文書を検索し、Agentが適切なToolを選んで実行し、その結果をもとに再び判断し、必要なら別のAgentに作業を委任します。MCPで外部システムと接続され、ガードレールを通じて入力と出力が検証されます。1件のユーザーリクエストが、内部的に数十回のLLM呼び出しとTool実行につながる構造です。
こうしたシステムで問題が発生すると——Agentが間違ったToolを選んだ、無限ループに陥った、コストが急増した——観測体系なしでは原因を見つけるのが困難です。Agentの実行経路は毎回動的に決まるため、ログだけでは「なぜこの動作が発生したのか」を再構成するのが困難です。全体の実行フローをTraceベースで記録していて初めて、実際のデバッグが可能になります。
AI Agentが広がるほど、LLMオブザーバビリティは「あれば良い機能」ではなく、「なければ運用が難しい必須要素」に変わりつつあります。
従来の方式とは全く違う新しい仕組みを導入すべきだという点は、もう明らかになりました。では、どこから、どう始めればよいのでしょうか。WhaTapなら、より簡単に始められます。
LLMオブザーバビリティの始まり、とWhaTap
この記事の核心メッセージはひとつです。LLMオブザーバビリティは完全に新しいカテゴリーではなく、既存のオブザーバビリティの自然な拡張だという点です。そして、この拡張は結局フルスタックの統合の上でしか正しく機能しません。
WhaTapは、この観点の上でLLMオブザーバビリティを作り上げています。
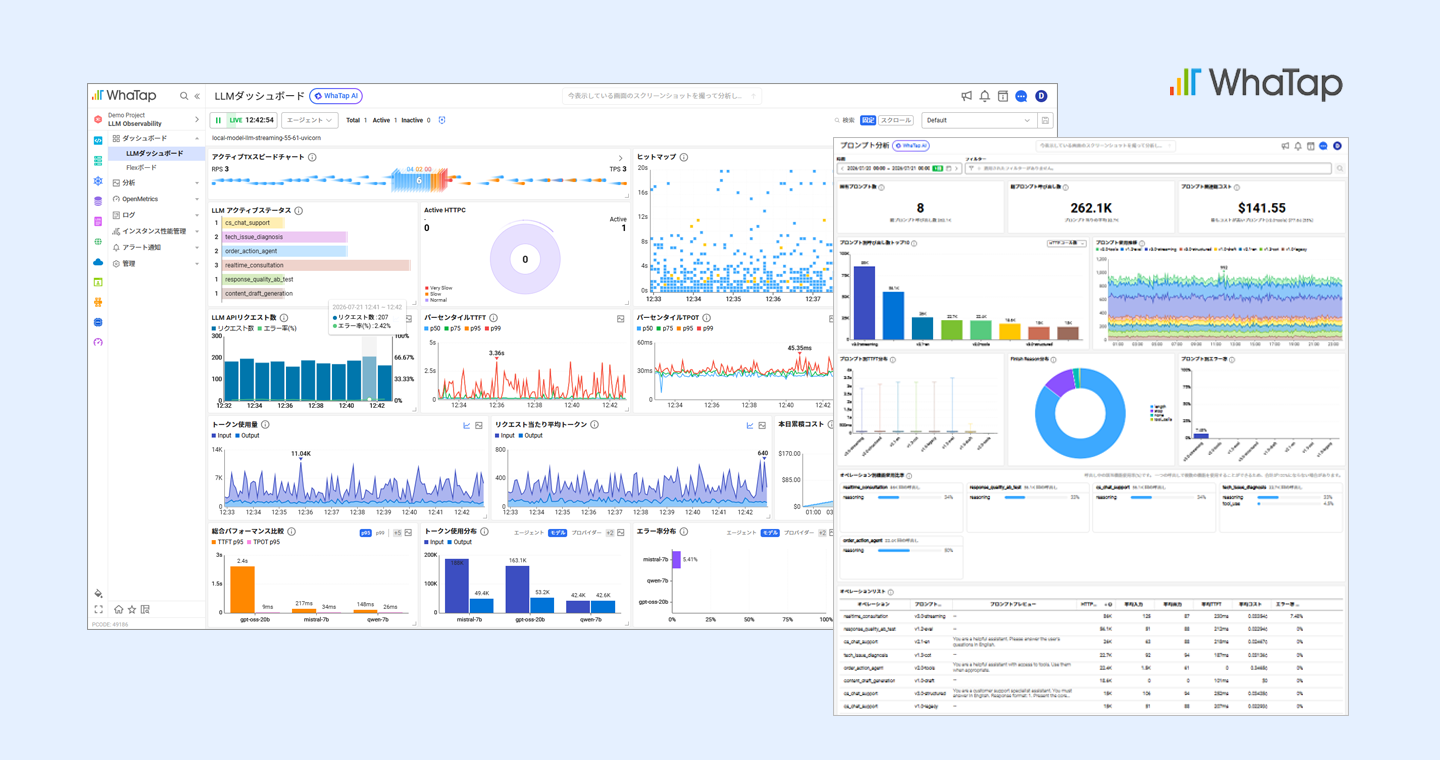
フルスタックの上にLLMを接続します。WhaTapはすでにAPM、Kubernetes、サーバー、データベース、GPUまで、1つのプラットフォームで統合モニタリングしています。LLMオブザーバビリティは、ここに自然に追加されるレイヤーです。LLM呼び出し遅延の原因を、LLMレイヤーから始めてAPM、Kubernetes、インフラ領域まで、1つの画面でドリルダウン方式で分析できます。別のツールを追加で接続する必要はありません。
既存のWhaTap環境からすぐ始められます。すでにWhaTapを利用しているなら、新しいツールを追加導入したり、別途学習コストをかけたりすることなく、LLM観測を始められます。同じダッシュボード、同じアラート体系、同じ運用チームが、LLM環境まで一緒にカバーできます。
WhaTapを初めてご利用の方は、無料トライアルからお試しいただけます。