담당자가 프로모션 코드를 발송해 드립니다.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
WhaTap AI를 경험해 보세요.
504 Gateway Timeout 원인과 해결 방법
504 Gateway Timeout이 떠서 프록시 타임아웃을 늘렸는데도 같은 상황이 반복된다면, 설정 값으로는 해결되지 않는 문제입니다.
504 Gateway Timeout은 Nginx나 로드 밸런서 같은 게이트웨이가 뒤에 있는 애플리케이션 서버(백엔드 서버)로부터 제한 시간 안에 응답을 받지 못했을 때 반환하는 HTTP 5xx 오류입니다.
원인은 크게 두 가지로 나뉩니다.
- 연결 실패: 게이트웨이가 애플리케이션 서버에 연결조차 하지 못한 경우
- 응답 지연: 연결은 됐으나 애플리케이션의 처리 시간이 너무 느린 경우
둘 중 어느 쪽인지 먼저 구분해야 Nginx 설정을 볼지, 애플리케이션 로직이나 데이터베이스를 확인할지 방향이 정해집니다.
504는 게이트웨이가 응답을 기다리다 연결을 끊은 신호다
504 Gateway Timeout은 프록시나 로드 밸런서 같은 게이트웨이가 애플리케이션 서버에 요청을 넘긴 뒤, 정해 둔 시간이 지나 게이트웨이가 먼저 연결을 끊은 상태입니다. 즉 게이트웨이가 고장 난 것이 아니라, 뒤에 있는 서버가 제때 답을 주지 못한 것입니다. 화면에 뜨는 문자열은 게이트웨이마다 다른데, Nginx는 하이픈을 넣어 504 Gateway Time-out으로 표기합니다.
비슷해 보이는 5xx 오류와 구분하면 원인의 방향이 잡힙니다.
5xx 상태 코드를 한 번에 확인하려면 HTTP 상태 코드 총정리, 1xx~5xx를 참고하면 됩니다.
응답이 늦은 것인지, 연결조차 맺지 못한 것인지 먼저 구분한다
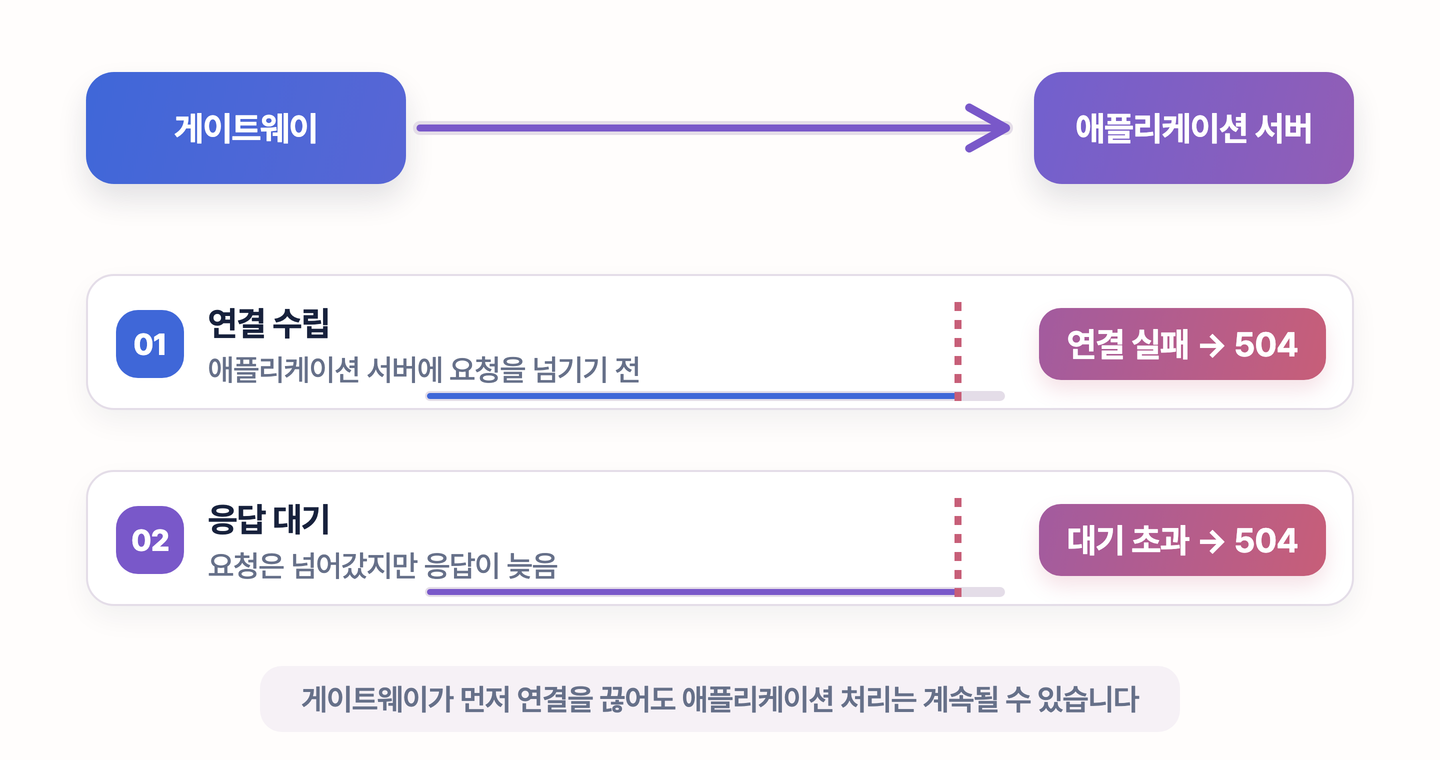
504가 모두 애플리케이션이 느려서 나는 것은 아닙니다. 게이트웨이가 애플리케이션 서버와 연결을 맺는 단계에서 시간이 초과돼도 504가 나옵니다. Nginx에서 연결 수립 구간을 담당하는 값이 proxy_connect_timeout입니다.
이 경우 요청은 애플리케이션에 넘어가지도 못했으므로, 애플리케이션 내부를 아무리 확인해도 느린 구간이 나오지 않습니다. 이때는 네트워크 경로와 보안 그룹·방화벽 규칙을 먼저 봐야 합니다. 서버 쪽에서는 프로세스가 떠 있는지, 연결 요청이 대기하는 accept 큐가 가득 찼는지, 헬스 체크가 실패했는지를 확인합니다.
게이트웨이 에러 로그 문구 하나로 두 경우를 구분할 수 있습니다.
연결 수립에 실패하면 error.log에 다음과 같은 줄이 남습니다.
2026/07/10 14:22:31 [error] 1180#0: *8421 upstream timed out (110: Connection timed out)
while connecting to upstream, client: 10.0.2.31, upstream: "http://10.0.5.12:8080/api/orders"while connecting to upstream이 찍혔다면 네트워크 경로부터 확인합니다. 애플리케이션 서버로 직접 연결을 시도해 보고, 보안 그룹과 방화벽이 게이트웨이 대역을 허용하는지, 애플리케이션 서버가 실제로 포트를 열고 있는지를 순서대로 확인합니다. 로그 문구를 건너뛰면 멀쩡한 코드부터 열어 보게 됩니다.
504 Gateway Timeout 주요 원인 4가지
에러 로그에 while reading response header from upstream이 찍혔다면, 그다음은 애플리케이션 서버가 왜 늦었는지 확인합니다. 게이트웨이 로그만으로는 내부 사정을 알 수 없으므로, 애플리케이션 안으로 들어가 어느 구간에서 시간이 걸렸는지 봐야 합니다. 자주 보이는 원인은 네 가지입니다.
애플리케이션 처리 지연. 스레드 풀 고갈이 대표적입니다. 요청을 받아 처리할 스레드가 모두 다른 작업에 묶여 있으면, 새 요청은 큐에서 순서를 기다리다 게이트웨이 타임아웃을 넘깁니다. 이때 CPU는 한가할 수 있어서 자원 여유만 보고 "서버는 멀쩡하다"고 오진하기 쉽습니다.
데이터베이스 쿼리와 커넥션 풀 지연. 느린 쿼리 하나에 요청 전체가 묶입니다. 인덱스를 타지 못하는 조회, 락을 기다리는 트랜잭션, 여유가 없는 커넥션 풀(미리 열어 두고 돌려쓰는 DB 연결이 모두 사용 중이라 대기하는 상황)이 흔한 원인입니다. 커넥션이 모자랄 때 무엇을 확인하는지는 Too many connections 원인과 해결 방법, 커넥션 풀부터 확인하세요에 정리돼 있습니다.
외부 API 호출 지연. 애플리케이션이 다시 호출하는 결제·인증 같은 외부 API가 느리면 그 대기 시간이 게이트웨이까지 그대로 이어집니다. 호출에 타임아웃을 걸어 두지 않으면 무한정 기다리게 됩니다.
네트워크와 서버 연결 실패. 게이트웨이가 애플리케이션 서버에 연결조차 맺지 못한 경우입니다. 이 경우에만 애플리케이션이 아니라 네트워크와 방화벽에서 원인을 찾습니다.
느린 구간을 특정하는 진단 순서 전체는 API 응답 지연 원인을 단계별로 확인하는 방법에 정리해 두었습니다. 부하가 오를 때만 504가 몰린다면 서버 CPU나 메모리가 포화된 상황이 겹친 것일 수 있으니 인프라 지표도 함께 봅니다. 같은 시간대에 CPU 사용률이 함께 튀었다면 리눅스 CPU 사용률이 높은 이유와 확인 방법에서 원인을 좁히는 순서를 다룹니다.
504 Gateway Timeout 해결 방법
원인은 여러 곳에 있지만 확인하는 순서는 정해져 있습니다. 장애 중에는 아래 순서대로만 짚어도 범위가 빠르게 좁혀집니다.
- 504를 반환한 게이트웨이를 확인합니다. CDN과 로드 밸런서, 프록시가 겹쳐 있으면 어느 계층이 만든 504인지부터 가려냅니다. 계층마다 타임아웃 값도 볼 곳도 다릅니다.
- 에러 로그에서 연결 실패인지 응답 지연인지 구분합니다. while connecting to upstream과 while reading response header from upstream 중 무엇이 찍혔느냐에 따라 이후 조사 범위가 달라집니다.
- 연결 실패라면 네트워크와 서버 상태를 확인합니다. 네트워크 경로, 보안 그룹과 방화벽 규칙, 애플리케이션의 포트 개방과 accept 큐, 헬스 체크 상태를 봅니다. 여기서 끝나면 애플리케이션 코드는 열어 볼 필요가 없습니다.
- 응답 지연이라면 느린 요청 하나를 추적합니다. 그 시각의 요청을 골라 애플리케이션 처리와 쿼리, 외부 호출 가운데 어느 구간이 길었는지 특정합니다.
- 같은 시간대의 포화 지표를 함께 봅니다. 요청량과 p95·p99 응답시간(전체 요청의 95%·99%가 이 시간 안에 들어오는 값), 활성 스레드, 대기 큐, 커넥션 풀 대기를 겹쳐 보면 요청 하나만 느린 것인지 전체 요청이 밀린 것인지 판단할 수 있습니다.
- 원인을 확인한 뒤에 타임아웃 값을 조정합니다. 얼마로 잡을지는 다음 절의 계층별 순서를 따릅니다.
504 타임아웃 값을 늘리기 전에 확인할 세 가지
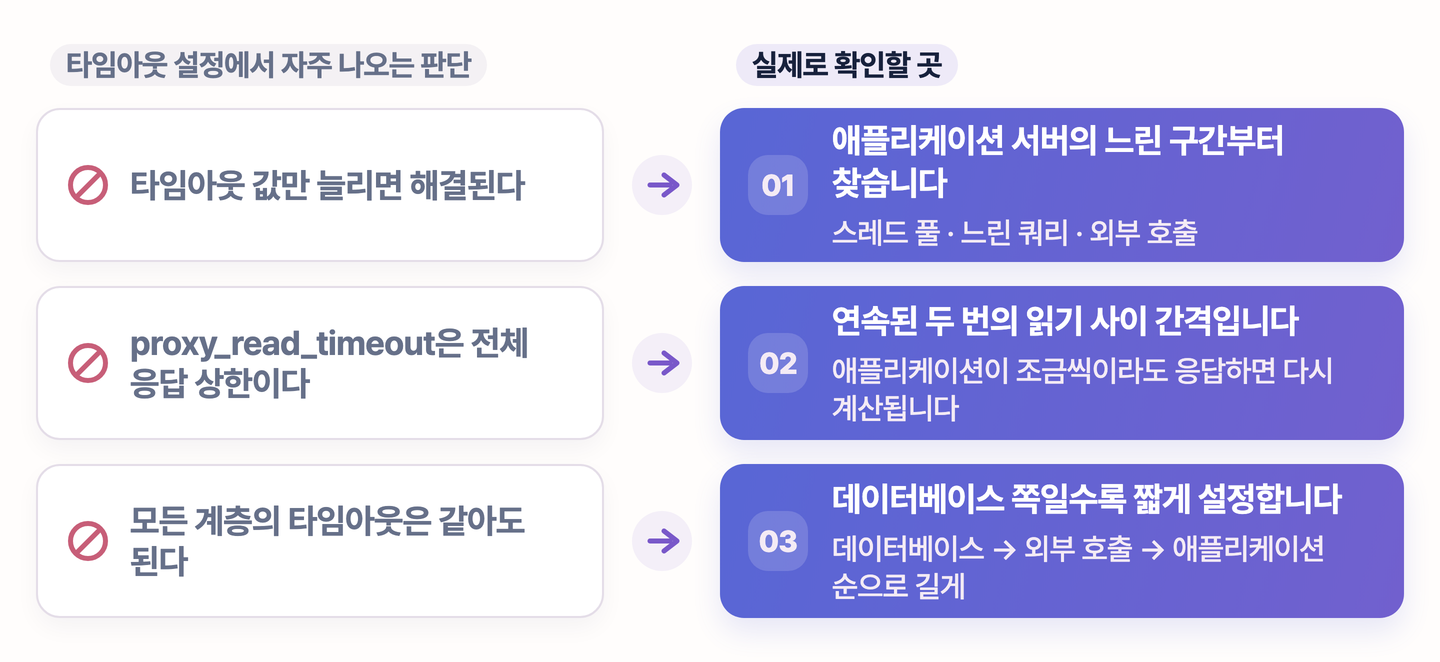
가장 흔한 오진은 504를 게이트웨이 설정 문제로만 보는 것입니다. 프록시의 응답 대기 시간을 늘리면 당장은 504가 줄지만, 애플리케이션이 여전히 느리므로 사용자는 오류 대신 긴 지연을 겪습니다. 겉으로 드러나는 형태만 바뀝니다.
더 나쁜 쪽도 있습니다. 게이트웨이가 먼저 연결을 끊더라도 애플리케이션에서 처리가 즉시 멈춘다는 보장은 없습니다. 이미 실패한 요청을 뒤에서 계속 처리하는 동안 사용자가 새로 재시도하고, 대기 시간을 길게 잡아 둔 상태에서 재시도가 겹치면 부하가 오히려 불어납니다.
proxy_read_timeout이 무엇을 측정하는 값인지도 자주 오해합니다. 이 값은 전체 응답 시간이 아니라 연속된 두 번의 읽기 사이 간격에 걸립니다. 애플리케이션이 조금씩이라도 데이터를 흘려보내면 총 소요 시간이 아무리 길어도 504는 나지 않습니다.
타임아웃 값을 계층별로 나눠 보지 않고 하나로 묶어 두는 경우도 있습니다. 게이트웨이의 응답 대기 시간, 애플리케이션의 외부 호출 타임아웃, 데이터베이스 쿼리 타임아웃은 서로 다른 값입니다. 세 값의 순서가 맞지 않으면 데이터베이스가 아직 응답을 기다리는 중인데 게이트웨이가 먼저 연결을 끊어 504가 납니다.
값을 맞출 때는 데이터베이스 쿼리를 가장 짧게 두고 외부 API 호출, 애플리케이션 요청, 게이트웨이 순으로 길게 잡습니다. 데이터베이스 쪽이 먼저 실패를 확인하고 자원을 정리한 뒤에 게이트웨이가 끝내도록 시간을 나누는 것입니다.
자주 묻는 질문
504 Gateway Timeout과 502 Bad Gateway는 어떻게 다른가요?
502는 백엔드 서버가 잘못된 응답을 돌려주거나 연결이 갑자기 끊긴 경우이고, 504는 백엔드 서버가 살아 있으나 정해진 시간 안에 응답하지 못한 경우입니다. 502는 "서버가 깨졌다", 504는 "서버가 느리다"로 나눠 생각하면 쉽습니다. Nginx라면 error.log 문구로 확인하는 편이 빠릅니다. recv() failed나 upstream prematurely closed connection은 502 쪽이고, upstream timed out은 504입니다.
Nginx 타임아웃을 늘렸는데도 504가 계속 납니다. 왜 그런가요?
늘린 값이 실제로 걸린 구간의 값이 아닐 수 있습니다. 앞단에 CDN이나 로드 밸런서가 있으면 504를 반환한 계층이 Nginx가 아닐 수 있고, Nginx라 해도 연결 수립에서 끊겼는데 proxy_read_timeout만 올렸다면 연결 수립 제한 시간은 손대지 않은 채라 같은 지점에서 다시 끊깁니다. 어느 계층의 어느 값이 걸렸는지부터 확인하고, 계층이 맞는데도 반복된다면 애플리케이션 스레드 풀과 느린 쿼리, 외부 호출 지연 가운데 어디서 시간이 걸리는지 봅니다.
Nginx에서 504 Gateway Timeout이 발생하면 무엇을 확인해야 하나요?
error.log부터 엽니다. 로그에 아무것도 안 남았다면 세 가지를 확인합니다. error_log 지시자가 가리키는 경로가 실제로 보고 있는 파일과 같은지, 로그 레벨이 error 단계까지 기록되도록 잡혀 있는지, 그리고 504를 반환한 계층이 Nginx가 맞는지입니다. 앞단 로드 밸런서가 먼저 끊었다면 Nginx error.log에는 흔적이 남지 않습니다.
504 Gateway Timeout은 서버 문제인가요?
대개 서버 쪽 문제입니다. 사용자가 브라우저를 바꾸거나 새로고침해도 해결되지 않고, 같은 시각 다른 사용자에게도 함께 나타나는 것이 그 신호입니다. 반대로 특정 사용자나 특정 회선에서만 난다면 중간 프록시나 사내 방화벽을 먼저 의심합니다.
504가 특정 시간대에만 몰려서 납니다. 왜 그런가요?
부하가 오르는 시간대에 자원이 포화되는 신호일 수 있습니다. 트래픽이 몰릴 때 스레드 풀이나 커넥션 풀이 먼저 동나는지, CPU와 메모리가 포화되는지를 그 시간대의 메트릭으로 확인하면 원인을 좁힐 수 있습니다.
이때 평균 응답시간만 보면 놓치기 쉽습니다. 504는 일부 느린 요청이 타임아웃 경계를 넘으면서 나는 경우가 많습니다. 대기 큐 길이와 커넥션 풀 대기 시간을 같이 봐야 합니다.
마치며
504 Gateway Timeout을 만났을 때 타임아웃 값부터 늘리는 것은 문제를 미루는 일입니다. 순서는 두 단계입니다. 먼저 에러 로그로 응답을 기다리다 연결을 끊은 것인지, 연결조차 맺지 못한 것인지를 구분합니다. 연결 수립 실패라면 네트워크 경로와 보안 그룹을, 응답 대기라면 게이트웨이 뒤 애플리케이션과 데이터베이스, 외부 호출 가운데 어느 구간에서 시간이 걸렸는지를 특정합니다. 구간이 잡히면 그다음은 그 구간의 처리 능력을 손보는 단계입니다.
504가 난 뒤에 서버 상태만 확인하면, 당시 어떤 요청의 어느 구간이 느렸는지는 이미 지나간 뒤일 수 있습니다. 발생 시점의 요청을 트랜잭션 단위로 남겨 두면 애플리케이션 처리와 쿼리, 외부 호출 가운데 어디에서 시간이 걸렸는지 역추적할 수 있습니다. 와탭 APM은 게이트웨이 뒤에서 처리된 요청 하나를 그 구간들로 펼쳐 보여 줍니다. 트랜잭션을 구간별로 분석하는 방법은 Java 애플리케이션 모니터링 소개 (와탭 공식 문서)에서 확인할 수 있습니다.
더 읽을거리