담당자가 프로모션 코드를 발송해 드립니다.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
WhaTap AI를 경험해 보세요.
RTO와 RPO란? 뜻과 차이, 재해복구(DR) 전략까지
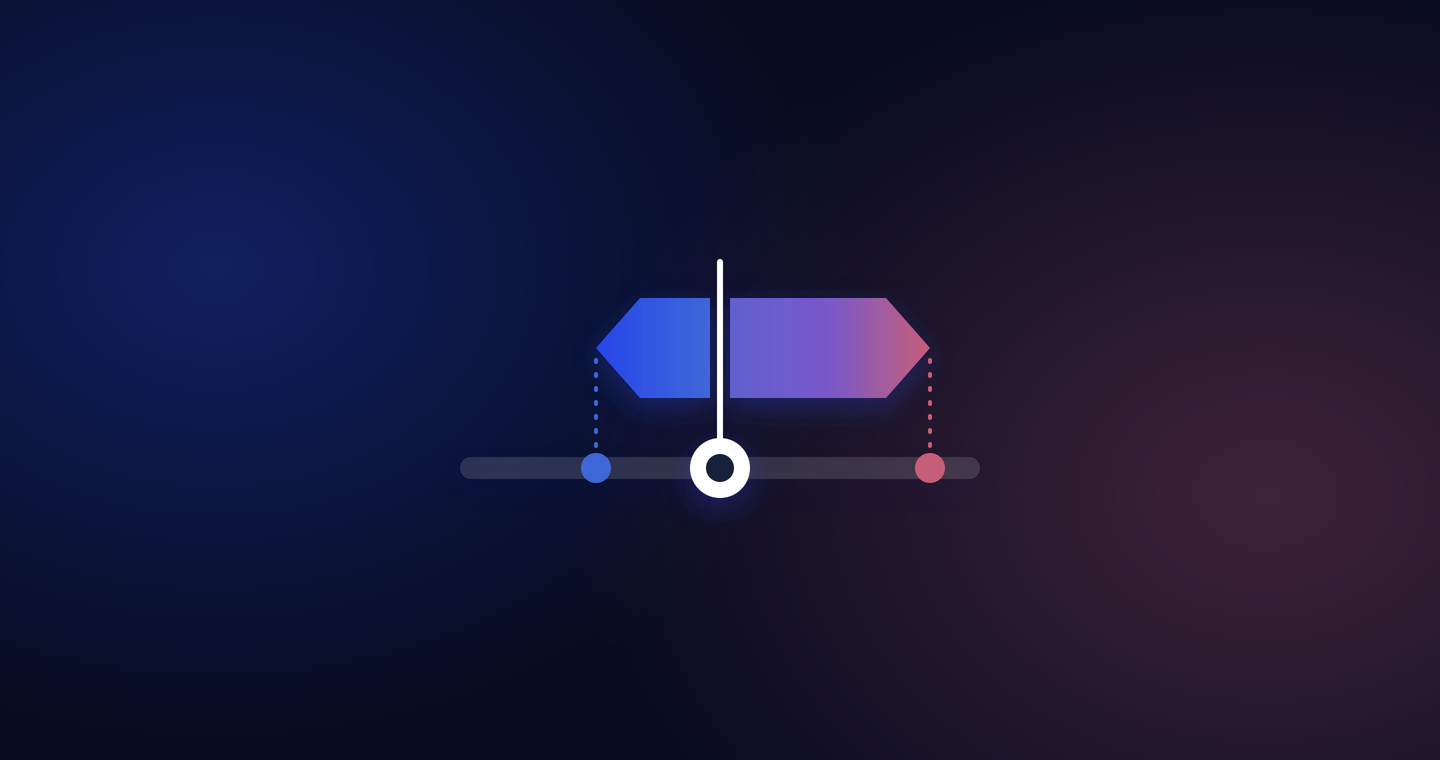
서비스를 운영하다 보면 재해복구 계획서나 클라우드 이중화 설계서에 "RTO 4시간, RPO 1시간" 같은 숫자를 채워 넣어야 할 때가 있습니다. 칸은 두 개인데 이름이 비슷하고 단위도 똑같이 시간이라, 어느 칸에 무엇을 넣어야 하는지부터 헷갈리기 쉽습니다.
숫자를 넣은 뒤에도 질문이 이어집니다. RTO와 RPO 값은 누가 어떤 근거로 정하는지, 지금 쓰는 백업 방식으로 그 값을 지킬 수 있는지, 지키지 못한다면 무엇을 바꿔야 하는지입니다. RTO와 RPO의 뜻을 먼저 구분하고, 값을 정하는 순서와 재해복구 전략의 관계까지 차례로 정리했습니다.
RTO(Recovery Time Objective, 복구 목표 시간)는 장애가 난 뒤 서비스를 다시 돌려놓기까지 허용하는 최대 시간이고, RPO(Recovery Point Objective, 복구 목표 시점)는 복구했을 때 잃어도 되는 데이터의 최대 범위를 시간으로 나타낸 값입니다.
RTO와 RPO 뜻과 차이
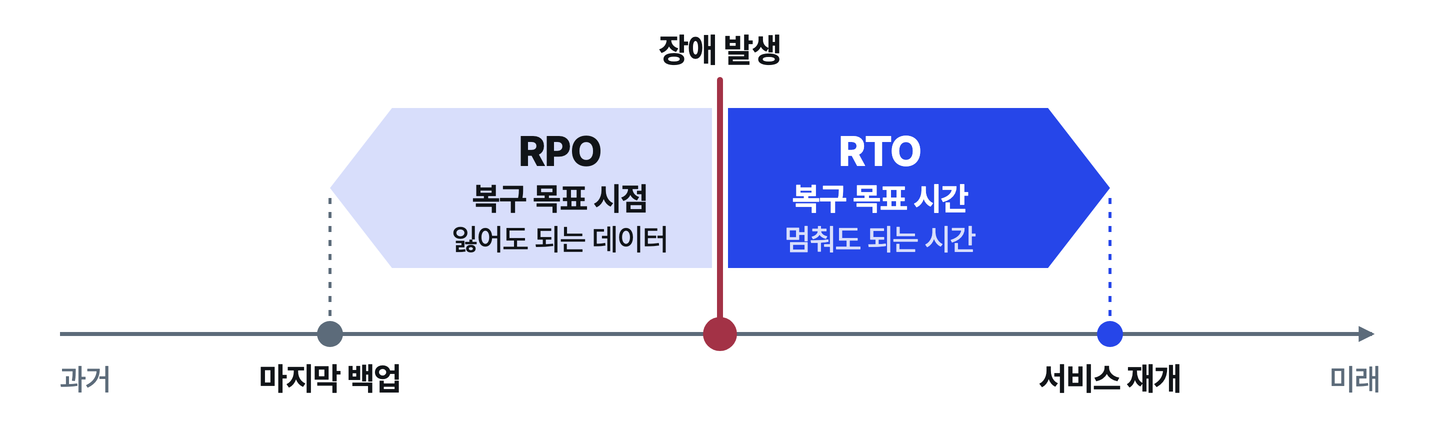
RTO와 RPO는 재해복구(DR, Disaster Recovery)와 비즈니스 연속성 계획에서 가장 먼저 정하는 두 가지 목표입니다. 재해복구는 화재나 대규모 정전, 데이터 손상처럼 평소 운영 환경을 그대로 쓸 수 없는 사고가 난 뒤 시스템과 데이터를 되살리는 계획과 절차를 말합니다.
RTO(복구 목표 시간)란
미국 국립표준기술연구소(NIST)의 정보시스템 비상 계획 가이드 SP 800-34 Rev. 1은 RTO를 시스템 자원이 사용할 수 없는 상태로 머물러도 되는 최대 시간으로 설명합니다. 이 시간을 넘기면 연결된 다른 시스템과 그 시스템이 지원하는 업무에 받아들일 수 없는 영향이 생긴다고 봅니다.
예를 들어 RTO가 4시간인 주문 시스템이 오전 9시에 멈췄다면, 오후 1시 전까지는 주문을 다시 받을 수 있어야 합니다. RTO는 장애가 난 순간부터 이후로 흘러가는 시간을 측정합니다.
RPO(복구 목표 시점)란
같은 NIST 가이드는 RPO를 장애 이전의 어느 시점까지 업무 데이터를 되살릴 수 있는지를 나타내는 값으로 정의합니다. 기준은 가장 최근에 받아 둔 백업본입니다. 가이드는 RPO가 복구 과정에서 업무가 견딜 수 있는 데이터 손실량을 뜻한다고 덧붙입니다.
RPO가 1시간이라면 장애 직전 1시간 안에 쌓인 데이터까지는 잃어도 된다는 뜻입니다. RPO 1시간을 목표로 한다면 복구할 수 있는 데이터 지점 사이가 1시간보다 벌어지지 않도록 백업이나 복제 주기를 설계해야 합니다. RTO와 달리 RPO는 장애 시점에서 과거 쪽으로 거슬러 올라가며 측정합니다.
RTO와 RPO 차이 한눈에 보기
| 구분 | RTO | RPO |
|---|---|---|
| 한글 이름 | 복구 목표 시간 | 복구 목표 시점 |
| 의미 | 멈춰도 되는 최대 시간 | 잃어도 되는 데이터의 최대 범위 |
| 측정 방향 | 장애 시점부터 이후로 | 장애 시점부터 이전으로 |
| 값을 좌우하는 것 | 복구 절차, 대기 환경, 자동화 수준 | 백업 주기, 복제 방식 |
| 예시 값 | 4시간 안에 서비스 재개 | 최근 1시간 데이터까지 손실 허용 |
| 목표를 0에 가깝게 두는 구성 | 늘 켜져 있는 대기 환경 | 실시간에 가까운 데이터 복제 |
RTO와 RPO는 목표를 따로 정하는 값입니다. 매일 밤 전체 백업만 받는 시스템도 복원 절차가 빠르면 RTO는 짧을 수 있습니다. 대신 그날 낮에 쌓인 데이터는 모두 잃으므로 RPO는 하루에 가깝습니다. 다만 구현할 때는 실시간 복제처럼 두 값을 함께 줄이는 기술이 많아서, 실제로는 두 값이 함께 짧아지는 경우가 많습니다.
RTO와 RPO 설정 방법과 계산 예시
RTO와 RPO 값은 서버 사양에서 출발하지 않습니다. 업무가 얼마나 멈추면 감당할 수 없는지에서 출발합니다. NIST 가이드는 비상 계획 담당자가 업무 담당자, 경영진과 함께 업무 영향 분석(BIA, Business Impact Analysis)을 하며 허용할 수 있는 중단 시간을 정하도록 안내합니다. 순서는 다음과 같습니다.
- 최대 허용 중단 시간(MTD) 정하기: MTD(Maximum Tolerable Downtime)는 시스템 소유자가 업무 중단을 받아들일 수 있는 전체 시간입니다. 매출 손실, 고객 이탈, 법적 의무 같은 모든 영향을 따져 정합니다.
- MTD 안에서 RTO 잡기: NIST 가이드는 RTO가 MTD를 넘지 않아야 하므로 보통 MTD보다 짧아야 한다고 설명합니다. 복구한 뒤 밀린 데이터를 다시 처리하는 시간도 MTD 안에 들어가야 하기 때문입니다.
- 잃어도 되는 데이터로 RPO 잡기: 가이드는 RPO를 MTD의 일부로 보지 않습니다. 복구하는 동안 업무가 견딜 수 있는 데이터 손실이 얼마인지를 따로 묻습니다.
- 복구 비용과 맞춰 보기: 가이드는 RTO가 짧을수록 복구 방식을 갖추는 비용이 커진다고 설명합니다. 중단이 길어질수록 커지는 손실과 복구 설비 비용이 만나는 지점을 찾아 값을 정합니다.
계산 예시, 온라인 쇼핑몰 주문 시스템
업무 담당자가 "주문 접수가 4시간 넘게 멈추면 손실을 감당할 수 없다"고 판단했다고 가정해 보겠습니다. 이 쇼핑몰의 MTD는 4시간이 됩니다. 복구 뒤 밀린 결제를 대사하고 주문을 재처리하는 데 1시간이 걸린다면, RTO는 3시간 이하로 잡아야 MTD 안에 들어옵니다.
RPO는 데이터를 잃었을 때 벌어지는 일에서 정합니다. 결제가 끝난 주문을 복원하지 못하면 고객에게 일일이 연락해 다시 주문을 받아야 합니다. 재주문을 받는 부담을 15분 분량까지만 지기로 했다면 RPO는 15분입니다.
지금 매일 새벽 2시에 전체 백업만 받고 있다면, 오후 5시에 장애가 나는 경우 최대 15시간 분량의 주문을 잃습니다. RPO 15분을 지키려면 15분마다 트랜잭션 로그를 백업하거나 다른 곳으로 데이터를 계속 복제하는 방식이 필요합니다.
RTO 3시간은 복구 단계별 예상 시간을 더해 확인합니다. 단계별 시간은 설명을 위한 가정입니다.
| 복구 단계 | 예상 시간 |
|---|---|
| 장애 인지 | 10분 |
| 복구 여부 결정 | 20분 |
| 복구용 서버 준비 | 30분 |
| 데이터 복원 | 50분 |
| 동작 확인 | 20분 |
| 합계 | 2시간 10분 |
데이터 복원 50분은 500GB 전체 백업을 실제 읽기 속도 초당 200MB로 읽어 약 42분, 이후 트랜잭션 로그 적용에 8분이 걸린다고 가정한 값입니다. 합계 2시간 10분은 RTO 3시간 안에 들어옵니다. 복원할 데이터가 두 배로 늘면 복원 시간도 그만큼 늘어나므로, 데이터 크기가 바뀔 때마다 다시 계산해 두면 좋습니다.
재해복구(DR) 전략별 RTO와 RPO, 백업부터 멀티 리전까지
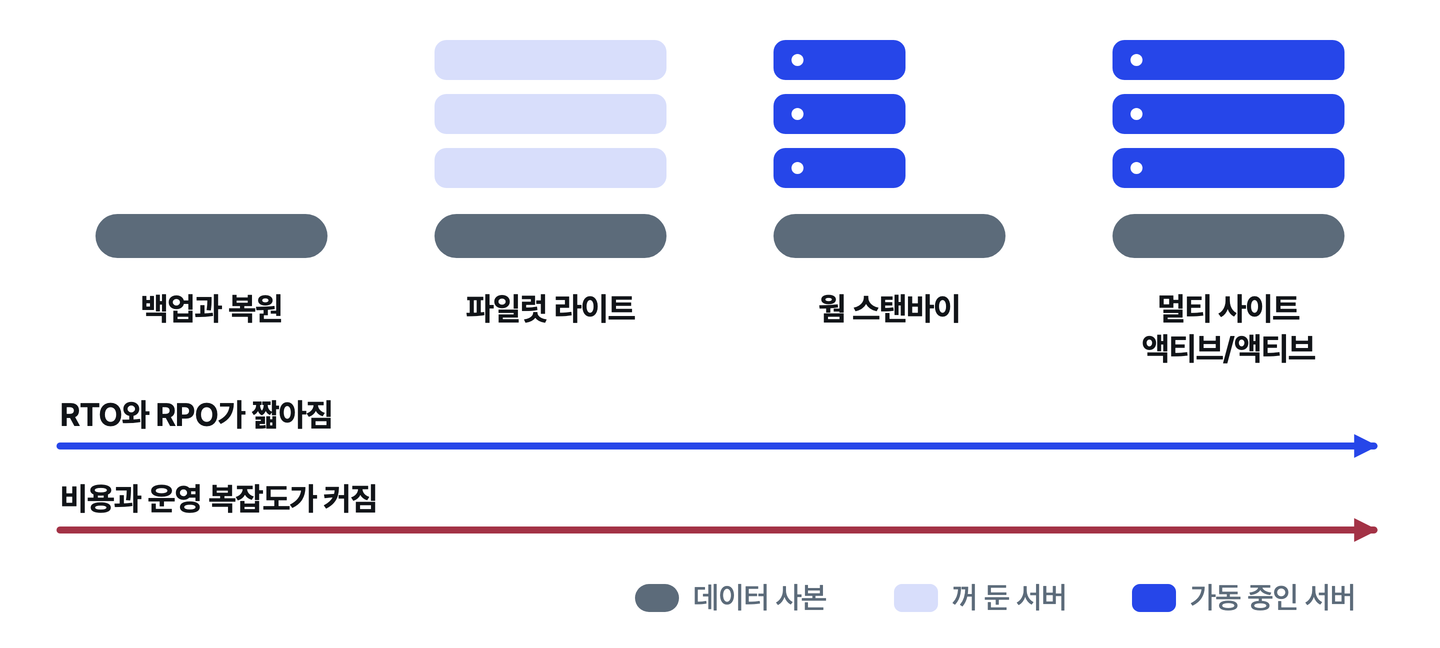
RTO와 RPO가 요구 사항이라면 재해복구 전략은 그 요구를 맞추는 수단입니다. 평소에 대기 환경을 얼마나 준비해 두느냐에 따라 복구 속도와 비용이 함께 달라집니다.
백업과 복원
가장 기본이 되는 방식은 데이터를 정해진 주기로 백업해 두었다가 사고가 나면 새 환경에 복원하는 것입니다. NIST 가이드는 데이터의 중요도와 새 데이터가 들어오는 빈도에 맞춰 백업 주기(일간, 주간)와 범위(전체, 증분)를 정책으로 정하고, 백업본은 다른 장소에 보관하도록 권합니다.
백업 주기가 곧 달성할 수 있는 RPO를 정합니다. 사고가 나면 서버와 네트워크, 애플리케이션을 다시 준비한 뒤 데이터를 복원해야 하므로 RTO는 다른 전략보다 깁니다.
콜드 사이트, 웜 사이트, 핫 사이트
주 데이터센터를 쓸 수 없을 때 옮겨 갈 대체 사이트는 준비 정도에 따라 세 가지로 나뉩니다. NIST 가이드의 분류는 다음과 같습니다.
- 콜드 사이트(cold site): 공간과 전력, 통신 회선, 냉방 설비 같은 기반 시설만 갖춘 곳입니다. 장비를 들여와 설치하는 데 시간이 오래 걸립니다.
- 웜 사이트(warm site): 시스템에 필요한 하드웨어와 소프트웨어, 통신 설비 일부나 전부를 갖춘 곳입니다.
- 핫 사이트(hot site): 필요한 하드웨어와 기반 시설, 운영 인력까지 갖춰 바로 업무를 넘겨받을 수 있는 곳입니다.
| 대체 사이트 | 비용 | 장비 | 준비 시간 |
|---|---|---|---|
| 콜드 사이트 | 낮음 | 없음 | 김 |
| 웜 사이트 | 중간 | 일부 | 중간 |
| 핫 사이트 | 중간 또는 높음 | 전부 | 짧음 |
NIST 가이드는 변형으로 미러 사이트(mirrored site)도 소개합니다. 실시간으로 데이터를 복제하며 주 사이트와 기술적으로 똑같이 갖춘 곳으로, 가장 비싸지만 가용성을 100%에 가깝게 유지할 수 있다고 설명합니다.
클라우드의 멀티 리전 재해복구 전략
클라우드에서는 대기 환경을 미리 준비해 두는 같은 발상을 리전(region, 클라우드 제공사가 운영하는 지역 단위 데이터센터 묶음) 단위로 구현합니다. AWS Well-Architected 신뢰성 가이드는 멀티 리전 재해복구 전략을 네 가지로 나누고, 전략마다 기대할 수 있는 RPO와 RTO 범위를 제시합니다.
| 전략 | 평소 복구 리전 상태 | RPO | RTO |
|---|---|---|---|
| 백업과 복원 | 백업본만 보관 | 수 시간 | 24시간 이내 |
| 파일럿 라이트 | 데이터만 복제, 서버는 꺼 둠 | 분 단위 | 수십 분 |
| 웜 스탠바이 | 축소 규모로 늘 가동 | 초 단위 | 분 단위 |
| 멀티 사이트 액티브/액티브 | 모든 리전이 요청 처리 | 0에 가까움 | 0일 수도 있음 |
파일럿 라이트(pilot light)와 웜 스탠바이(warm standby)는 헷갈리기 쉽습니다. AWS 가이드에 따르면 파일럿 라이트는 서버를 켜고 규모를 키우는 조치를 해야 요청을 받을 수 있고, 웜 스탠바이는 줄어든 용량으로라도 곧바로 요청을 받을 수 있습니다. 웜 스탠바이를 운영 규모까지 키워 둔 형태를 핫 스탠바이(hot standby)라고 부릅니다.
전략별 RPO와 RTO 범위는 한 클라우드 제공사가 안내하는 일반 값이고, 실제 값은 구현 방식에 따라 달라집니다. 같은 가이드는 필요 이상으로 엄격한 전략을 고르면 불필요한 비용이 든다며 피하라고 권합니다. AWS 가이드는 또 한 리전 안의 여러 가용 영역(availability zone)에 나눠 두는 구성만으로도 화재나 홍수, 대규모 정전 같은 사고에 대비할 수 있다고 설명합니다.
RTO와 RPO를 정할 때 헷갈리기 쉬운 점
RTO와 RPO 값을 정해 두어도 계획 단계에서 빠뜨린 요소가 있으면 실제 장애에서 목표를 넘길 수 있습니다. 빠뜨리기 쉬운 요소는 다음 네 가지입니다.
RTO에는 장애를 알아차리는 시간도 들어갑니다. NIST 가이드 본문의 설명대로 RTO는 시스템이 멈춘 채로 있어도 되는 시간이라, 시계는 장애가 난 순간부터 돌아갑니다. 복구 작업이 빨라도 장애를 30분 늦게 알면 쓸 수 있는 시간이 30분 줄어듭니다. 쇼핑몰 계산 예시에서 장애 인지를 10분으로 잡은 것도 모니터링과 알림이 제대로 동작한다는 전제입니다.
서비스 전체의 RTO는 가장 늦게 돌아오는 구성 요소가 정합니다. 웹 서버를 10분 만에 새로 띄워도 데이터베이스 복원에 2시간이 걸리면 사용자는 2시간 동안 서비스를 쓰지 못합니다. RTO는 서비스 단위로 정하되, 복구 시간은 구성 요소마다 따로 계산해 가장 긴 쪽을 기준으로 확인합니다.
복제본은 백업을 대신하지 못합니다. AWS 가이드는 데이터를 계속 복제해도 데이터 손상이나 악의적 삭제까지는 막지 못할 수 있다고 설명합니다. 원본에서 잘못 지운 데이터는 복제본에서도 지워지기 때문입니다. 그래서 복제를 쓰는 전략에도 특정 시점으로 되돌릴 수 있는 백업을 함께 두도록 권합니다.
복구 훈련을 해 봐야 숫자를 믿을 수 있습니다. AWS Well-Architected 신뢰성 가이드의 REL09-BP04 항목은 백업을 주기적으로 복원해 데이터가 온전한지, 복원이 RTO와 RPO 안에 끝나는지 확인하라고 권합니다. REL13-BP03 항목은 복구 사이트로 넘어가는 훈련을 정기적으로 해서 RTO와 RPO를 실제로 지키는지 검증하라고 안내합니다. 백업 파일이 있다는 사실과 그 파일로 제시간에 복원할 수 있다는 사실은 따로 확인해야 합니다.
자주 묻는 질문
RTO와 MTTR은 어떻게 다른가요?
RTO는 장애가 나기 전에 정해 두는 목표이자 상한선입니다. MTTR(Mean Time To Recovery, 평균 복구 시간)은 실제로 겪은 장애에서 복구까지 걸린 시간을 평균 낸 측정값입니다. MTTR이 RTO에 가까워지고 있다면 목표를 지킬 여유가 줄고 있다고 볼 수 있습니다.
RTO와 RPO를 0으로 만들 수 있나요?
AWS 가이드는 멀티 사이트 액티브/액티브 전략으로 RPO는 0에 가깝게, RTO는 0까지도 줄일 수 있다고 설명합니다. 다만 네 가지 전략 가운데 비용과 운영 복잡도가 가장 큽니다. 두 리전에서 같은 데이터를 동시에 고칠 때 생기는 충돌도 따로 설계해 처리해야 합니다. 모든 시스템을 0에 맞추기보다 업무 영향이 큰 시스템부터 목표를 좁혀 가는 방식이 비용을 관리하기 쉽습니다.
RPO가 1시간이면 백업도 1시간마다 해야 하나요?
1시간마다 백업하는 것은 출발점입니다. 백업 작업 자체에 걸리는 시간, 예약 시각이 밀리는 경우, 백업이 실패해 다음 회차를 기다리는 경우까지 생각하면 복구할 수 있는 지점 사이가 1시간을 넘을 수 있습니다. 그래서 백업 주기를 RPO보다 짧게 잡거나, 트랜잭션 로그 백업이나 복제로 전체 백업 사이의 빈 시간을 채웁니다. 백업이 실제로 성공했는지도 매번 확인해야 RPO를 지킨다고 말할 수 있습니다.
공공기관 정보시스템의 등급별 RTO 기준은 어디서 확인하나요?
공공기관 정보시스템은 「행정기관 및 공공기관 정보시스템 안정성 고시」에 따라 등급을 산정하고, 등급에 따라 복구 목표 시간이 달라집니다. 등급 산정 방식과 등급별 점검 의무는 공공 정보시스템 예방점검 등급별 필수 점검 기준과 대응 전략에 정리했습니다.
마치며
RTO는 얼마나 오래 멈춰도 되는지, RPO는 데이터를 얼마나 잃어도 되는지를 정한 값입니다. RTO와 RPO는 업무 영향에서 출발해 정하고, 백업 주기와 대기 환경 수준을 고르는 기준으로 씁니다.
RTO를 지키려면 복구 작업만큼 장애를 빨리 알아차리는 일도 중요합니다. 와탭 URL 모니터링은 웹사이트가 열리지 않거나 응답이 느려지면 알림을 보내 장애를 인지하는 시간을 줄이는 데 도움이 됩니다. URL 모니터링 문서에서 동작 방식을 확인해 보세요.
더 읽을거리
- URL 모니터링 (와탭 공식 문서)
- 공공 정보시스템 예방점검 등급별 필수 점검 기준과 대응 전략
- 장애 대응 능력을 확인할 수 있는 지표 MTTD MTTR MTTF MTBF
- SP 800-34 Rev. 1, Contingency Planning Guide for Federal Information Systems (NIST)
- REL13-BP02 Use defined recovery strategies to meet the recovery objectives (AWS Well-Architected)
- REL09-BP04 Perform periodic recovery of the data to verify backup integrity and processes (AWS Well-Architected)
- REL13-BP03 Test disaster recovery implementation to validate the implementation (AWS Well-Architected)