담당자가 프로모션 코드를 발송해 드립니다.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
WhaTap AI를 경험해 보세요.
데이터베이스란? RDBMS와 NoSQL 뜻과 차이, 벡터 DB까지
서비스를 하나 만들면 회원 정보, 주문 내역, 게시글처럼 계속 쌓이고 바뀌는 데이터가 생깁니다. 이 데이터를 파일마다 따로 저장하는 대신, 여러 사람과 프로그램이 동시에 안전하게 읽고 쓸 수 있는 곳 한 군데에 모아 둡니다. 그렇게 모아 두는 곳을 데이터베이스라고 부릅니다.
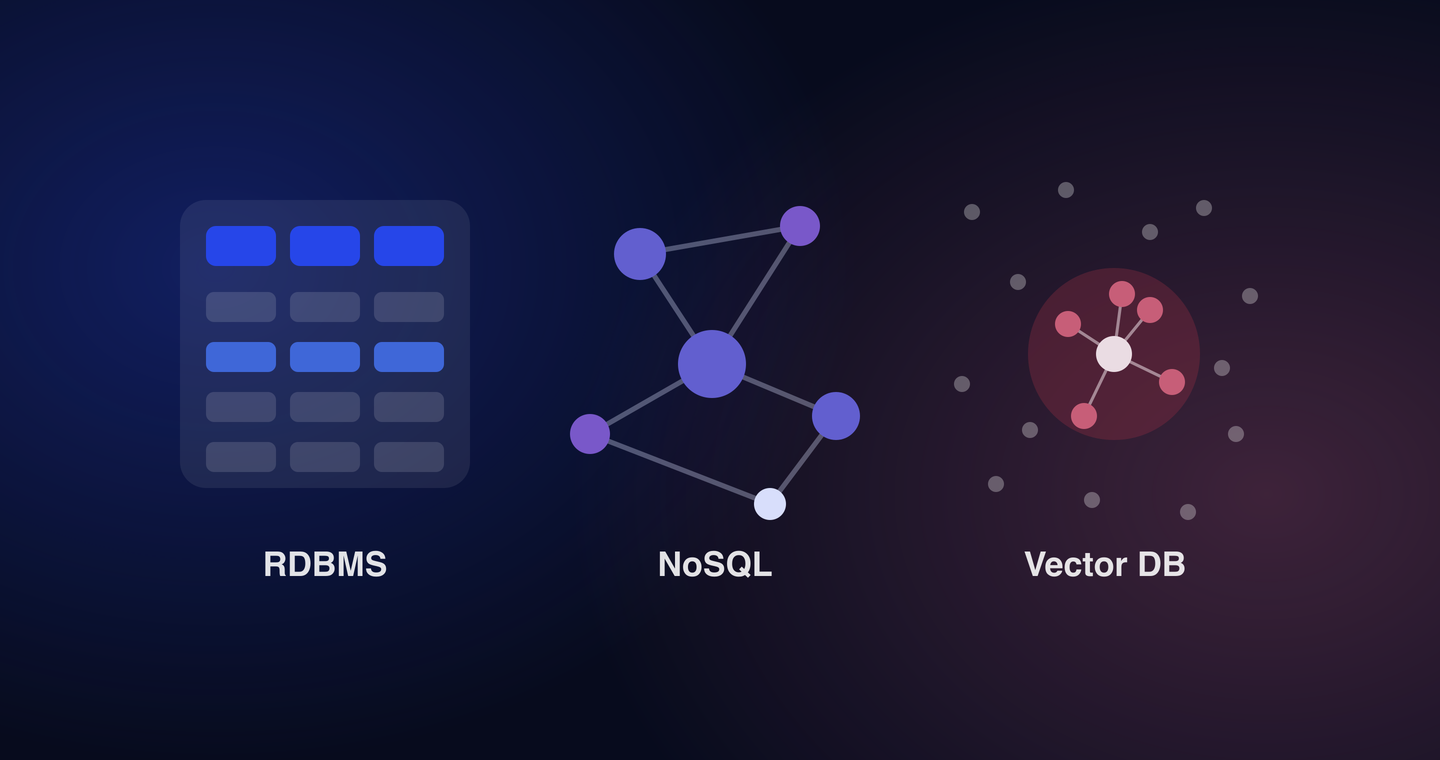
처음 데이터베이스를 고를 때 가장 먼저 부딪히는 선택이 RDBMS냐 NoSQL이냐입니다. 요즘은 AI 검색 기능을 붙이면서 벡터 DB라는 이름도 함께 등장합니다. RDBMS와 NoSQL, 벡터 DB가 무엇을 기준으로 나뉘는지 알면 고르기가 쉬워집니다.
데이터베이스는 여러 사용자와 프로그램이 함께 쓸 수 있도록 데이터를 일정한 구조로 모아 둔 저장소이고, 이 저장소를 만들고 관리하는 소프트웨어를 DBMS라고 합니다.
데이터베이스란? DB와 DBMS 뜻
데이터베이스(Database, DB)는 데이터를 모아 둔 저장소 자체를 가리킵니다. 저장소를 실제로 만들고 운영하는 소프트웨어는 DBMS(Database Management System, 데이터베이스 관리 시스템)라고 부릅니다. MySQL, PostgreSQL, MongoDB 같은 이름은 모두 DBMS의 제품명입니다.
실무에서는 DB와 DBMS를 구분하지 않고 섞어 씁니다. "MySQL 데이터베이스"라고 하면 MySQL이라는 DBMS로 만든 데이터베이스라는 뜻입니다.
DBMS가 하는 일은 크게 네 가지입니다.
- 저장: 데이터를 디스크에 안전하게 기록합니다.
- 조회: 원하는 조건의 데이터를 빠르게 찾아 줍니다.
- 동시성 제어: 여러 요청이 같은 데이터를 동시에 바꿀 때 결과가 어긋나지 않게 순서를 정리합니다.
- 복구: 서버가 갑자기 꺼져도 기록된 데이터를 되살립니다.
데이터베이스 종류, RDBMS와 NoSQL 뜻
데이터베이스는 데이터를 담는 구조에 따라 여러 종류로 나뉩니다. 오래전에는 트리 구조로 데이터를 담는 계층형, 데이터끼리 그물처럼 연결하는 망형도 쓰였지만, 지금 현장에서 주로 고르는 종류는 관계형(RDBMS)과 비관계형(NoSQL)입니다.
RDBMS(관계형 데이터베이스, RDB)란
RDBMS(Relational Database Management System)는 데이터를 행과 열로 된 표, 곧 테이블에 담고 테이블끼리 관계를 맺어 관리하는 DBMS입니다. RDBMS로 만든 데이터베이스를 관계형 데이터베이스(relational database), 줄여서 RDB라고 부릅니다. MySQL, PostgreSQL, Oracle, SQL Server가 대표적입니다.
쇼핑몰을 예로 들면 회원 테이블, 상품 테이블, 주문 테이블을 따로 만들고, 주문 테이블에는 회원 번호와 상품 번호만 넣어 둡니다. 주문 내역을 볼 때는 세 테이블을 번호로 이어 붙여 한 번에 조회하는데, 이렇게 테이블을 잇는 작업을 조인(JOIN)이라고 합니다. 같은 회원 정보를 여러 곳에 반복해 저장하지 않으니, 주소가 바뀌어도 회원 테이블 한 곳만 고치면 됩니다.
RDBMS에서는 테이블 구조를 미리 정해 둡니다. 테이블에 어떤 열이 있고 각 열에 어떤 형식의 값이 들어가는지 정한 설계도를 스키마(schema)라고 합니다. 정해 둔 스키마에 따라 데이터 형식과 구조를 일정하게 관리하기 쉽습니다.
RDBMS는 여러 작업을 하나의 묶음으로 처리하는 트랜잭션을 지원합니다. 계좌 A에서 돈을 빼고 계좌 B에 넣는 두 작업처럼 일부만 처리되면 안 되는 작업을, 모두 성공시키거나 모두 취소할 수 있습니다. 이런 트랜잭션의 안정성을 설명하는 네 가지 성질을 ACID(원자성, 일관성, 격리성, 지속성)라고 합니다. 그래서 장애가 나거나 요청이 한꺼번에 몰려도 결제나 계좌 이체 같은 데이터가 어긋나지 않게 지킬 수 있습니다.
데이터를 조회하고 바꿀 때는 SQL(Structured Query Language)이라는 표준 질의 언어를 씁니다. 기본 문법은 대부분 같아서 한 번 익히면 여러 RDBMS에서 통합니다. 다만 행 수 제한이나 날짜 함수처럼 제품마다 조금씩 다른 부분도 있습니다.
NoSQL(비관계형 데이터베이스)이란
NoSQL은 테이블과 관계 대신 다른 구조로 데이터를 담는 데이터베이스를 통틀어 부르는 말입니다. 이름은 "Not Only SQL"로 풀이하는 경우가 많고, 비관계형 데이터베이스라고도 합니다. 하나의 제품이 아니라 여러 저장 방식을 묶은 이름이라, 데이터를 어떤 모양으로 담느냐에 따라 종류가 나뉩니다.
| 종류 | 데이터를 담는 방식 | 대표 제품 |
|---|---|---|
| 문서형 | JSON 같은 문서 한 건에 관련 정보를 함께 담음 | MongoDB |
| 키-값형 | 키 하나에 값 하나를 짝지어 담음 | Redis |
| 와이드 컬럼형 | 파티션 키로 여러 서버에 나눠 담고 대량 쓰기에 강함 | Cassandra |
| 그래프형 | 데이터를 점으로, 관계를 선으로 담음 | Neo4j |
NoSQL은 스키마를 미리 강제하지 않는 제품이 많습니다. 게시글 문서마다 태그가 있을 수도 없을 수도 있고, 새 항목을 더할 때 기존 데이터는 그대로 둬도 됩니다. 그래서 구조가 자주 바뀌는 데이터나 형태가 제각각인 데이터를 담기 편합니다.
또 여러 서버에 데이터를 나눠 담는 방식을 처음부터 염두에 두고 설계한 제품이 많습니다. 데이터와 요청이 늘면 서버 대수를 늘려 감당하는데, 이 방식을 수평 확장(scale-out)이라고 합니다. 반대로 서버 한 대의 CPU와 메모리를 키우는 방식은 수직 확장(scale-up)이라고 합니다.
RDBMS와 NoSQL 차이, 관계형과 비관계형 데이터베이스 비교
관계형 데이터베이스(RDBMS)는 데이터 구조를 먼저 정하고 그 규칙을 지키게 하는 쪽이고, 비관계형 데이터베이스(NoSQL)는 구조를 유연하게 두고 서버를 늘리기 쉽게 만든 쪽입니다.
| 비교 항목 | RDBMS | NoSQL |
|---|---|---|
| 저장 구조 | 행과 열로 된 테이블 | 문서, 키-값, 와이드 컬럼, 그래프 |
| 스키마 | 미리 정하고 지켜야 함 | 제품에 따라 유연함 |
| 데이터 관계 | 테이블을 조인해 연결 | 제품 종류마다 다름 |
| 질의 언어 | 표준 SQL | 제품마다 다른 질의 방식 |
| 트랜잭션 | ACID를 기본으로 보장 | 제품과 설정에 따라 다름 |
| 확장 방식 | 수직 확장과 수평 확장 모두 사용 | 수평 확장을 고려한 제품이 많음 |
| 잘 맞는 데이터 | 주문, 결제, 재고, 회원 | 로그, 세션, 캐시, 구조가 자주 바뀌는 데이터 |
표의 트랜잭션 행은 기본 성향입니다. 요즘은 경계가 많이 흐려졌습니다. MongoDB처럼 여러 문서에 걸친 트랜잭션을 지원하는 NoSQL도 있고, RDBMS도 복제(같은 데이터를 여러 서버에 복사해 두는 방식)로 읽기 요청을 나누고, 샤딩(데이터를 기준에 따라 여러 서버에 나눠 담는 방식)으로 저장량을 분산할 수 있습니다.
상황별 데이터베이스 선택 기준
실무에서는 하나만 고르기보다 함께 쓰는 경우가 많습니다. 주문과 결제는 RDBMS에 두고, 로그인 세션과 자주 읽는 화면 데이터는 Redis 같은 키-값 저장소에 캐시(자주 읽는 데이터를 빠르게 꺼내도록 따로 복사해 둔 것)로 두는 식입니다. 상황별로 먼저 검토할 데이터베이스를 표로 정리했습니다.
| 이런 데이터라면 | 먼저 검토할 것 |
|---|---|
| 돈이 오가거나 수량이 정확해야 함 | RDBMS |
| 여러 표를 엮어 집계하고 보고서를 뽑음 | RDBMS |
| 항목 구성이 자주 바뀌거나 제각각임 | 문서형 NoSQL |
| 아주 빠르게 읽고 쓰는 임시 데이터 | 키-값형 NoSQL |
| 쓰기가 아주 많고 계속 쌓임 | 와이드 컬럼형 NoSQL |
| 뜻이 비슷한 문서나 이미지를 찾아야 함 | 벡터 DB 또는 벡터 검색 기능 |
벡터 DB는 RDBMS와 NoSQL 중 어디에 속하나
벡터 DB(벡터 데이터베이스)는 문장이나 이미지를 AI 모델이 만든 숫자 배열로 저장해 두고, 뜻이 가까운 데이터를 찾아 주는 데이터베이스입니다.
벡터 DB는 RDBMS와 NoSQL 어느 쪽에도 더할 수 있는 검색 방식에 가깝습니다. RDBMS와 NoSQL은 데이터를 어떤 구조로 담느냐로 나눈 이름이고, 벡터 DB는 데이터를 어떻게 찾느냐에 초점을 둔 이름입니다.
숫자를 줄지어 늘어놓은 배열을 벡터(vector)라고 하고, 문장이나 이미지의 의미를 벡터로 옮긴 값을 임베딩(embedding)이라고 합니다. AI 모델은 문장 하나를 숫자 수백 ~ 수천 개짜리 임베딩으로 바꿀 수 있고, 뜻이 비슷한 문장일수록 두 임베딩의 좌표가 가깝게 놓입니다. 좌표가 가까운 데이터를 찾는 방식을 유사도 검색(similarity search)이라고 합니다.
RDBMS의 일반적인 검색은 "주문 번호가 1024인 행"처럼 정한 조건에 맞는 데이터를 찾습니다. 벡터 검색은 "환불 절차가 궁금해요"라는 질문에 "반품과 교환 안내" 문서처럼 단어는 달라도 뜻이 가까운 데이터를 찾습니다. 챗봇이 답하기 전에 회사 문서에서 관련 내용을 먼저 찾아 참고하게 하는 방식을 RAG(Retrieval-Augmented Generation, 검색 증강 생성)라고 하며, 문서를 찾는 단계에서 주로 벡터 검색을 씁니다.
벡터 검색을 쓰려고 꼭 새 데이터베이스를 들일 필요는 없습니다. 선택지는 두 가지입니다.
- 기존 데이터베이스의 벡터 기능: PostgreSQL의 확장 기능인 pgvector나 MongoDB Atlas Vector Search처럼, 쓰던 데이터베이스에 벡터 검색을 더합니다. 원래 데이터와 임베딩을 한곳에서 관리할 수 있어 규모가 크지 않을 때 시작하기 좋습니다. SingleStore처럼 분산 SQL 데이터베이스가 벡터 검색을 함께 제공하는 경우도 있습니다.
- 벡터 전용 데이터베이스: Milvus, Qdrant처럼 처음부터 벡터 검색용으로 만든 제품입니다. 임베딩 규모가 커지고 벡터 검색 성능이나 분산 운영 요구가 커지면 검토합니다.
벡터 검색은 RDBMS를 쓰든 NoSQL을 쓰든 함께 더할 수 있어서, 기존 데이터베이스를 바꾸지 않고 시작하는 경우가 많습니다. 주문 데이터는 RDBMS에 두고, 상품 설명의 임베딩은 같은 데이터베이스의 벡터 기능이나 별도 벡터 DB에 두는 구성이 자주 쓰입니다.
자주 묻는 질문
RDB와 RDBMS는 같은 말인가요
엄밀히는 다릅니다. RDB는 테이블과 관계로 구성된 데이터베이스이고, RDBMS는 그 데이터베이스를 만들고 운영하는 소프트웨어입니다. 클라우드 콘솔에서 보이는 Amazon RDS는 또 다른 말입니다. RDS(Relational Database Service)는 MySQL이나 PostgreSQL 같은 RDBMS를 대신 설치하고 운영해 주는 관리형 서비스 이름입니다.
NoSQL에서는 SQL을 전혀 쓸 수 없나요
그렇지 않습니다. NoSQL이라는 이름은 표준 SQL과 테이블 구조에 얽매이지 않는다는 뜻에 가깝습니다. Cassandra는 SQL과 비슷한 문법의 CQL(Cassandra Query Language)을 쓰고, 여러 문서형 데이터베이스도 SQL과 닮은 쿼리(질의문)를 지원합니다. 문법이 비슷해 보여도 조인이나 집계가 동작하는 방식은 제품마다 다르니, 옮겨 올 쿼리가 있다면 그 제품의 공식 문서에서 지원 범위를 먼저 확인합니다.
처음 서비스를 만든다면 RDBMS와 NoSQL 중 무엇으로 시작하나요
데이터 구조가 아직 확실하지 않더라도, 회원과 주문처럼 정확해야 하는 데이터가 있다면 RDBMS로 시작하는 경우가 많습니다. PostgreSQL과 MySQL은 JSON 형식의 열도 지원해서 구조가 자주 바뀌는 일부 데이터를 함께 담을 수 있습니다. 쓰다가 특정 데이터의 읽기와 쓰기가 서버 한 대로 감당이 안 될 만큼 늘면, 그 데이터만 NoSQL로 옮기는 편이 전체를 바꾸는 것보다 부담이 적습니다.
마치며
정확해야 하고 서로 얽힌 데이터는 RDBMS, 구조가 자주 바뀌거나 양이 빠르게 느는 데이터는 NoSQL, 뜻으로 찾아야 하는 데이터는 벡터 검색이 맞습니다. 한 서비스 안에서 RDBMS와 NoSQL, 벡터 검색을 함께 쓰는 구성도 많습니다.
여러 데이터베이스를 함께 쓰면 요청이 느려졌을 때 어느 데이터베이스에서 시간이 걸렸는지 따로 확인해야 합니다. 와탭 데이터베이스 모니터링은 MySQL, PostgreSQL, Oracle 같은 RDBMS와 MongoDB, Redis 같은 NoSQL을 지원합니다. 지원하는 데이터베이스와 기능은 데이터베이스별 지원 기능 비교 문서에서 확인해 보세요.
더 읽을거리