담당자가 프로모션 코드를 발송해 드립니다.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
WhaTap AI를 경험해 보세요.
쿠버네티스 GPU 할당의 혁신: 노드 전체 격리 없이 장애 GPU만 제어하기
GPU가 여덟 장 꽂힌 서버를 떠올려 보겠습니다. 그중 한 장에서만 ECC 오류가 반복되고 나머지 일곱 장은 정상이라면, 문제가 있는 GPU만 골라 사용을 막으면 됩니다. 하지만 기존 쿠버네티스(Kubernetes, 줄여서 k8s)에서는 이 작업이 쉽지 않았습니다. GPU 한 장을 제외하려면 서버 한 대 전체를 배치 대상에서 빼는 것 말고는 마땅한 수단이 없었습니다. 한 장 때문에 정상인 일곱 장까지 쓰지 못했습니다.
쿠버네티스 GPU 할당은 파드가 요청한 GPU를 클러스터의 어느 장치로 채울지 정하는 과정입니다. 파드는 "GPU 한 장이 필요하다"처럼 필요한 개수만 요청합니다. 스케줄러는 GPU가 남아 있는 노드를 찾고, 노드 안에서 실제로 어떤 GPU를 줄지는 각 노드에서 파드와 장치를 관리하는 kubelet의 디바이스 관리 계층과 플러그인이 결정합니다. 스케줄러가 특정 GPU의 상태를 보고 문제가 있는 장치만 직접 제외하기는 어려웠습니다.
쿠버네티스 v1.37에서는 GPU 클러스터를 더 세밀하게 운영할 수 있는 기능 두 가지가 들어왔습니다. DRA 디바이스 테인트는 문제가 있는 GPU 한 장만 골라 배치 대상에서 제외하는 정식 기능입니다. 갱 스케줄링은 여러 파드가 함께 준비됐을 때만 배치를 시작하도록 한 단위로 다루는 기능이고, v1.37에서 베타가 됐습니다.
두 기능이 해결하는 문제는 다릅니다. 디바이스 테인트는 어떤 GPU를 쓰지 않을지 정하는 기능이고, 갱 스케줄링은 그 GPU를 쓸 파드를 몇 개씩 함께 올릴지 정하는 기능입니다. 이 글에서는 두 기능이 어떻게 동작하고, 실제로 사용하려면 무엇을 준비해야 하는지 차례로 살펴봅니다.
쿠버네티스 GPU 할당 방식과 노드 테인트의 한계
테인트(taint)는 노드나 장치에 달아 두는 표시입니다. 이 표시를 견디겠다고 선언하지 않은 파드는 그곳에 배치되지 않고, 그 선언을 톨러레이션(toleration)이라고 합니다. 기존에 널리 사용해 온 노드 테인트는 노드 한 대를 격리 단위로 삼습니다.
스케줄러가 다루는 정보에는 개별 장치가 없습니다. 그래서 문제가 있는 GPU를 지목할 방법이 없었고, 남는 선택지는 노드 테인트로 그 노드 전체를 막는 것뿐이었습니다.
그렇다면 GPU를 노드에 딸린 단순한 개수가 아니라, 하나하나 구분할 수 있는 개별 장치로 관리하면 어떨까요? 이 역할을 하는 것이 DRA(Dynamic Resource Allocation)입니다. DRA는 v1.35부터 정식 기능입니다.
DRA에서는 GPU를 창고에 쌓인 여덟 개로만 보지 않고 번호가 붙은 개별 물건처럼 다룹니다. 드라이버는 쓸 수 있는 장치 목록을 ResourceSlice로 공개하고, 파드는 ResourceClaim이라는 요청서를 내서 필요한 장치를 받습니다. 이렇게 장치마다 이름과 속성이 생기면서 특정 한 장을 지목하는 조작이 가능해졌습니다.
디바이스 테인트는 모든 GPU가 아니라 DRA로 관리되는 장치에만 걸립니다. 그렇다고 요청 문법만 보고 DRA 여부를 판별할 수는 없습니다. DRA가 기존 확장 리소스 요청 형식을 받아들이는 기능은 v1.35 알파와 v1.36 베타를 거쳐 v1.37에서 정식이 됐습니다. 파드가 nvidia.com/gpu 형식을 쓰더라도 현재 GPU를 DRA 드라이버와 DeviceClass로 관리하고 있는지를 보면 됩니다.
DRA 디바이스 테인트로 GPU 한 장만 격리하는 방법
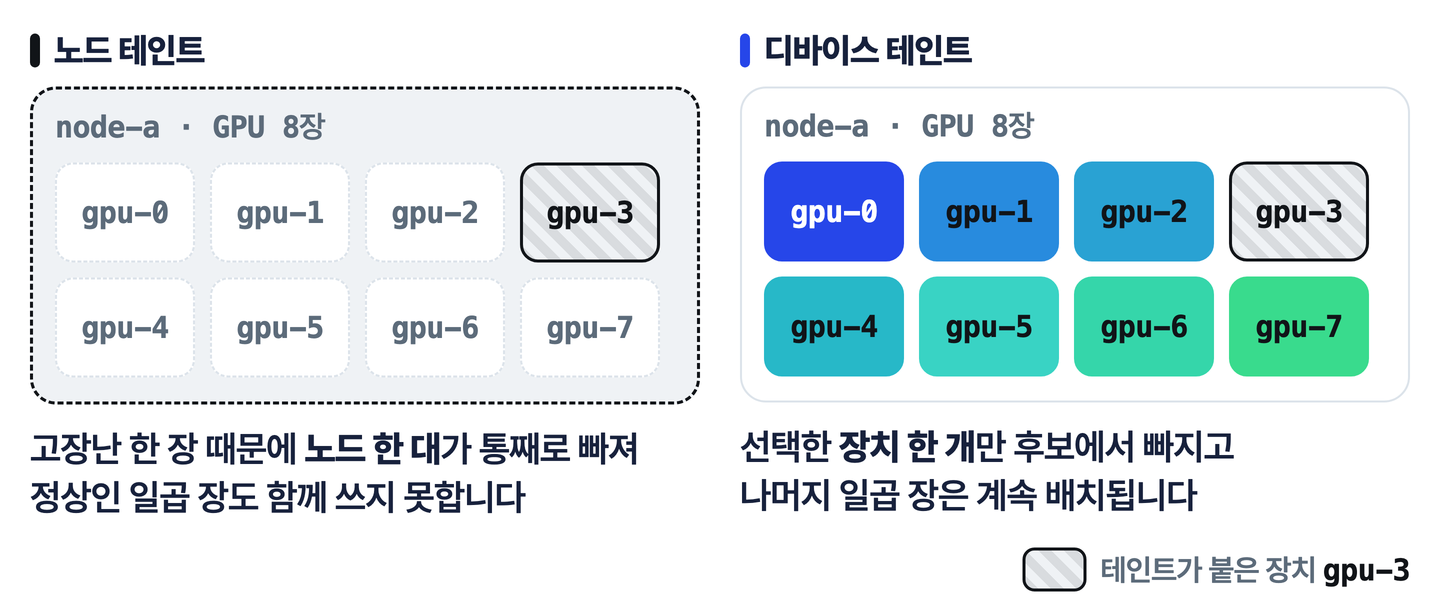
디바이스 테인트는 GPU 같은 장치 하나에 표시를 달아, 그 장치를 쓰는 파드가 새로 배치되지 않게 하거나 이미 돌고 있는 파드를 내보내는 기능입니다. v1.37부터 정식 기능입니다.
표시를 다는 경로는 두 가지입니다. DRA 드라이버가 장치 상태를 보고 직접 달거나, 관리자가 DeviceTaintRule 객체로 겁니다. 범위가 가장 넓은 예시부터 봅니다. 특정 드라이버가 관리하는 장치를 전부 선택해 비우는 설정입니다.
apiVersion: resource.k8s.io/v1
kind: DeviceTaintRule
metadata:
  name: example
spec:
  # The entire hardware installation for this
  # particular driver is broken.
  # Evict all pods and don't schedule new ones.
  deviceSelector:
    driver: dra.example.com
  taint:
    key: dra.example.com/unhealthy
    value: Broken
    effect: NoExecute
한 장만 빼려면 deviceSelector의 범위를 좁힙니다. pool을 더하면 드라이버가 정의한 리소스 풀로 범위를 제한할 수 있습니다. 드라이버가 노드마다 붙은 장치를 관리한다면 이 범위는 특정 노드 하나가 됩니다. 여기에 device까지 지정하면 그 풀 안의 특정 장치를 선택할 수 있습니다.
spec:
  deviceSelector:
    driver: dra.example.com
    pool: node-a
    device: gpu-3
  taint:
    key: dra.example.com/unhealthy
    value: Degraded
    effect: NoSchedule
여기 적는 driver, pool, device 값은 임의로 정하는 것이 아니라 드라이버가 공개한 ResourceSlice에 실제로 올라와 있는 값이어야 합니다. kubectl get resourceslices -o yaml로 확인한 뒤 그대로 옮겨 적습니다.
드라이버에 따라서는 gpu-0 같은 고정된 이름을 쓰면서, 그 이름이 지금 어느 장치를 가리키는지는 드러내지 않기도 합니다. 이런 드라이버라면 장비 고유 ID 같은 벤더 속성을 CEL(Common Expression Language, 장치 속성을 조건식으로 검색하는 표현식)로 지정하는 편이 안전합니다. 다만 그런 속성을 제공하는지는 드라이버마다 다릅니다.
효과는 세 가지이며, 어떤 효과를 선택하느냐에 따라 실행 중인 파드의 처리 방식이 달라집니다.
축출은 실행 중인 파드를 종료해 내보내는 조작입니다. kube-controller-manager의 디바이스 테인트 축출 컨트롤러가 해당 파드를 삭제합니다.
파드가 사라지면 학습 작업이 중단됩니다. 다만 잡이나 디플로이먼트 같은 상위 컨트롤러가 그 파드를 관리하고 있다면, 상위 컨트롤러가 새 파드를 만들어 정상 장치에 다시 배치합니다. 적용 전에 체크포인트와 재시작 정책을 먼저 봅니다.
그래서 None을 먼저 써 보는 편이 안전합니다. 효과를 None으로 두고 규칙을 만들면 실제로는 아무것도 축출하지 않으면서 영향 범위만 상태 메시지로 알려 줍니다.
3 published devices selected. 1 allocated device selected.
1 pod would be evicted in 1 namespace if the effect was NoExecute.
컨트롤러는 이 숫자를 규칙을 만든 시점에 한 번만 계산하고, 그 뒤로는 갱신하지 않습니다. 장치 할당 상태가 달라진 다음에 영향 범위를 다시 보려면 DeviceTaintRule을 새로 만들어야 합니다. 숫자를 확인하고 납득이 되면 그때 효과를 NoExecute로 바꿉니다. 축출이 끝났는지는 규칙에 붙는 조건으로 확인합니다.
kubectl wait --for=condition=EvictionInProgress=false DeviceTaintRule/example반대로 특정 워크로드만 그 장치를 계속 쓰게 하려면 ResourceClaim 쪽에 톨러레이션을 선언합니다. 장치 상태를 진단하는 잡처럼 고장난 장치에 일부러 붙어야 하는 경우가 여기에 해당합니다. 키와 값을 지정해 특정 테인트만 견디게 할 수도 있고, 빈 톨러레이션을 두면 모든 테인트를 견딥니다.
갱 스케줄링(gang scheduling)으로 분산 학습 파드를 묶어서 배치하는 방법
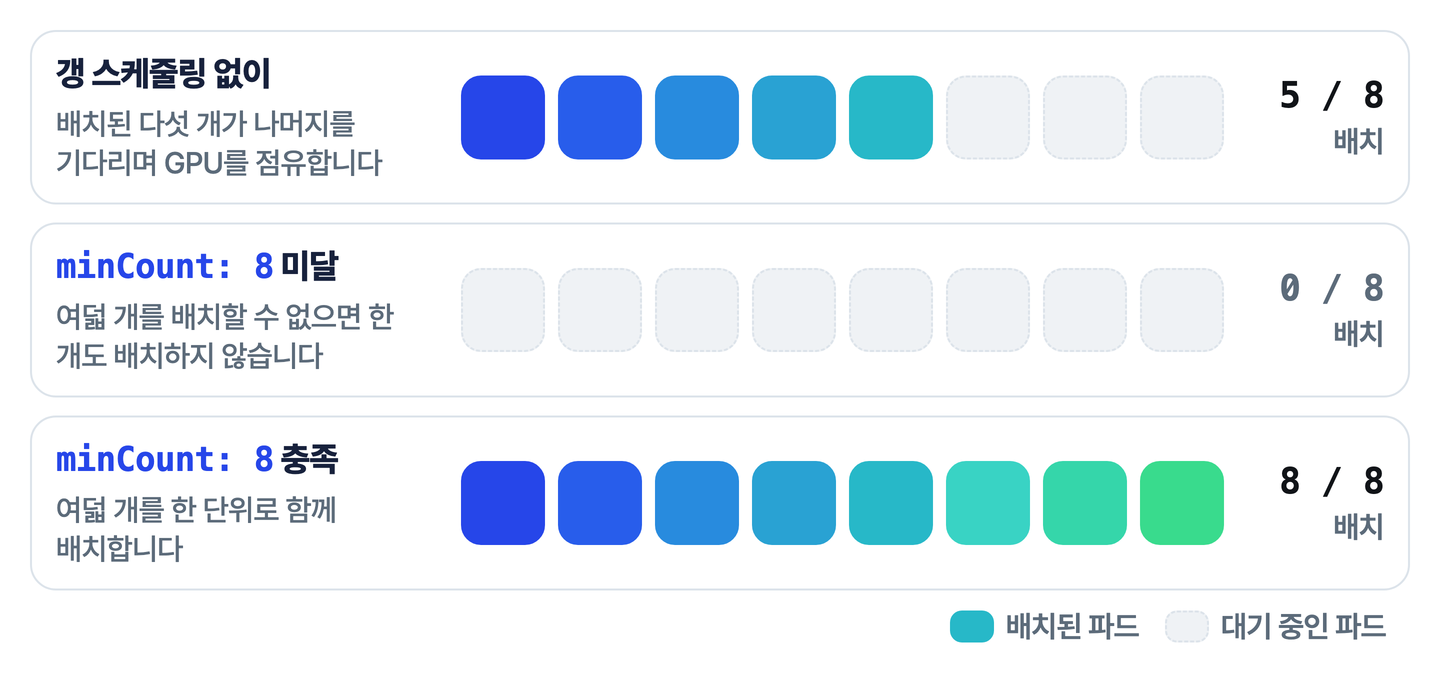
분산 학습은 워커가 서로를 기다립니다. 여덟 개가 모여야 첫 스텝이 도는 잡에서 다섯 개만 배치되면, 그 다섯 개는 나머지를 기다리며 GPU를 쥐고만 있습니다. 일이 진행되지 않는데 점유는 계속됩니다.
갱 스케줄링은 여러 파드를 한 덩어리로 묶어, 정해진 최소 수량만큼 배치할 수 있을 때만 배치하고 아니면 하나도 배치하지 않는 방식입니다. v1.37에서 베타가 됐고 기본값은 꺼짐입니다.
그룹을 지정하는 객체가 PodGroup입니다. 몇 개가 동시에 배치돼야 하는지를 minCount에 적습니다.
apiVersion: scheduling.k8s.io/v1beta1
kind: PodGroup
metadata:
  name: training-worker-0
  namespace: default
spec:
  schedulingPolicy:
    gang:
      minCount: 4
파드는 spec.schedulingGroup.podGroupName으로 자기가 속한 그룹을 가리킵니다.
apiVersion: v1
kind: Pod
metadata:
  name: worker-0
spec:
  schedulingGroup:
    podGroupName: training-worker-0
  containers:
  - name: ml-worker
    image: training:v1
갱 스케줄링의 배치 과정은 두 단계로 진행됩니다. 먼저 스케줄러가 그룹 객체가 존재하고 그룹에 속한 파드 수가 minCount 이상이 될 때까지 파드를 대기열에 붙들어 둡니다. 배치를 시작하는 데 필요한 이 최소 파드 수를 정족수라고 합니다.
정족수가 차면 스케줄러가 남은 파드를 어느 노드에 배치할지 함께 계산합니다. 이때 minCount 이상의 파드를 배치할 수 있으면 배치를 확정하고, 그 수를 채울 수 없으면 아무 파드도 배치하지 않습니다.
다만 minCount가 그룹 전체의 동시 배치를 보장하는 것은 아닙니다. 여덟 개가 반드시 함께 떠야 한다면 minCount를 여덟으로 지정해야 합니다.
minCount를 충족해야 그룹의 첫 배치를 시작할 수 있습니다. 첫 배치가 끝났다고 해서 이후에도 항상 minCount 이상의 파드가 실행된다는 뜻은 아닙니다. 그 뒤 실행 중인 파드가 삭제·축출되거나 minCount 값을 올리면, 배치된 파드 수가 기준 아래로 내려갈 수 있습니다. 이때 스케줄러는 이미 배치된 파드와 새로 배치할 수 있는 파드를 합친 수가 minCount 이상일 때만 추가 배치를 진행합니다.
PodGroup에는 gang 외에 basic 정책도 있습니다. 모든 파드를 동시에 배치할 필요가 없다면 basic을 씁니다. 이 정책에서는 같은 PodGroup에 속해 있어도 파드가 일반적인 파드처럼 각각 배치됩니다. 배치 결과를 하나의 그룹으로 모아 관리하고 싶지만 최소 동시 배치 수를 보장할 필요는 없는 워크로드에 맞습니다.
그룹을 다시 계층으로 구성해야 할 때 쓰는 CompositePodGroup 객체가 v1.37에 알파로 들어왔습니다. 자식 그룹 중 몇 개가 함께 배치돼야 하는지를 minGroupCount로 지정해 계층형 갱 스케줄링 정책을 표현합니다. minCount와 basic은 PodGroup의 정책이고, minGroupCount는 CompositePodGroup의 정책입니다.
쿠버네티스 GPU 스케줄링 적용 전에 확인할 세 가지
첫째, GPU를 DRA로 관리하고 있어야 합니다. 디바이스 테인트는 DRA 드라이버가 ResourceSlice로 공개한 장치에만 적용됩니다. 기존 디바이스 플러그인으로만 GPU를 제공하고 있다면 DRA 지원 드라이버를 설치하거나 기존 구성을 전환해야 합니다.
둘째, 갱 스케줄링을 쓰려면 GenericWorkload 피처 게이트를 켜고 scheduling.k8s.io/v1beta1 API 그룹을 활성화해야 합니다.
이 설정은 컨트롤 플레인에 있습니다. 직접 운영하는 클러스터라면 kube-apiserver와 kube-scheduler에 실행 인자로 넘겨 바꿀 수 있지만, 관리형 쿠버네티스에서는 사용자가 바꾸지 못할 수 있습니다. 관리형 서비스를 쓴다면 제공사가 이 기능을 지원하는지 먼저 확인해야 합니다.
셋째, 두 기능 모두 배치 결과를 읽을 수단이 있어야 의미가 있습니다. 파드가 대기 중인 이유가 정족수 미달인지 자원 부족인지 구분할 수 없으면 minCount를 조정할 근거가 없습니다. 장치 단위 상태와 파드 배치 결과를 같은 시간 축에서 볼 수 있게 준비해 두는 편이 좋습니다.
마치며
쿠버네티스 v1.37에서는 GPU를 장치 단위로 격리하고, 여러 파드를 그룹 단위로 배치할 수 있게 됐습니다. 고장난 GPU 한 장 때문에 노드를 통째로 비우지 않아도 되고, 워커가 부족한 채로 뜬 분산 학습 잡이 GPU를 붙들고 있는 상황을 minCount로 막을 수 있습니다. 다만 두 기능 모두 전제가 있습니다. 장치 격리는 DRA 드라이버가 깔려 있어야 하고, 그룹 배치는 피처 게이트를 열 수 있어야 합니다.
클러스터와 노드, 파드 단위로 GPU 사용 현황까지 함께 보고 싶다면 와탭 쿠버네티스 모니터링을 15일 무료로 체험해 보세요.
자주 묻는 질문
노드 테인트와 디바이스 테인트를 같이 걸면 어떻게 되나요?
두 테인트는 적용 범위가 다르며, 어느 하나만 통과한다고 배치되는 것은 아닙니다. 노드 테인트는 파드가 해당 노드에 배치될 수 있는지를 제한하고, 디바이스 테인트는 DRA 장치 할당 과정에서 쓸 수 있는 장치를 제한합니다. 장치 한 장만 제외하려는 경우에는 그 노드에 불필요한 노드 테인트가 남아 있지 않은지도 함께 봅니다.
풀의 장치를 전부 요청하는 파드는 테인트를 어떻게 처리하나요?
allocationMode: All로 풀의 장치를 모두 요청하면, 대상 장치 중 하나라도 허용되지 않은 테인트가 붙어 있으면 요청을 충족할 수 없습니다. 모든 장치의 테인트를 톨러레이션하거나 테인트가 없는 장치만 대상으로 요청하면 됩니다.
돌고 있는 잡을 당장 죽이지 않고 정리하려면 어떻게 하나요?
NoExecute가 적용되면 파드는 즉시 축출 대상이 됩니다. 실제 삭제 시점은 컨트롤러 처리와 톨러레이션 설정에 따라 달라질 수 있습니다. 유예가 필요하면 톨러레이션에 견딜 시간을 지정해 일정 시간 버티게 할 수 있고, 그 시간은 테인트가 장치에 붙은 시점부터 셉니다. 체크포인트를 남기고 빠질 시간을 벌어야 할 때 씁니다.
갱 스케줄링을 켜면 선점은 어떻게 동작하나요?
선점은 우선순위가 높은 워크로드를 위해 기존 파드를 내보내는 동작입니다. 워크로드 단위 선점(workload-aware preemption)은 새로 배치하려는 PodGroup을 하나의 선점 단위로 보고, minCount 조건을 충족할 수 있도록 클러스터 전체에서 밀어낼 대상을 계산합니다. 밀려나는 PodGroup의 파드를 개별적으로 내보낼지 그룹 전체를 함께 내보낼지는 disruptionMode에 따라 달라집니다. v1.37에서는 이 기능이 별도 게이트가 아니라 GenericWorkload 피처 게이트에 포함됐습니다.
참고 자료