담당자가 프로모션 코드를 발송해 드립니다.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
WhaTap AI를 경험해 보세요.
메트릭 카디널리티란, 모니터링 비용이 갑자기 뛰는 이유

모니터링이나 옵저버빌리티 문서를 읽다 보면 '고카디널리티를 주의하라'는 경고를 자주 마주칩니다. '카디널리티'라는 말부터 낯설고 뜻도 직관적으로 와닿지 않습니다.
카디널리티(cardinality)의 사전적 의미를 찾아보니 수학에서 '하나의 집합 안에 들어있는 원소의 개수(기수)'를 뜻하는 단어였습니다. 데이터베이스나 모니터링 분야에서 "라벨이나 필드에 들어갈 수 있는 값의 종류가 얼마나 다양한가?"를 나타내는 말로 쓰이고 있었습니다.
처음에는 단순히 "값의 종류가 많은 상태를 말하나 보다" 하고 넘어갔습니다. 하지만 서버를 늘리거나 트래픽이 급증한 것도 아닌데, 모니터링 비용이 크게 늘어날 수 있다는 설명은 쉽게 이해되지 않았습니다. 개발자가 코드에 무심코 추가한 라벨 하나가 시계열을 1억 5천만 개까지 불려 놓을 수 있는 구조였습니다.
그렇다면 카디널리티는 왜 덧셈이 아니라 곱셈으로 커지고, 그 곱셈은 어떻게 모니터링 비용으로 이어질까요?
메트릭 카디널리티란 무엇인가
메트릭 카디널리티(metric cardinality)는 메트릭 하나가 실제로 몇 개의 시계열로 저장되는지를 나타내는 값입니다. 시계열 개수는 라벨마다 나올 수 있는 값의 개수를 모두 곱한 값입니다.
여기서 시계열(time series)은 하나의 측정값이 시간 순서대로 쌓인 줄 하나를 뜻합니다. 모니터링 백엔드는 메트릭을 이 줄 단위로 저장하고 색인을 관리합니다. 그래서 줄이 늘어나면 수집·저장·조회에 드는 자원이 함께 늘어납니다. SaaS 제품에서는 활성 시계열 수나 커스텀 메트릭 수가 요금에 직접 반영되기도 하고, 직접 운영하는 프로메테우스라면 요금 대신 메모리와 디스크 사용량으로 나타납니다.
문제는 메트릭 하나가 줄 하나로 저장되지 않는다는 점입니다. http_requests_total 같은 메트릭에 요청 방식·응답 코드·엔드포인트를 라벨로 붙이면, 라벨 값의 조합마다 별도의 줄이 생깁니다. 라벨(label)은 메트릭에 붙이는 꼬리표이고, OpenTelemetry에서는 같은 개념을 속성(attribute)이라고 부릅니다.
라벨이 하나 늘면 시계열은 곱으로 늘어납니다
여기서 헷갈릴 수 있는 부분은 라벨을 하나 추가하는 비용이 덧셈이 아니라 곱셈이라는 점입니다. 요청 수를 세는 메트릭 하나에 라벨을 차례로 붙여 보면 이렇게 됩니다.
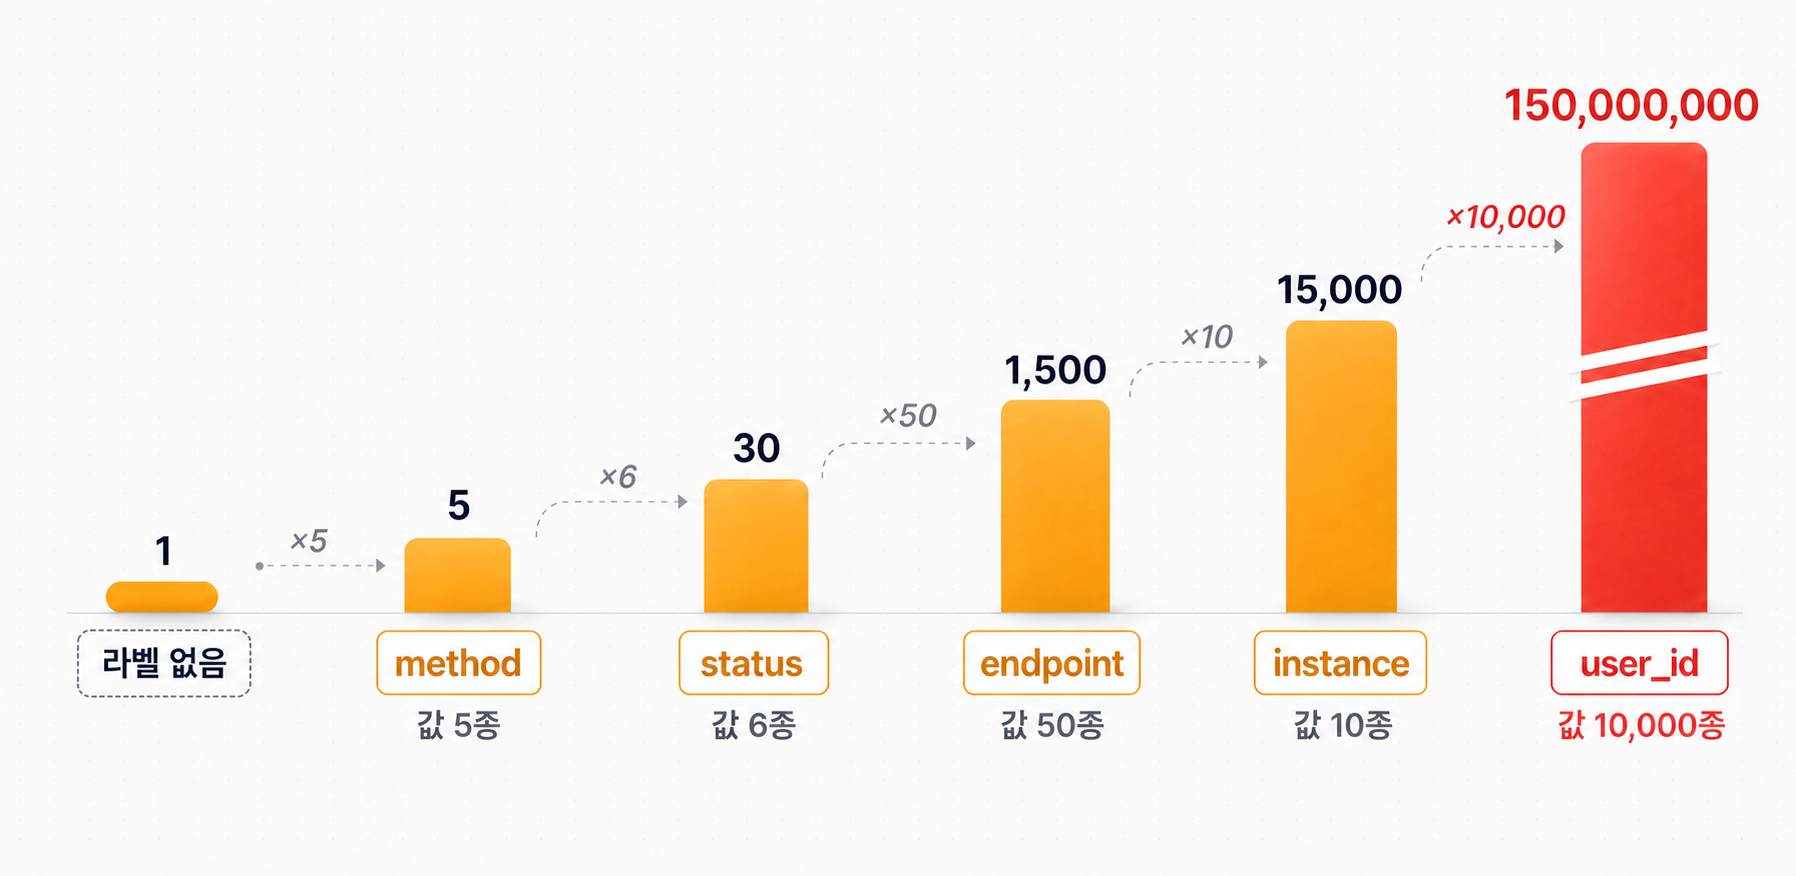
instance까지 붙인 단계에서도 메트릭 하나가 시계열 1만 5천 개입니다. 이 정도 규모는 저장소에 따라 무리 없이 다룰 수 있습니다.
user_id를 붙이는 순간 상황이 달라집니다. 사용자 ID 라벨 하나를 더했을 뿐인데 시계열이 1억 5천만 개가 됩니다. 라벨 하나의 값이 1만 종류면, user_id 앞까지 쌓인 조합 1만 5천 개가 각각 1만 배로 늘어나기 때문입니다.
다만 이 표는 모든 라벨 값이 서로 조합된다고 가정한 이론상 최대치입니다. 실제로는 관측된 조합만큼만 시계열이 생기기 때문에 이보다 적습니다. 그래도 user_id처럼 값이 계속 늘어나는 라벨은 트래픽이 쌓일수록 실제 조합 수도 함께 불어납니다.
곱셈에 끼어드는 요소가 하나 더 있습니다. 응답 시간처럼 값의 분포를 재는 메트릭에는 히스토그램(histogram)을 씁니다. 히스토그램은 값의 구간을 미리 나눠 두고 구간별로 개수를 세는데, 이 구간 하나하나를 버킷(bucket)이라고 부릅니다. 버킷마다 별도의 시계열이 생깁니다. 프로메테우스 계열에서는 버킷 경계마다 _bucket 시계열이 생기고 여기에 무한대 버킷과 _sum·_count가 더해지므로, 버킷을 20개로 잡으면 라벨 조합 하나가 시계열 23개가 됩니다. 앞의 라벨 조합 1,500개에 이 히스토그램을 쓰면 시계열은 3만 개를 넘습니다. 카디널리티를 볼 때 라벨 개수만 세고 버킷 수를 빼놓으면 계산이 크게 어긋납니다.
고카디널리티가 생기는 흔한 원인 두 가지
라벨 값의 종류가 지나치게 많은 상태를 고카디널리티(high cardinality)라고 부릅니다. 값이 많은 라벨이라고 해서 다 위험한 것은 아니고, 실제로 문제가 되는 라벨은 두 종류입니다.
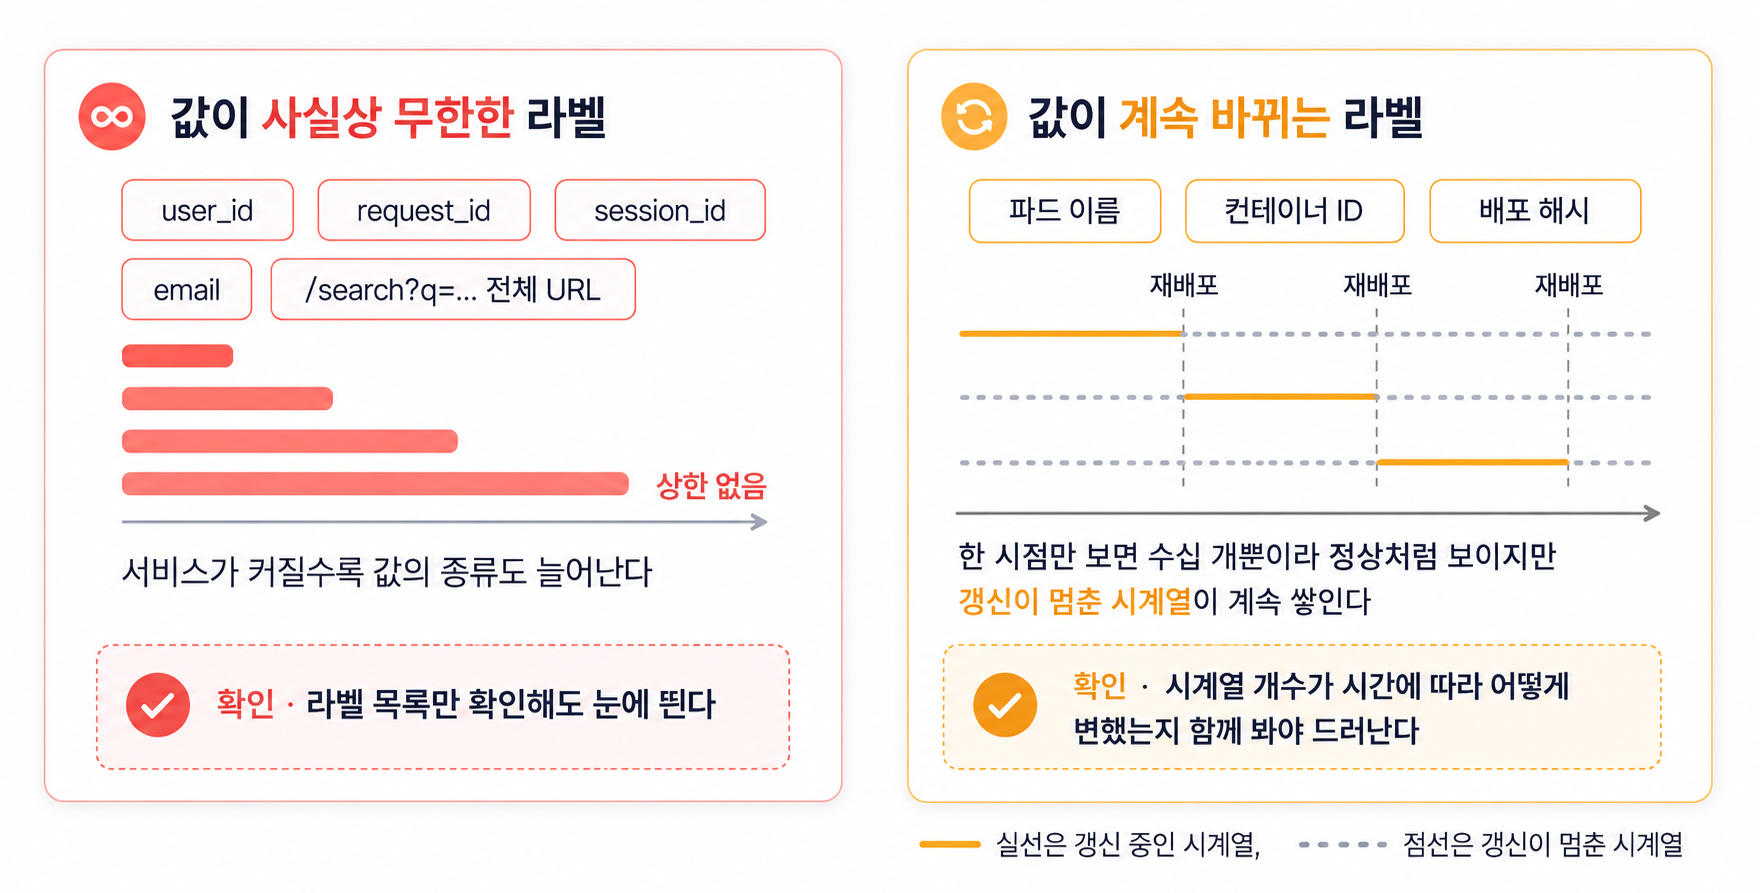
첫째, 값이 사실상 무한한 라벨입니다. 사용자 ID, 요청 ID, 세션 ID, 이메일 주소, 쿼리 문자열이 붙은 전체 URL 경로가 값이 무한한 라벨입니다. 이런 값은 서비스가 커질수록 종류가 함께 늘어나기 때문에 상한선이 없습니다. 타임스탬프를 라벨에 넣는 경우는 가장 극단적인 예로, 측정할 때마다 새 시계열이 생깁니다.
둘째, 값이 계속 바뀌는 라벨입니다. 파드(Pod, 쿠버네티스에서 컨테이너를 실행하는 단위) 이름, 컨테이너 ID, 배포 해시처럼 재배포마다 값이 달라지는 것들입니다. 어느 한 시점만 보면 값의 개수가 수십 개뿐이라 안전해 보입니다. 하지만 파드가 종료되고 새로 뜰 때마다 이전 이름의 시계열은 남고 새 이름의 시계열이 추가됩니다. 배포가 잦은 환경에서는 시간이 지날수록 더 이상 갱신되지 않는 시계열이 계속 쌓입니다.
이처럼 짧은 수명의 시계열이 계속 생겨나고 금세 갱신이 멈추는 현상을 시계열 처닝(series churn)이라고 합니다. 현재 활성 시계열 수가 크게 보이지 않더라도, 일정 기간 새로 생성된 시계열이 많으면 색인과 저장소에 부담을 줄 수 있습니다.
두 유형을 구분해야 하는 이유는 확인 방법이 다르기 때문입니다. 첫째 유형은 라벨 목록만 확인해도 눈에 띄지만, 둘째 유형은 한 시점의 카디널리티 값만으로는 드러나지 않습니다. 시간에 따라 시계열 개수가 어떻게 변해 왔는지를 함께 봐야 확인할 수 있습니다.
OpenTelemetry는 카디널리티를 어떻게 제한하나
카디널리티를 완전히 막을 방법은 없습니다. 그래서 OpenTelemetry는 카디널리티를 막는 대신 메트릭마다 상한을 두는 방식을 택했습니다.
OpenTelemetry Metrics SDK 명세는 따로 설정하지 않았을 때 쓸 기본 한도로 2,000을 권고합니다. 이 값은 메트릭 하나가 한 번의 수집 주기에 내보낼 수 있는 데이터 포인트 개수이지, 메트릭 하나가 평생 가질 수 있는 시계열 개수가 아닙니다. 한도를 넘긴 측정값은 버리지 않고 오버플로(overflow, 한도 초과분을 모아 두는 항목)를 뜻하는 otel.metric.overflow 속성이 true인 데이터 포인트 하나로 묶어서 집계합니다. 명세는 모든 측정값이 정확히 하나의 집계 대상에 반영되어야 한다고 규정합니다.
명세 원문을 확인해 보니 SDK가 이 한도를 지원하도록 권고할 뿐이고, 의무로 두지는 않습니다. 그래서 쓰는 SDK와 설정에 따라 적용 여부가 다르고, 이미 백엔드에 쌓인 메트릭의 카디널리티를 줄여 주는 기능도 아닙니다.
측정값을 버리는 방식이라면 한도를 넘긴 순간부터 총합이 틀어지지만, 하나로 묶는 방식에서는 세부 구분만 사라지고 전체 합계는 유지됩니다. 예를 들어 오버플로가 발생한 뒤에도 전체 요청 수는 맞게 나오고, 다만 그 요청들이 어느 엔드포인트에서 왔는지를 구분할 수 없습니다.
한도에 걸렸다는 사실 자체가 신호이기도 합니다. 특정 메트릭에서 오버플로 항목이 보이기 시작하면, 그 메트릭에 붙은 라벨 하나가 예상보다 많은 값을 가진다는 뜻입니다.
자주 묻는 질문
대시보드가 느려졌는데 카디널리티 때문일까요
카디널리티가 높아지면 저장 용량보다 조회 속도에서 먼저 티가 나는 경우가 많습니다. 시계열이 많아지면 색인도 함께 커지고, 특정 라벨 조합을 찾을 때 확인해야 할 범위가 넓어지기 때문입니다. 대시보드를 열 때 특정 그래프만 유독 오래 걸리거나, 조회 범위를 한 달로 넓혔을 때 시간 초과가 나기 시작한다면 카디널리티를 의심해 볼 만합니다.
쿼리에서 sum(rate(http_requests_total[5m])) by (instance)처럼 라벨을 묶어 조회하면 부담이 줄 것 같지만, 저장소는 합산하기 전에 조건에 맞는 원본 시계열을 모두 읽어야 합니다. 조회할 때 묶는 방식만으로는 고카디널리티의 부담이 사라지지 않습니다.
수집 단계의 부하는 조회보다 늦게 드러나는 경우가 많지만, 수집 주기마다 처리할 시계열이 한꺼번에 몰리는 환경에서는 수집 쪽이 먼저 흔들리기도 합니다.
문제가 되는 라벨을 지우면 과거 데이터는 어떻게 되나요
이미 저장된 시계열은 그대로 남습니다. 라벨을 제거한 시점부터 새 시계열에 값이 쌓이고, 예전 시계열은 더 이상 갱신되지 않은 채 보존 기간이 끝날 때까지 자리를 차지합니다.
비용에 반영되는 시점은 과금 방식에 따라 다릅니다. 저장 용량으로 매기는 방식이라면 보존 기간이 지나야 줄어듭니다. 활성 시계열 수로 매기는 방식이라면 갱신이 멈춘 시계열이 집계에서 빠지면서 더 일찍 반영됩니다. 쓰는 백엔드의 과금 기준을 먼저 확인해야 조치가 효과 없었다고 오해하지 않습니다.
로그나 트레이스에도 카디널리티 문제가 있나요
개념은 있지만 비용 구조가 다릅니다. 메트릭은 라벨 조합마다 별도의 줄을 계속 유지해야 해서 곱셈이 그대로 저장 비용이 됩니다. 반면 로그와 트레이스는 개별 기록이 쌓이는 방식이라 비용이 대체로 양에 비례합니다. 고유한 값을 담는다는 이유로 로그를 피할 필요는 없습니다. 프로메테우스 공식 문서는 사용자 ID나 이메일 주소처럼 값의 범위가 정해지지 않은 정보를 라벨에 담지 말라고 안내합니다. 값의 종류가 많은 정보라면 메트릭 라벨보다 로그나 트레이스에 남기는 방법을 검토할 수 있습니다.
다만 로그도 완전히 자유롭지는 않습니다. 로그 필드나 트레이스 속성을 검색·집계용 색인으로 잡으면 거기서도 색인 비용이 따로 생깁니다. 저장만 할 필드와 색인할 필드를 구분해 두는 편이 안전합니다.
얼마부터가 높은 카디널리티인가요
절대 기준은 없습니다. 쓰는 백엔드(프로메테우스 등 메트릭 저장소)와 예산에 따라 감당할 수 있는 규모가 다르기 때문입니다. 다만 참고할 숫자는 있습니다. 프로메테우스 공식 문서는 경험 법칙으로 메트릭 하나의 카디널리티를 10 아래로 두라고 제시하고, 100을 넘거나 그만큼 커질 여지가 있으면 라벨 개수를 줄이거나 분석을 모니터링 밖으로 옮기는 등 다른 방법을 검토하라고 안내합니다.
앞에서 본 OpenTelemetry의 2,000은 성격이 다른 숫자입니다. 그 값은 SDK가 폭증을 막으려고 두는 안전장치의 기본값이라, 우리 백엔드가 감당할 수 있는 규모와는 따로 봐야 합니다. 결국 메트릭별 시계열 개수를 주기적으로 확인해 어느 메트릭이 유독 큰지 순위를 보는 방법이 실용적입니다.
마치며
카디널리티라는 말을 처음 봤을 때는 값의 종류가 많다는 뜻으로만 읽었습니다. 정리하고 보니 메트릭 카디널리티는 라벨 조합에 따라 만들어지는 시계열의 개수이고, 라벨을 하나 더할 때마다 시계열은 곱으로 늘어납니다. 값이 사실상 무한한 라벨과 값이 계속 바뀌는 라벨을 구분해 두면, 모니터링 비용이 늘어난 원인을 찾기가 한결 수월해집니다.
모니터링 비용이나 시계열 수가 갑자기 늘었다면 먼저 메트릭별 시계열 수를 비교해 보세요. 상위 메트릭에서 user_id, request_id, 전체 URL처럼 값이 많거나, 파드 이름처럼 계속 바뀌는 라벨이 있는지 확인합니다. 히스토그램 메트릭이라면 라벨뿐 아니라 버킷 수도 함께 살펴봐야 합니다. 관측 비용 시리즈의 다음 편에서는 이렇게 찾은 고카디널리티 메트릭을 실제로 줄이는 방법을 다룹니다.
와탭에서도 OpenMetrics 규격으로 수집한 메트릭을 탐색기에서 조회할 수 있고, 지표별 카디널리티를 직접 계산하는 방법은 공식 문서에 정리되어 있습니다.
더 읽을거리
- 모니터링 비용을 수집 단에서 줄이는 법 (관측 비용 시리즈 2편 · 와탭 블로그)
- OpenMetrics 카디널리티 (와탭 공식 문서)
- OpenMetrics (와탭 공식 문서)
- Metrics (opentelemetry.io)
- Metrics SDK, Cardinality limits (opentelemetry.io 명세)
- Metric and label naming (prometheus.io)
- Instrumentation best practices (prometheus.io)
- OpenMetrics, Prometheus, OpenTelemetry 차이와 관계 한눈에 정리 (와탭 블로그)