담당자가 프로모션 코드를 발송해 드립니다.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
WhaTap AI를 경험해 보세요.
Java GC 로그 보는 법, GC 일시정지로 응답 지연 원인 찾기
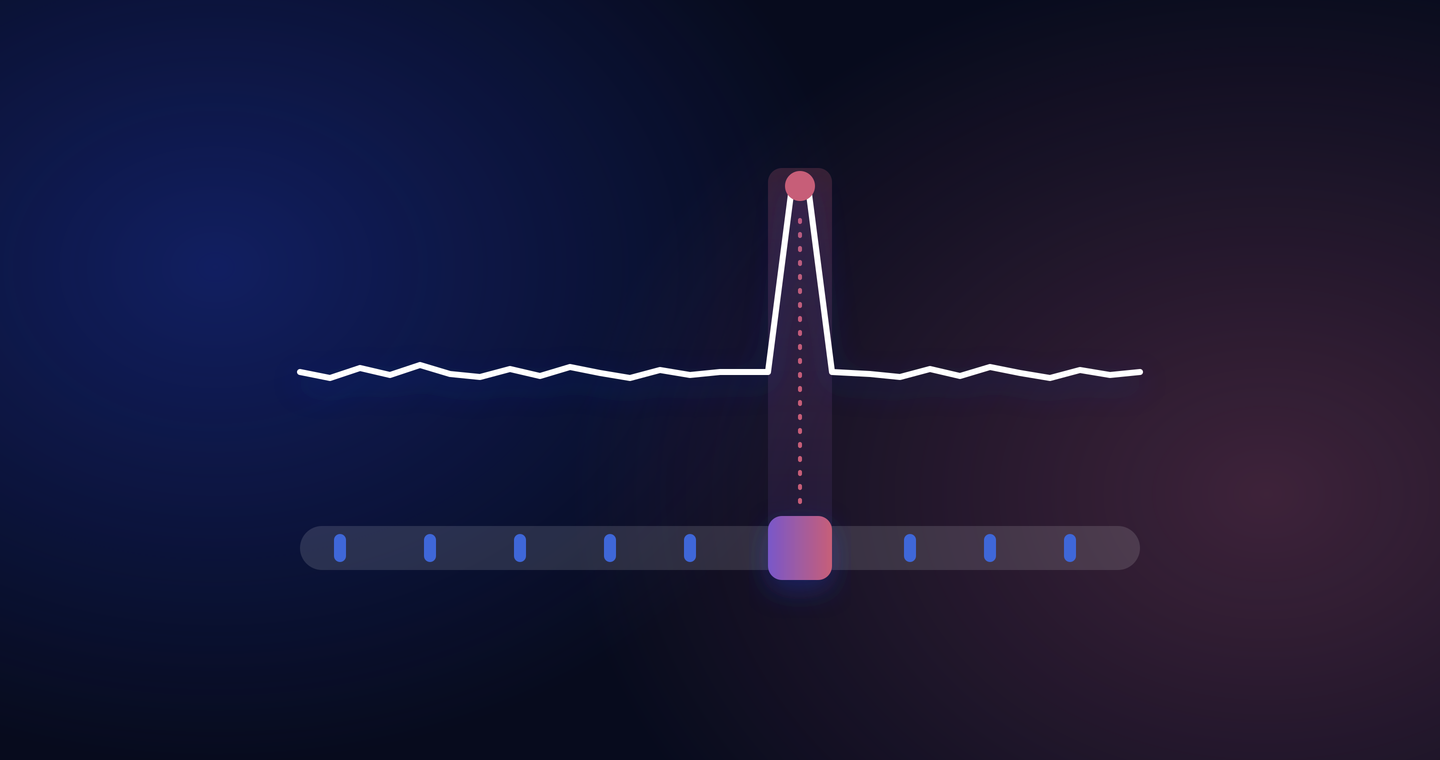
Java로 만든 API 서버의 응답시간이 평소에는 수십 밀리초를 유지하다가, 몇 분에 한 번씩 1초 이상으로 치솟습니다. 응답시간 그래프에는 짧고 뾰족하게 솟은 구간이 나타났다가 금세 사라집니다. 최근 배포도 없었고, 트래픽도 평소와 다르지 않습니다.
이럴 때 확인해 볼 원인 가운데 하나가 GC(가비지 컬렉션)입니다. GC는 프로그램이 더 이상 쓰지 않는 객체를 JVM(Java 프로그램을 실행하는 가상 머신)이 자동으로 찾아 메모리를 회수하는 작업입니다.
GC가 실행되는 동안에는 애플리케이션이 잠시 멈출 수 있습니다. JVM은 GC가 객체를 옮기거나 메모리를 정리하는 일부 단계에서 애플리케이션을 멈춥니다. GC가 다루는 객체를 애플리케이션이 그사이에 바꾸지 못하게 막으려는 것입니다. JVM이 애플리케이션 스레드를 모두 멈추는 GC 일시정지를 stop-the-world라고 부릅니다.
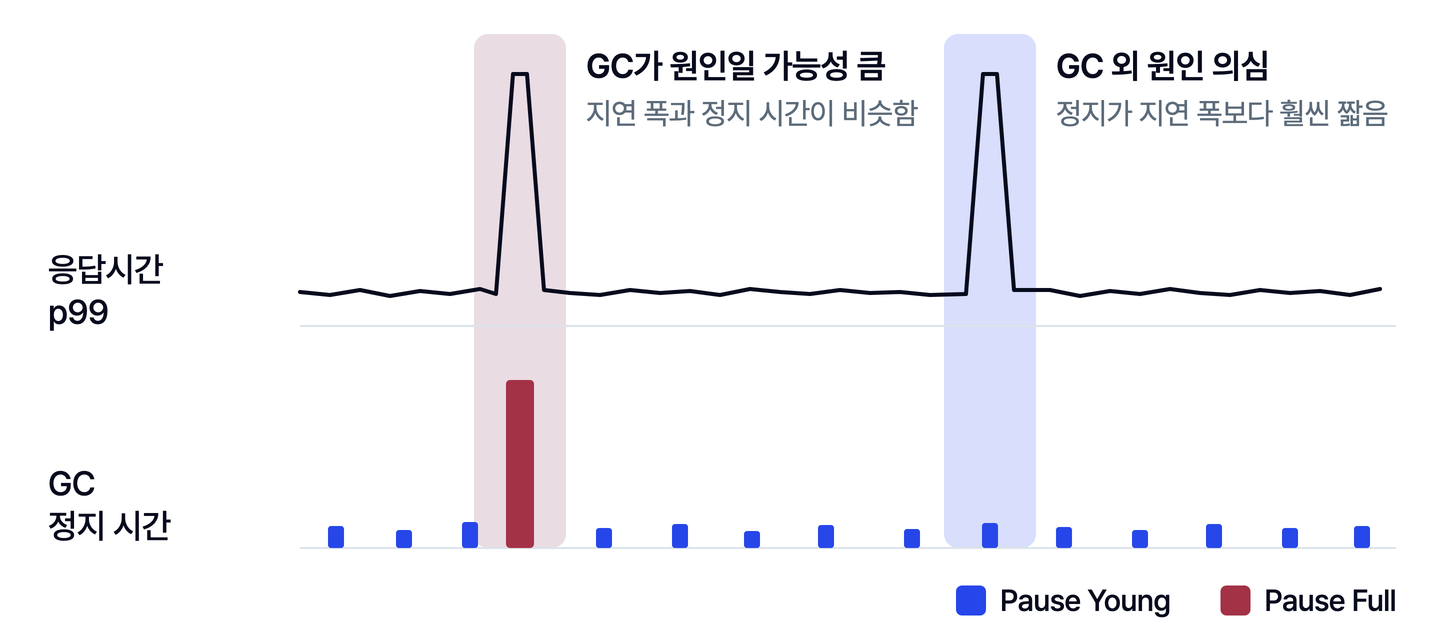
요청을 처리하던 중에 stop-the-world가 일어나면 해당 요청은 정지가 끝날 때까지 기다립니다. 정지에 걸리는 요청은 전체의 일부라서 평균 응답시간에는 큰 변화가 없더라도, p99(전체 요청의 99%가 그보다 빨리 끝나는 응답시간)에는 지연이 뚜렷하게 나타납니다.
다만 응답시간이 순간적으로 늘었다고 해서 GC를 원인으로 단정할 수는 없습니다. 응답시간이 늘어난 시각에 GC가 실제로 일어났는지, 애플리케이션이 얼마나 오래 멈췄는지 확인합니다.
GC 로그에는 GC가 일어난 시각과 종류, 애플리케이션이 멈춘 시간, GC 전후의 힙 사용량이 GC마다 요약 줄 하나에 남습니다. GC 로그의 정지 시각을 응답시간 그래프에서 지연이 나타난 시각과 맞춰 보면, GC가 지연에 영향을 주었는지 판단할 수 있습니다.
관찰한 현상에 따라 먼저 확인할 것은 아래와 같습니다. 각 항목을 확인하는 방법은 이어지는 절에서 다룹니다.
GC가 의심될 때 먼저 실행할 명령
응답 지연이 GC 때문인지 확인하려면, GC 로그를 열기 전에 JVM에서 GC가 얼마나 자주 일어나고 시간을 얼마나 쓰는지부터 봅니다. GC가 자주 일어나거나 시간을 많이 쓴다면 GC 로그를 자세히 분석할 이유가 생기고, 거의 일어나지 않는다면 다른 원인을 먼저 찾는 편이 빠릅니다. 실행 중인 Java 프로그램의 PID(운영체제가 실행 중인 프로세스마다 붙이는 번호)를 찾고, GC 종류와 메모리 상태를 확인하는 다섯 명령을 차례로 실행합니다. JDK 11 이상 HotSpot JVM 기준이며, jcmd와 jstat은 JDK에 포함된 도구라 JRE만 설치된 이미지에는 없을 수 있습니다. 두 도구 모두 JVM을 실행한 것과 같은 계정으로 실행해야 대상 JVM에 연결됩니다.
jcmd -l                        # 실행 중인 JVM 목록과 PID
jcmd <PID> VM.flags            # 사용 중인 GC 종류, 힙 최대 크기
jstat -gcutil <PID> 1000       # 1초마다 영역별 사용률, GC 횟수와 누적 시간
jcmd <PID> GC.heap_info        # 지금 힙이 얼마나 찼는지
jcmd <PID> VM.log list         # GC 로그가 켜져 있는지, 어디에 쓰는지
명령 결과를 읽으려면 힙의 구조를 알아야 합니다. 힙(heap)은 Java 프로그램이 만든 객체를 저장하는 메모리 공간입니다. 새로 만든 객체는 주로 Young 영역에 저장됩니다. GC가 지나간 뒤에도 프로그램이 계속 쓰고 있어 회수되지 않은 객체를 살아남은 객체라고 부르고, 여러 번의 GC 뒤에도 살아남아 오래 쓰이는 객체는 Old 영역으로 옮겨집니다. Young GC는 새 객체가 많은 Young 영역을 중심으로 메모리를 회수하고, Full GC는 힙 전체를 대상으로 메모리를 정리합니다. G1 GC에는 Young 영역과 일부 Old 영역을 함께 회수하는 Mixed GC도 있습니다. 대부분의 객체는 만들어진 뒤 금방 쓸모가 없어지므로 Young GC는 자주 일어나도 정지가 짧고, Full GC는 드물지만 정지가 깁니다.
VM.flags 출력에 -XX:+UseG1GC가 있으면 G1 GC, -XX:+UseParallelGC면 Parallel GC입니다. 결과를 가장 먼저 볼 명령은 jstat -gcutil입니다. 1초마다 영역별 사용률과 GC 횟수, 누적 시간이 한 줄씩 찍힙니다.
E는 Young 영역에서 새 객체가 처음 저장되는 공간(Eden)의 사용률(%), O는 Old 영역 사용률(%), YGC와 FGC는 Young GC와 Full GC 누적 횟수, GCT는 GC에 쓴 누적 시간(초)입니다. 예를 들어 한 줄에서 다음 줄로 넘어가며 YGC가 120에서 121로 늘고 E가 68.75%에서 5.26%로 내려갔다면, 그 1초 사이에 Young GC가 한 번 일어나 Eden을 비운 것입니다. 같은 1초에 GCT가 3.212초에서 3.237초로 늘었다면 GC에 쓴 시간은 25ms입니다.
GCT 증가분이 곧 정지 한 번의 길이는 아닙니다. 1초 동안 GCT가 0.1초 늘었다면 100ms 정지가 한 번 있었을 수도 있고, 20ms 정지가 다섯 번 있었을 수도 있습니다. 그래서 GCT 증가분은 GC 부담을 가늠하는 값으로 쓰고, 정지마다의 시각과 길이는 GC 로그에서 따로 확인합니다.
jstat -gcutil 결과에 따라 다음에 볼 것은 아래와 같습니다. Full GC 없이 YGC만 조금씩 늘어나는 앞의 예시는 표의 첫 번째 상황에 해당합니다.
FGC 값은 GC 종류와 JDK 버전에 따라 집계 기준이 조금씩 다릅니다. Full GC가 실제로 일어났는지는 GC 로그의 Pause Full 줄로 최종 확인합니다. VM.log list 결과에 gc 태그가 담긴 출력이 없다면 GC 로그가 꺼져 있으므로, 다음 절의 방법으로 먼저 켭니다.
Java GC 로그 켜는 법과 읽는 법, Pause Young과 Pause Full
GC 로그를 켜는 옵션은 JDK 9를 기준으로 완전히 바뀌었습니다. JDK 9부터는 JVM의 모든 로그를 하나의 체계로 다루는 통합 로깅(JEP 158, 271)이 들어왔고, GC 로그도 -Xlog 옵션 하나로 설정합니다.
JDK 9 이상, -Xlog로 켜기
java -Xlog:gc*:file=/var/log/app/gc.log:time,uptime,level,tags:filecount=5,filesize=20M -jar app.jar
콜론으로 나뉜 네 부분은 차례로 기록 대상, 출력 위치, 줄 앞에 붙일 정보, 로그 로테이션 규칙입니다. gc*는 gc 태그가 들어간 모든 태그 조합을 남기라는 뜻이라 정지 단계별 시간과 힙 변화, CPU 시간까지 함께 기록됩니다. 줄 앞 정보(데코레이터)에 time을 넣어야 실제 시각이 찍혀서 액세스 로그나 모니터링 그래프와 시각을 맞출 수 있습니다. 기본 데코레이터는 JVM 기동 후 경과 시간과 로그 레벨, 태그뿐이라 실제 시각이 남지 않습니다. 기록 양은 GC 빈도에 비례하므로 filecount와 filesize로 디스크 사용량에 상한을 둡니다.
로그를 쓸 디렉터리는 미리 만들어 두고, JVM을 실행하는 계정에 쓰기 권한이 있는지 확인합니다. 로그 파일을 열지 못하면 JVM이 시작되지 않을 수 있습니다. 컨테이너에서는 컨테이너가 다시 만들어지면 파일이 사라지므로 볼륨에 쓰고, 파일 수와 크기를 컨테이너 디스크 용량에 맞춥니다.
이미 실행 중인 JVM이라면 재시작 없이 jcmd로 켤 수 있습니다. 셸이 별표를 파일 이름으로 해석하지 않도록 따옴표로 감쌉니다.
jcmd <PID> VM.log output=/tmp/gc.log what='gc*' decorators=time,uptime,level,tags
jcmd로 켠 설정은 JVM이 재시작되면 사라지므로, 원인을 확인한 뒤 같은 내용을 JVM 옵션으로 옮겨 둡니다.
JDK 8, PrintGCDetails로 켜기
java -XX:+PrintGCDetails -XX:+PrintGCDateStamps -Xloggc:/var/log/app/gc.log \
     -XX:+UseGCLogFileRotation -XX:NumberOfGCLogFiles=5 -XX:GCLogFileSize=20M -jar app.jar
JDK 8 옵션을 그대로 둔 채 JDK 11 이상으로 올리면 주의해야 합니다. -XX:+PrintGCDateStamps나 -XX:+UseGCLogFileRotation 같은 옵션은 인식되지 않아 Unrecognized VM option 오류와 함께 JVM이 시작되지 않습니다. 오라클 java 명령 문서의 변환표에 따르면 -XX:+PrintGCDetails는 -Xlog:gc*에 해당하고, 날짜 표시와 로그 로테이션은 통합 로깅에서 데코레이터와 출력 옵션으로 설정합니다.
사용 중인 GC 종류 확인하기
같은 GC 로그라도 GC 종류에 따라 줄 모양이 다릅니다. -Xlog:gc를 켜면 JVM이 시작할 때 Using G1 같은 줄을 남기고, 실행 중이라면 앞의 jcmd VM.flags 명령으로 확인합니다.
GC를 따로 지정하지 않았다면 JDK 9 이상은 대부분의 환경에서 G1 GC를, JDK 8은 Parallel GC를 씁니다. JDK 27에서 바뀐 기본 GC는 자주 묻는 질문에서 다룹니다.
GC 로그 한 줄 읽는 법
JDK 17 이상에서 G1 GC를 쓰고 앞의 -Xlog 설정으로 남긴 로그는 아래와 같은 모양입니다.
[2026-10-07T14:03:21.538+0900][8123.428s][info][gc          ] GC(1841) Pause Young (Normal) (G1 Evacuation Pause) 1530M->412M(2048M) 25.913ms
[2026-10-07T14:03:21.538+0900][8123.428s][info][gc,cpu      ] GC(1841) User=0.18s Sys=0.01s Real=0.03s
[2026-10-07T14:07:02.104+0900][8343.994s][info][gc          ] GC(1907) Pause Full (G1 Compaction Pause) 2040M->1986M(2048M) 1843.227ms
첫 줄을 앞에서부터 나눠 보면 다음과 같습니다.
두 번째 괄호에는 GC를 시작한 이유가 찍힙니다. G1 Evacuation Pause가 가장 흔하고, 같은 괄호에 큰 객체를 할당하다 시작된 G1 Humongous Allocation이나 코드에서 직접 호출한 System.gc()가 찍히기도 합니다. 괄호 속 2048M은 JVM이 그 시점에 확보해 둔 힙 용량이라, -Xmx로 정한 최대 힙 크기와 다를 수 있습니다. 최대 힙 크기는 VM.flags 출력의 -XX:MaxHeapSize로 확인합니다.
Pause Young은 Young 영역만 회수하는 Young GC의 정지이고, 정지 시간은 대개 짧습니다. G1은 GC 한 번의 정지를 기본 200ms(-XX:MaxGCPauseMillis) 안으로 맞추는 것을 목표로 하지만, 목표값일 뿐이라 실제 정지가 200ms를 넘을 수 있습니다. G1은 애플리케이션을 멈추지 않은 채 아직 쓰이는 객체를 찾아 표시하는 동시 마킹을 진행합니다. Pause Remark와 Pause Cleanup은 동시 마킹 중간에 들어가는 정지이고, 마찬가지로 짧은 편입니다.
Pause Full은 힙 전체를 한꺼번에 정리하는 Full GC입니다. 오라클 G1 튜닝 가이드는 G1이 회수가 할당 속도를 따라가지 못할 때 대비책으로 Full GC를 수행한다고 설명합니다. 세 번째 줄처럼 정지 시간이 초 단위로 길어지기 쉽고, 2040M에서 1986M로 회수량이 54MB에 그쳤다는 것은 힙 대부분이 아직 살아 있는 객체로 차 있다는 뜻입니다. G1을 쓰는 서비스라면 Pause Full이 한 번만 보여도 원인부터 확인합니다.
두 번째 줄의 User와 Sys는 GC가 쓴 CPU 시간이고, Real은 실제로 흐른 시간입니다. GC 스레드 여러 개가 동시에 일하면 User가 Real보다 클 수 있습니다. 반대로 Real이 User와 Sys의 합보다 훨씬 길다면 GC 스레드가 CPU를 충분히 받지 못했을 수 있으므로, 서버 CPU 사용률이나 컨테이너의 CPU 제한을 확인합니다.
JDK 8의 Parallel GC 로그는 형식이 다르지만 읽는 순서는 같습니다.
2026-10-07T14:03:21.512+0900: 8123.402: [GC (Allocation Failure) [PSYoungGen: 524288K->43520K(611840K)] 1566720K->1085952K(2010112K), 0.0412345 secs] [Times: user=0.15 sys=0.01, real=0.04 secs]
시각 뒤에 [GC가 오면 Young GC이고, [Full GC가 오면 Full GC입니다. 괄호 안은 GC를 시작한 원인입니다. PSYoungGen 대괄호 안의 화살표 앞뒤는 Young 영역의 회수 전후 사용량이고, 그 바깥 화살표 앞뒤가 힙 전체의 회수 전후 사용량입니다. secs 앞 숫자가 정지 시간(초)입니다.
GC 일시정지가 응답 지연의 원인인지 판정하기
GC 정지 시각과 응답 지연 시각 맞춰 보기
먼저 응답시간이 튄 시각을 액세스 로그나 모니터링 그래프에서 확인합니다. 그다음 GC 로그에서 정지 시간이 100ms 이상인 줄만 뽑아 시각을 비교합니다. 기준값 100은 서비스 응답 목표에 맞게 바꿔 씁니다.
grep -hE '\[gc *\].*Pause' gc.log* |
awk '$NF ~ /^[0-9]+(\.[0-9]+)?ms$/ { ms=$NF; sub(/ms$/, "", ms); if (ms+0 >= 100) print }' | sort
grep은 로테이션된 파일까지 포함한 GC 로그에서 Pause가 들어간 gc 태그 줄만 고르고, awk는 줄 맨 끝 칸이 ms 형식인 줄 가운데 정지 시간이 100 이상인 줄만 출력합니다. JDK 9 이상 통합 로깅에서 정지 시간이 줄 끝에 찍히는 형식을 기준으로 한 명령이라, JDK 8 로그처럼 형식이 다른 로그에는 맞지 않습니다. 마지막의 sort는 여러 파일에서 뽑은 줄을 시각 순서로 정렬합니다.
로그에 찍힌 시각은 GC가 끝난 시각이므로, 정지 시작 시각은 끝난 시각에서 정지 시간을 빼서 구합니다. 예를 들어 14:07:02.104에 끝난 1843.227ms(약 1.8초) 정지는 14:07:00.261에 시작했습니다.
오후 2시 7분에 API 응답시간이 평소 100ms에서 2초로 늘었다고 가정합니다. GC 로그에서 14:07:00.261부터 14:07:02.104까지 이어진 Pause Full을 찾았다면, 느려진 요청의 처리 구간이 이 정지 구간과 겹치는지 확인합니다. 요청이 정지 구간 대부분에 걸쳐 있었다면 2초 지연 가운데 약 1.8초를 GC 정지로 설명할 수 있습니다. 정지가 끝나기 직전에 시작한 요청은 그만큼 영향을 덜 받습니다.
반대로 요청 처리 중에 걸린 정지가 30ms 안팎뿐이라면 2초 지연을 GC 정지로 설명하기 어려우므로, 나머지 원인을 GC 밖에서 찾습니다. 액세스 로그에 요청 시작 시각과 처리 시간이 남아 있다면, 요청 구간과 정지 구간을 같은 시간축에 놓고 비교하는 방법이 가장 정확합니다. 응답 지연이 여러 번 있었다면 지연 시각마다 같은 비교를 반복해, 긴 정지가 지연과 매번 함께 나타나는지 확인합니다.
다만 동시 마킹처럼 애플리케이션을 멈추지 않는 GC 작업도 CPU를 나눠 쓰므로, 코어가 적은 서버에서는 정지 줄이 없어도 GC 때문에 처리가 느려질 수 있습니다.
Full GC 반복, 힙 부족, 메모리 누수를 의심하는 신호
Full GC 반복의 흔한 원인은 힙 부족과 메모리 누수입니다. 메모리 누수는 프로그램이 더 이상 필요하지 않은 객체를 계속 참조해서 GC가 해당 메모리를 회수하지 못하는 상황입니다. 힙 부족은 프로그램에 실제로 필요한 객체가 많아 현재 힙 크기로는 공간이 모자란 상황입니다. 두 경우 모두 GC 뒤에도 힙이 많이 비워지지 않아서 Full GC가 반복됩니다.
GC 로그에서 아래 모양이 보이면 정지 시간보다 힙 상태부터 확인합니다.
회수 후 힙(로그의 화살표 오른쪽 값)의 추이는 힙 부족과 메모리 누수를 가려내는 첫 단서입니다. 트래픽이 늘 때 함께 오르다가 트래픽이 줄면 내려오거나 일정 수준에서 멈춘다면, 작업량에 비해 힙이 작은 경우에 가깝습니다. 트래픽이 일정한데도 몇 시간, 며칠에 걸쳐 계속 오른다면 누수를 의심합니다. 다만 캐시가 커지는 것처럼 정상 동작에서도 같은 모양이 나올 수 있고, 아주 느린 누수는 짧은 관찰 구간에서 드러나지 않습니다. 회수 후 힙의 추이만으로 누수를 확정하지 않고, 클래스 히스토그램과 힙 덤프로 확인합니다.
Evacuation Failure는 G1에서 Full GC 직전에 나타나는 경우가 많으므로, 이 표시가 잦다면 Full GC가 가까워진 상태로 봅니다. 표시 방식은 JDK 버전에 따라 다릅니다. JDK 17 이하에서는 같은 GC 번호로 To-space exhausted라는 줄이 따로 찍히고, JDK 18부터 21까지는 (Evacuation Failure), JDK 22 이상에서는 (Evacuation Failure: Allocation)처럼 Pause Young 줄 끝에 붙습니다.
누수가 의심되면 클래스별 객체 수와 크기를 10분에서 30분 간격으로 두 번 뽑아, 계속 늘어나는 클래스를 찾습니다. 늘어나는 클래스는 누수 후보를 좁히는 단서입니다. 늘어나는 클래스의 객체를 어떤 객체가 계속 참조하고 있는지는 힙 덤프에서 참조 경로를 분석해야 알 수 있습니다.
jcmd <PID> GC.class_histogram | head -20
jcmd <PID> GC.heap_dump /data/dump/app.hprof
두 명령 모두 오라클 문서가 영향도를 High로 분류한 무거운 작업이고, 기본 설정에서는 실행 전에 Full GC를 일으킵니다. 이때의 Full GC는 GC 로그에 Pause Full (Heap Inspection Initiated GC)나 Pause Full (Heap Dump Initiated GC)로 남으므로, 장애 분석에서 따로 구분합니다. head -20은 출력만 줄일 뿐 히스토그램을 만드는 작업량은 그대로입니다. 힙이 클수록 실행 중 정지가 길어지고, 힙 덤프는 사용 중인 힙에 가까운 크기만큼 디스크를 씁니다. 트래픽이 적은 시간에 실행하거나, 부하 분산에서 한 대를 뺀 뒤 실행합니다. 메모리 부족으로 JVM이 종료되는 상황에 대비하려면 -XX:+HeapDumpOnOutOfMemoryError와 -XX:HeapDumpPath를 미리 설정해 둡니다.
GC는 정상인데 응답이 느릴 때
GCT 증가가 작고 지연을 설명할 만한 긴 정지 줄도 없다면, GC 밖의 원인을 아래 순서로 확인합니다.
- GC가 아닌 JVM 정지: JVM은 GC 외에도 스레드 덤프나 코드 최적화 해제 같은 작업을 위해 모든 스레드를 멈춥니다.
-Xlog:safepoint를 켜면 GC를 포함한 전체 정지 시간이 남습니다. - 스레드 대기:
jcmd <PID> Thread.print로 스레드 덤프를 떠서 BLOCKED 상태나 같은 잠금을 기다리는 스레드가 몰려 있는지 봅니다. - 외부 대기: 데이터베이스 쿼리, 외부 API 호출, 커넥션 풀 대기는 JVM 지표에 드러나지 않습니다. 요청 경로를 구간별로 나눠 보는 순서는 API 응답 시간이 느린 이유 7가지와 진단 순서에서 다룹니다.
컨테이너에서 실행 중이고 gc,cpu 줄의 Real이 User와 Sys의 합보다 크게 나온다면, CPU 제한에 걸려 GC 스레드까지 대기했을 수 있습니다. 컨테이너 CPU 스로틀링을 확인하는 방법은 리눅스 CPU 사용률이 높은 이유와 확인 방법에 정리돼 있습니다.
마치며
응답 지연이 생길 때마다 느려진 요청의 처리 구간과 GC 정지 구간을 맞춰 봅니다. 긴 정지가 매번 겹친다면 힙 상태와 Full GC 원인을 살피고, 겹치지 않는다면 GC 밖에서 원인을 찾습니다.
GC 로그와 jstat은 JVM 한 대씩 들여다보는 도구라, 서버가 여러 대면 로그를 모아 시각을 맞추는 일부터 번거로워집니다. 와탭 Java 모니터링에서는 트랜잭션 응답 시간을 히트맵으로 보면서 응답이 늦은 트랜잭션이 몰린 시각을 찾고, 같은 시각의 GC 수행 시간과 힙 사용량을 인스턴스별 5초 간격 메트릭으로 확인할 수 있습니다. 화면 구성은 히트맵 분석 (와탭 공식 문서), 수집 항목은 애플리케이션 메트릭 (와탭 공식 문서)에서 확인할 수 있습니다.
자주 묻는 질문
GC 로그를 운영 서버에 항상 켜 둬도 되나요?
GC 로그는 운영 서버에서도 상시로 켜 둘 수 있습니다. 문제가 된 시각의 로그가 없으면 같은 증상이 다시 나타날 때까지 기다려야 하므로, 켜 두는 편이 대응이 빠릅니다. 다만 -Xlog:gc*는 GC 요약 줄뿐 아니라 단계별 시간 같은 세부 정보도 함께 기록하므로, 켜 둔 뒤 실제 로그 발생량을 먼저 확인합니다. 주의할 점은 디스크입니다. 오라클 G1 튜닝 가이드는 로그를 쓰는 디스크의 I/O가 다른 작업으로 포화되면 로그 쓰기 때문에 JVM이 멈출 수 있다고 설명합니다. 로그를 애플리케이션 데이터와 다른 디스크에 두고, 로그 로테이션으로 크기에 상한을 둡니다.
힙을 늘리면 GC 문제가 해결되나요?
힙이 작업량에 비해 작았던 경우라면 GC 빈도가 줄어 효과가 있습니다. 메모리 누수라면 Full GC가 일어나는 시점이 늦춰질 뿐이고, 힙이 커진 만큼 Full GC 한 번의 정지가 더 길어질 수 있습니다. 컨테이너라면 -Xmx를 메모리 제한에 너무 가깝게 잡지 않습니다. JVM은 힙 밖에서도 메타스페이스, 스레드 스택, 다이렉트 버퍼에 메모리를 쓰므로, 힙만 보고 제한을 채우면 GC 로그에는 문제가 없는데 컨테이너가 OOMKilled로 종료될 수 있습니다.
Young GC 정지가 200ms를 넘으면 설정을 바꿔야 하나요?
서비스의 응답 목표에 비해 정지가 길 때만 조정을 검토합니다. -XX:MaxGCPauseMillis를 낮추면 G1은 한 번에 회수하는 양을 줄여 정지를 짧게 만들려 하지만, 그만큼 GC가 더 자주 일어나 전체 처리량이 줄 수 있습니다. 오라클 가이드도 처음에는 기본 설정을 쓰고, 필요하면 정지 목표와 최대 힙 크기 정도만 지정하라고 권합니다.
GC 로그 시각과 모니터링 그래프 시각이 맞지 않으면 어떻게 하나요?
먼저 시간대를 확인합니다. -Xlog의 time 데코레이터는 JVM 프로세스의 시간대 기준 시각에 +0900 같은 오프셋을 붙여 찍습니다. 컨테이너는 시간대가 UTC로 설정된 경우가 많아 +0000으로 찍히기도 하므로, 로그의 오프셋부터 확인합니다. 모니터링 도구나 액세스 로그와 시간대가 다르면 9시간 차이가 납니다. GC 로그도 UTC로 남기려면 utctime 데코레이터를 씁니다. 서버마다 시계가 어긋났을 수도 있으므로 chrony나 NTP 같은 시간 동기화가 켜져 있는지 확인합니다. 그래프가 1분이나 5초 단위로 값을 모아 보여 준다면, 정지 시각과 그래프의 점은 최대 집계 간격 하나만큼 어긋나 보일 수 있습니다.
JDK 27로 올리면 GC 설정을 바꿔야 하나요?
GC를 명령줄에서 직접 지정했다면 바뀌는 것이 없습니다. 지정하지 않은 채 CPU 하나나 1792MB 미만 메모리로 실행하던 환경에서는 Serial GC 대신 G1 GC가 선택됩니다. JEP 523은 이 환경에서도 처리량과 지연, 메모리 사용량이 크게 나빠지지 않는 것을 목표로 했지만, 서비스마다 결과는 다를 수 있습니다. 업그레이드 전후로 GC 로그의 정지 시간과 컨테이너 메모리 사용량을 비교해 보고, 이전 동작이 필요하면 -XX:+UseSerialGC로 되돌릴 수 있습니다.
더 읽을거리
- Java 모니터링 완벽 가이드: JVM·JMX부터 APM까지
- Java 애플리케이션 모니터링 (와탭 공식 문서)
- API 응답 시간이 느린 이유 7가지와 진단 순서
- 리눅스 CPU 사용률이 높은 이유와 확인 방법
- JEP 523, Make G1 the Default Garbage Collector in All Environments (OpenJDK)
- The java Command, Enable Logging with the JVM Unified Logging Framework (Oracle JDK 21 문서)
- Garbage-First Garbage Collector Tuning (Oracle JDK 21 문서)
- The jcmd Command (Oracle JDK 21 문서)