담당자가 프로모션 코드를 발송해 드립니다.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
WhaTap AI를 경험해 보세요.
쿠버네티스 파드 Pending 원인, FailedScheduling 메시지로 구분하는 방법
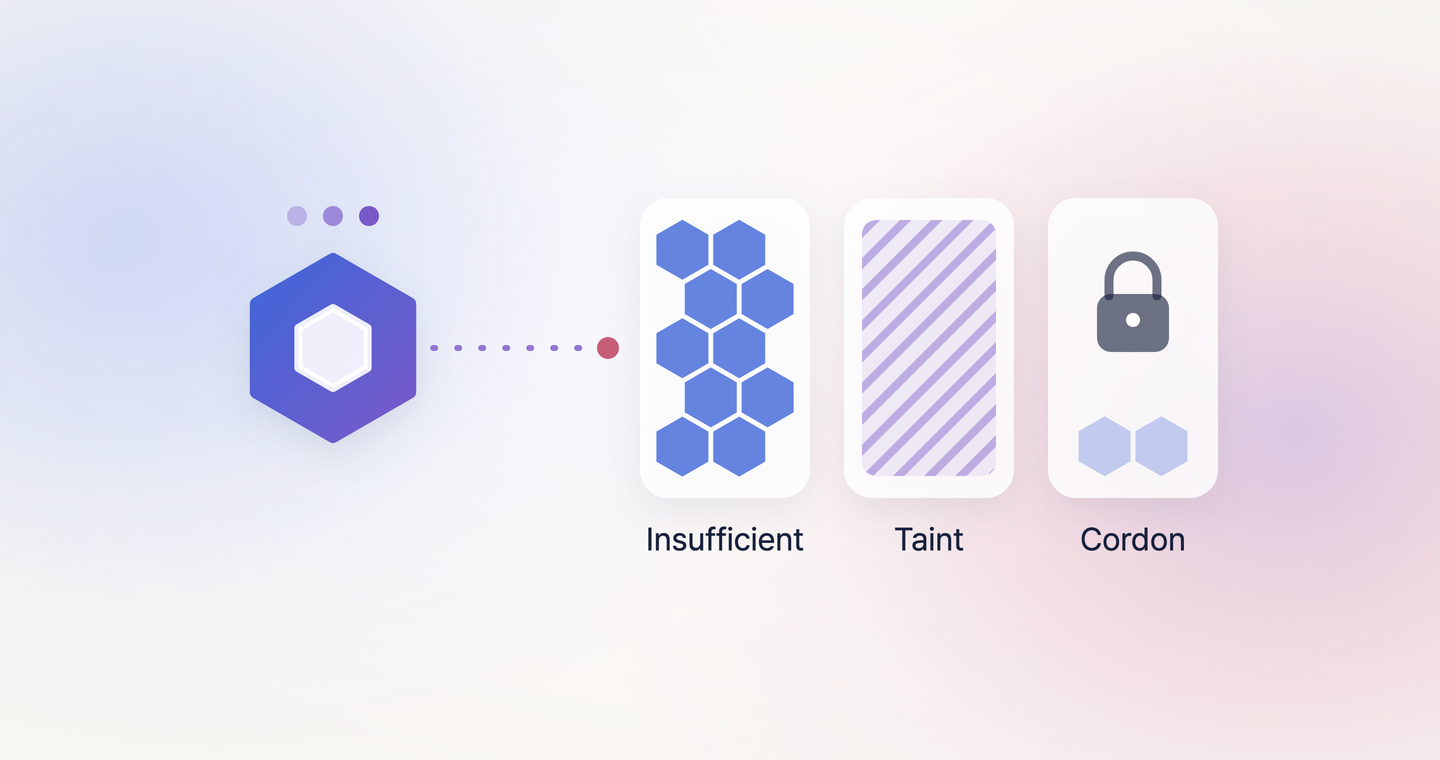
파드가 Pending에서 넘어가지 않으면 먼저 파드 목록(kubectl get pods -o wide)의 NODE 칸에 노드 이름이 있는지 확인합니다. <none>이면 파드를 실행할 노드를 기다리는 중이고, 노드 이름이 있으면 그 노드에서 이미지나 볼륨을 준비하는 중입니다.
노드를 기다리는 파드는 kubectl describe pod의 Events에서 FailedScheduling 메시지를 먼저 봅니다. FailedScheduling 메시지에 스케줄러가 파드를 실행할 노드를 찾지 못한 이유가 남아 있습니다. 예시 문구는 Kubernetes 1.37 기준입니다.
파드 Pending 진단 순서, 먼저 실행할 명령 두 가지
명령에 나오는 shop, web-7d9f8, worker-2는 예시 이름입니다. 실제 네임스페이스, 파드, 노드 이름으로 바꿔 실행합니다.
1. Pending 파드와 NODE 칸 확인
kubectl get pods -n shop -o wide --field-selector=status.phase=Pending
쿠버네티스의 Pending 단계에는 노드 배정 대기와 이미지 다운로드 같은 실행 준비가 모두 포함됩니다. 그래서 Pending 파드를 조회하면 STATUS가 ContainerCreating이나 Init:0/1인 파드도 나올 수 있습니다.
2. 파드 하나의 Events 확인
Pending 파드 목록에서 확인할 파드 하나를 골라 상세 정보를 봅니다.
kubectl describe pod web-7d9f8 -n shop출력 맨 아래 Events에서 실패 이유를 찾습니다. 노드 배정 전이라면 다음과 같은 메시지가 보입니다. 실제로는 한 줄로 나오지만 읽기 쉽도록 사유마다 줄을 나누고, 선점(preemption) 뒷부분은 생략했습니다.
0/3 nodes are available:
  1 Insufficient memory,
  1 node(s) had untolerated taint(s),
1 node(s) were unschedulable.- 0/3 nodes are available: 노드 3대 가운데 이 파드를 받을 수 있는 노드가 없습니다.
- 1 Insufficient memory: 1대는 새 파드의 메모리 요청량을 받아 줄 여유가 없습니다.
- 1 node(s) had untolerated taint(s): 1대는 노드 문에 출입 제한 표시(테인트)가 붙어 있는데, 파드에 그 표시를 통과할 출입증(톨러레이션)이 없습니다.
- 1 node(s) were unschedulable: 나머지 1대는 관리자가 점검 등을 위해 새 파드를 받지 않게 막아 둔 노드입니다. 노드를 막아 두는 조치를 cordon이라고 합니다.
이 예시라면 메모리가 모자란 노드의 예약량을 줄이거나 노드를 추가할지, 테인트가 붙은 노드에 이 파드를 배치해도 되는지, 점검이 끝난 노드를 다시 열지 확인합니다. 메시지에 나온 문구를 아래에서 찾아 해당 원인과 해결 방법을 확인하면 됩니다.
FailedScheduling 메시지로 보는 Pending 원인
스케줄러는 각 노드가 파드의 배치 조건을 만족하는지 검사합니다. 메시지의 숫자는 해당 사유로 배치할 수 없었던 노드 수입니다. 한 노드가 여러 사유에 집계되는 경우도 있으므로, 숫자 합이 전체 노드 수와 꼭 같지는 않습니다.
Insufficient cpu, Insufficient memory와 requests
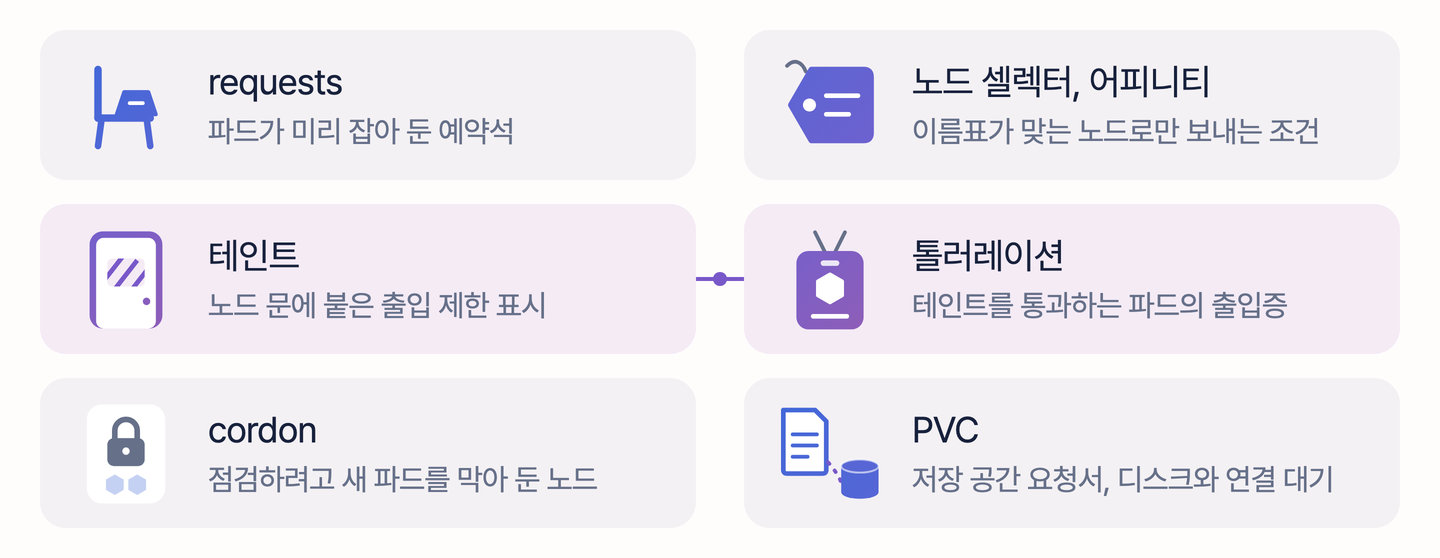
스케줄러는 노드의 지금 사용량 대신 파드가 미리 예약해 둔 양으로 남은 여유를 계산합니다. 식당에서 손님이 아직 오지 않았어도 예약석을 다른 손님에게 내주지 않는 것과 같은 방식입니다. 쿠버네티스에서는 파드가 예약해 두는 자원의 양을 requests라고 합니다.
노드가 파드에 내줄 수 있는 자원을 할당 가능량(allocatable)이라고 합니다. 예를 들어 메모리 할당 가능량이 8Gi이고 기존 파드들이 6Gi를 예약했다면, 남은 예약 공간은 2Gi입니다. 새 파드가 3Gi를 요청하면 실제 메모리 사용률이 낮아도 배치되지 않습니다.
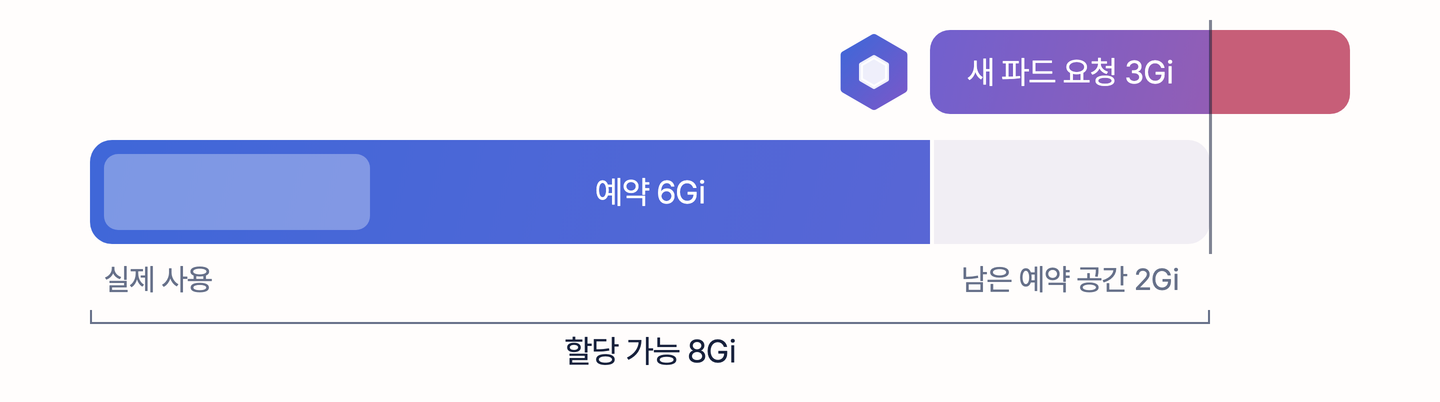
파드가 요청한 양은 kubectl describe pod의 Containers와 Init Containers에서, 노드에 이미 예약된 양은 kubectl describe nodes(노드 읽기 권한 필요)에서 확인합니다.
노드의 Allocated resources에서 Requests 열이 이미 예약된 양입니다. 아래는 메모리 할당 가능량이 8Gi인 노드의 예시입니다.
Allocated resources:
  Resource         Requests      Limits
  --------         --------      ------
  cpu              1 (50%)       2 (100%)
  memory           6Gi (75%)     10Gi (125%)
Limits는 컨테이너가 사용할 수 있는 상한의 합계이며 100%를 넘기도 합니다. 스케줄러가 배치를 판단할 때 비교하는 값은 Requests입니다.
일반 컨테이너의 requests가 작아도 init 컨테이너의 요청량이 크면 그 값 때문에 배치가 막힐 수 있습니다.
모든 노드가 Insufficient라면 실제 사용량과 필요한 여유를 확인해 requests를 조정하거나(쿠버네티스 리소스 설정 튜닝 사례) 노드를 추가합니다.
노드당 파드 수 상한(기본 110개)에 도달하면 Too many pods가 남습니다. 중요한 파드를 먼저 넣는 선점은 더 읽을거리의 Pod Priority and Preemption 문서에서 다룹니다.
node affinity/selector 불일치와 파드 안티어피니티
노드에는 라벨이라는 이름표를 붙일 수 있고, 파드에는 "이 이름표가 붙은 노드로만 가라" 같은 조건을 걸 수 있습니다. 조건에 맞는 이름표를 단 노드가 없으면 파드는 기다립니다.
노드 셀렉터(nodeSelector)든 노드 어피니티(node affinity)든 맞는 노드가 없으면 didn't match Pod's node affinity/selector로 집계됩니다. kubectl get pod web-7d9f8 -n shop -o yaml에서 본 nodeSelector, affinity와 kubectl get nodes -L disktype로 본 노드 라벨을 비교합니다.
라벨 값이 다르거나 새 노드에 필요한 라벨이 빠졌다면, 의도한 배치 조건에 맞게 파드 설정이나 노드 라벨을 고칩니다. 노드 어피니티 가운데 배치를 막는 규칙은 required로 시작하는 규칙뿐이고, preferred 규칙만 있으면 맞는 노드가 없어도 파드는 다른 노드에 배치됩니다.
파드 안티어피니티는 같은 파드끼리 같은 노드에 두지 말라는 규칙입니다. 파드 안티어피니티를 걸었는데 파드가 노드보다 많으면 남는 파드는 갈 곳이 없습니다.
파드 사본(replicas)이 4개인데 워커 노드가 3대이고 노드마다 하나씩만 두라는 required 안티어피니티가 걸려 있으면, 네 번째 파드는 didn't match pod anti-affinity rules로 남습니다. 서로 다른 노드에 배치해야 한다면 노드를 추가합니다. 같은 노드에 배치해도 된다면 규칙을 preferred로 완화할 수 있지만, 노드 한 대가 고장 나면 함께 멈추는 파드가 늘어납니다.
untolerated taint와 cordon된 노드
노드 문에는 "GPU 작업용 파드만 받음" 같은 출입 제한 표시를 붙일 수 있습니다. 쿠버네티스는 노드의 출입 제한 표시를 테인트(taint)라고 하고, 파드가 테인트를 통과하게 해 주는 출입증을 톨러레이션(toleration)이라고 합니다. 파드에 맞는 출입증이 없으면, 테인트가 붙은 노드는 had untolerated taint(s)로 집계됩니다.
1.35부터는 이벤트에 테인트 키와 값이 나오지 않으므로 노드 설정을 직접 봅니다. kubectl get nodes -o custom-columns='NAME:.metadata.name,TAINTS:.spec.taints'로 본 노드의 테인트와 파드 YAML의 tolerations(출입증)를 비교합니다.
Pending인 파드를 테인트가 붙은 노드에 배치해도 되는지 먼저 확인합니다. 전용 노드에 들어가야 하는 파드라면 파드 템플릿의 tolerations를 노드의 테인트에 맞춥니다. 노드 선택 조건을 잘못 지정해 전용 노드만 후보로 남았다면 그 조건을 고칩니다.
노드가 준비되지 않았거나 메모리, 디스크 압박을 받으면 쿠버네티스가 node.kubernetes.io/not-ready 같은 테인트를 직접 붙입니다. 이때는 톨러레이션을 추가하기 전에 kubectl describe node worker-2의 Conditions에서 노드 상태부터 확인합니다.
were unschedulable이면 노드가 cordon 상태인지 확인합니다. cordon은 점검 등으로 노드가 새 파드를 받지 않게 막아 두는 조치이고, cordon된 노드는 kubectl describe node worker-2에서 Unschedulable: true로 보입니다. 점검이 끝난 노드라면 kubectl uncordon worker-2로 다시 파드를 받게 합니다.
PVC 바인딩 대기
파드가 저장 공간 요청서(PVC, PersistentVolumeClaim)를 냈는데 실제 디스크(PV, PersistentVolume)와 연결되지 않으면 파드는 기다립니다. PVC와 PV를 연결하는 일을 바인딩이라고 합니다.
pod has unbound immediate PersistentVolumeClaims는 먼저 연결돼 있어야 할 PVC가 아직 바인딩되지 않았다는 뜻입니다. kubectl describe pvc web-data -n shop의 이벤트에서 이유를 찾습니다.
persistentvolumeclaim "이름" not found라면 파드의 volumes에 지정한 PVC 이름과 같은 네임스페이스에 실제로 존재하는 PVC를 비교합니다.
스토리지 클래스가 없다면 kubectl get storageclass로 사용 가능한 클래스를 확인하고 PVC에 지정할 클래스를 검토합니다. ProvisioningFailed라면 이벤트의 구체적인 오류에 따라 용량, 권한, 스토리지 설정을 확인합니다.
waiting for first consumer와 waiting for pod … to be scheduled 자체는 오류가 아닙니다. volumeBindingMode: WaitForFirstConsumer에서는 파드의 배치 조건에 맞춰 볼륨을 선택하거나 만듭니다. 이 문구가 보이면 파드의 FailedScheduling 메시지에서 배치를 막는 다른 조건을 확인합니다.
파드가 아예 안 생길 때, ResourceQuota
쿠버네티스 클러스터는 팀이나 서비스별로 네임스페이스라는 단위로 나눠 쓰고, 네임스페이스마다 거는 자원 한도를 ResourceQuota라고 합니다. 한도를 넘으면 쿠버네티스는 파드를 아예 만들지 않아서 파드 목록에 아무것도 보이지 않습니다. 거절 기록은 파드가 아니라 파드를 만드는 쪽에 남습니다.
Deployment의 READY가 0/3인데 파드가 보이지 않으면 ResourceQuota나 컨테이너별 범위인 LimitRange에 걸렸을 수 있습니다. 거절 이유는 Deployment 아래에서 파드 수를 유지하는 ReplicaSet의 FailedCreate 이벤트에 남습니다. kubectl get events -n shop --field-selector reason=FailedCreate로 이벤트를 보고, 한도와 사용량은 kubectl describe resourcequota -n shop로 확인합니다.
쿼터 초과 메시지(exceeded quota)에는 요청량, 사용량, 한도가 함께 나옵니다. 예를 들어 requested: requests.memory=2Gi, used: requests.memory=9Gi, limited: requests.memory=10Gi라면 남은 한도는 1Gi인데 새 파드가 2Gi를 요청해 거절된 것입니다. 불필요한 워크로드를 정리하거나, 필요한 요청량을 검토하거나, 네임스페이스의 한도 증설을 요청합니다.
노드는 정해졌는데 Pending일 때
NODE 칸에 노드 이름이 있다면 노드 배정은 끝났고, 그 노드에서 컨테이너를 준비하다 멈춘 것입니다. Events에서 Scheduled 이후의 실패 메시지를 확인합니다.
- ErrImagePull, ImagePullBackOff: 이미지를 받지 못했습니다. ImagePullBackOff 원인 4가지(시리즈 2편)에서 다뤘습니다.
- FailedMount: 볼륨을 마운트하지 못했습니다. 메시지에 나온 ConfigMap, Secret이 있는지와 오류 내용을 확인하고, PVC 볼륨이라면 스토리지 드라이버가 남긴 오류를 봅니다.
- FailedAttachVolume: 스토리지 볼륨을 노드에 연결하지 못했습니다. 메시지에서 다른 노드에 연결돼 있는지, 스토리지 드라이버가 어떤 오류를 남겼는지 확인합니다.
- STATUS가 Init:0/1: 본 컨테이너보다 먼저 실행되는 준비용 init 컨테이너가 끝나지 않았습니다.
kubectl logs web-7d9f8 -n shop -c init-db로 로그를 봅니다.
Pending 원인을 잘못 읽기 쉬운 경우, kubectl top과 스케줄러 검사 순서
Insufficient memory인데 노드 메모리 사용률은 낮을 때
메모리가 절반도 차지 않았는데 Insufficient memory가 나오면 메시지를 의심하기 쉽습니다. 이때는 실제 사용량이 적어도 requests 예약량이 노드를 이미 채운 상태입니다.
kubectl top node는 지금 쓰는 양을 보여 주고, 스케줄러는 requests 합계를 봅니다. requests를 넉넉하게 잡은 파드가 많으면 사용률이 38%여도 requests 합계는 100%에 가까울 수 있습니다. Insufficient를 보면 kubectl describe nodes의 Allocated resources에서 Requests 비율을 봅니다.
톨러레이션을 넣었는데도 Pending이 풀리지 않을 때
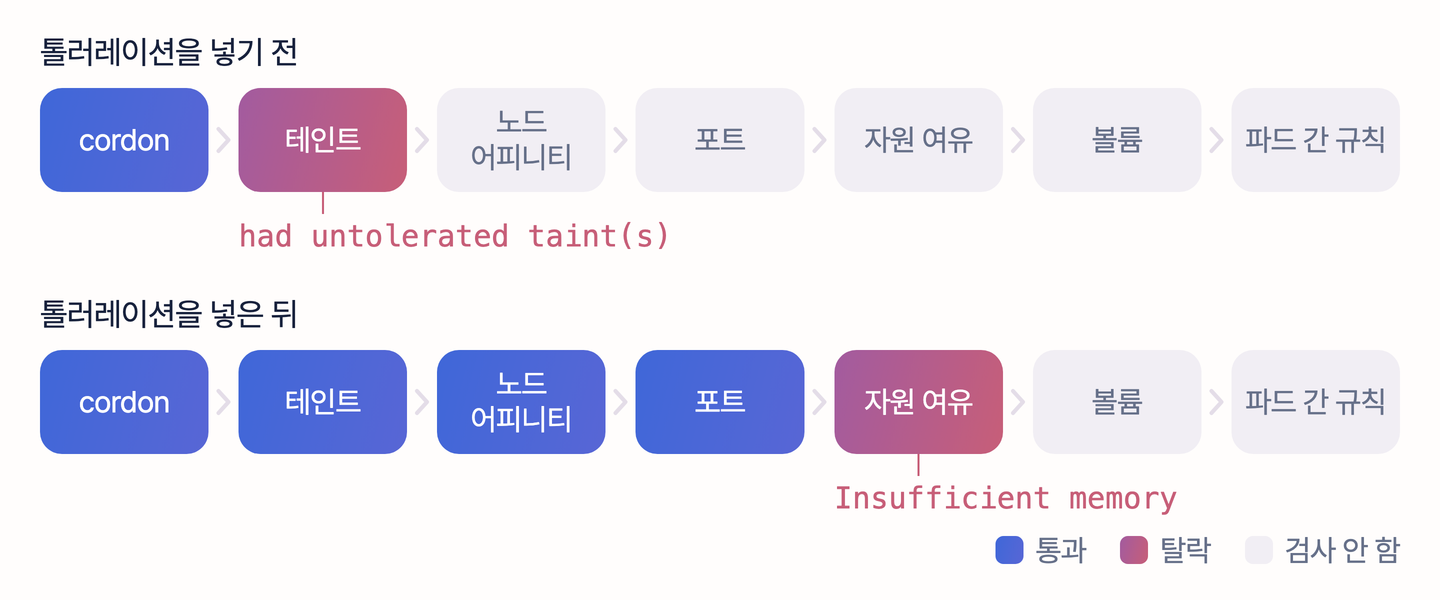
스케줄러는 노드마다 여러 조건을 정해진 순서대로 검사하고, 서류 심사에서 떨어진 지원자를 면접에 부르지 않듯 한 조건에서 떨어진 노드는 다음 조건을 검사하지 않습니다. 그래서 Pending 원인 하나를 고치면, 먼저 검사하는 조건에서 탈락하느라 확인되지 못했던 다른 원인이 드러나기도 합니다.
기본 스케줄러는 테인트(노드의 출입 제한 표시)를 자원보다 먼저 검사합니다. 테인트 때문에 탈락한 노드는 자원 검사까지 가지 않습니다. 톨러레이션(테인트를 통과하는 출입증)을 넣고 나서 같은 노드가 Insufficient memory로 집계된다면, 기존 자원 부족이 이제 드러난 것입니다. 하나를 고칠 때마다 kubectl describe pod로 이벤트를 다시 확인합니다.
FailedScheduling 이벤트가 사라진 뒤 Pending 원인 확인하기
Pending이 몇 시간 이어지면 처음 실패한 기록은 지워져 있을 수 있지만, 파드의 조건(condition) 기록에는 마지막 사유가 남아 있습니다.
쿠버네티스는 이벤트를 기본 1시간만 보관하고, 같은 사유로 반복된 이벤트는 3m (x5 over 18m)처럼 횟수만 늘고 처음 기록한 문구가 그대로 남을 수 있습니다. 이벤트가 없거나 최신 사유를 보려면 kubectl get pod web-7d9f8 -n shop -o yaml의 status.conditions에서 type이 PodScheduled인 항목의 reason과 message를 읽습니다.
스케줄러는 자원 확보나 노드 추가처럼 배치 가능성에 영향을 주는 변화가 생기면 다시 시도합니다. 관련 변화가 없어도 기본 설정에서는 약 5분이 지난 미배정 파드를 재시도 대상으로 돌립니다. 그래서 Insufficient memory였던 사유가 다른 파드가 지워진 뒤 didn't match pod anti-affinity rules로 바뀌기도 합니다. 메모리 여유가 생긴 노드가 이번에는 파드 안티어피니티 규칙에 막힌 것이니, 그 사이 클러스터에서 어떤 변경이 있었는지 함께 봅니다.
자주 묻는 질문
노드가 1대인데 왜 0/1 nodes are available: 1 node(s) had untolerated taint(s)가 나오나요?
그 노드가 컨트롤 플레인 노드라 일반 파드를 받지 않게 하는 출입 제한 표시인 node-role.kubernetes.io/control-plane 테인트가 붙어 있을 수 있습니다. kubeadm으로 노드 1대짜리 클러스터를 만들면 이 테인트가 그대로 남습니다(kind는 노드가 1대이면 생성할 때 이 테인트를 지웁니다). 운영 클러스터라면 워커 노드를 추가합니다. 실습용 단일 노드 클러스터라면 kubeadm 공식 문서가 안내하는 kubectl taint nodes --all node-role.kubernetes.io/control-plane-로 테인트를 지웁니다. Kubernetes 1.35부터(1.34는 1.34.2 패치부터)는 메시지에 테인트 키와 값이 나오지 않고, 그 이전 버전에서는 had untolerated taint 뒤에 함께 나옵니다.
메시지에 volume node affinity conflict나 didn't match PersistentVolume's node affinity가 나옵니다
두 문구는 같은 사유이고, 1.33부터 didn't match PersistentVolume's node affinity, 1.32 이하에서는 had volume node affinity conflict로 나옵니다. PVC가 이미 바인딩됐는데 볼륨이 있는 위치와 파드가 갈 수 있는 노드가 맞지 않는다는 뜻입니다. 가용 영역 A에 만든 볼륨을 쓰는 StatefulSet 파드가 있는데 영역 A의 노드 그룹을 줄였을 때가 대표적이고, 영역 A에 노드를 다시 두거나 데이터를 옮긴 뒤 PVC를 새로 만듭니다.
메시지에 didn't have free ports for the requested pod ports가 나옵니다
파드가 hostPort로 노드의 포트를 직접 쓰는데, 그 포트를 이미 다른 파드가 쓰고 있다는 뜻입니다. 같은 hostPort를 쓰는 파드는 노드 한 대에 하나만 올라가므로 replicas가 노드 수보다 많으면 남는 파드는 Pending이 됩니다. 쿠버네티스 공식 문서는 대부분의 경우 hostPort 대신 Service로 파드를 노출하도록 안내합니다.
클러스터 오토스케일러를 쓰는데 Pending이 왜 풀리지 않나요?
파드 이벤트에서 오토스케일러의 판단을 봅니다. TriggeredScaleUp은 이 파드를 위해 노드를 늘리기로 했다는 이벤트라, 새 노드가 준비될 때까지 몇 분간 Pending인 것은 정상입니다. NotTriggerScaleUp은 늘릴 수 있는 노드 그룹을 찾지 못했다는 이벤트입니다. 노드 그룹이 최대 크기에 도달했거나, 새 노드를 만들어도 노드 셀렉터나 테인트 때문에 파드가 들어가지 못하면 이 이벤트가 남습니다.
메시지의 숫자를 더하면 노드 수보다 크거나, 숫자가 아예 없습니다
cpu와 memory가 함께 모자란 노드는 Insufficient cpu와 Insufficient memory 두 사유에 모두 들어가므로 숫자 합이 노드 수보다 클 수 있습니다. PVC 사유처럼 노드를 하나씩 검사하기 전에 걸리는 사유는 0/3 nodes are available: pod has unbound immediate PersistentVolumeClaims처럼 숫자 없이 나옵니다.
STATUS가 Pending이 아니라 SchedulingGated로 나옵니다
파드에 스케줄링 게이트(spec.schedulingGates)가 남아 있어 스케줄러가 아직 시도조차 하지 않은 상태입니다. 스케줄링 게이트는 큐 관리 도구 같은 외부 컨트롤러가 조건이 갖춰질 때까지 스케줄링을 보류하려고 넣는 값이고, Kubernetes 1.30에서 정식 기능이 됐습니다. kubectl get pod web-7d9f8 -o jsonpath='{.spec.schedulingGates}'로 남은 게이트를 보고, 게이트를 넣은 컨트롤러가 정상 동작하는지 점검합니다.
마치며
파드 Pending 해결의 첫 분기는 NODE 칸입니다. 비어 있으면 FailedScheduling 메시지 문구로 자원, 노드 선택 조건, 테인트, PVC 가운데 어디를 볼지 정하고, 파드가 목록에 없으면 ReplicaSet 이벤트에서 쿼터 거절을 찾습니다. 하나를 고친 뒤에는 메시지를 다시 보고 다음 사유가 드러나는지 확인합니다.
와탭 쿠버네티스 모니터링에서는 지금 Pending인 파드의 이벤트 메시지와 QoS 클래스를 한 목록에서 보고, 메시지를 바탕으로 한 문제 해결 제안까지 받을 수 있습니다(Pending Pod 현황 문서).
더 읽을거리
- 쿠버네티스 CrashLoopBackOff 원인 4가지 구분법 (쿠버네티스 문제 해결 가이드 1편)
- 쿠버네티스 ImagePullBackOff 원인 4가지와 kubectl describe 진단법 (쿠버네티스 문제 해결 가이드 2편)
- OOMKilled와 Exit Code 137 원인과 해결 방법 (쿠버네티스 문제 해결 가이드 3편)
- 쿠버네티스 모니터링, 4가지 핵심 지표부터 툴 선택까지
- Debug Pods (Kubernetes 공식 문서)
- Assigning Pods to Nodes (Kubernetes 공식 문서)
- Taints and Tolerations (Kubernetes 공식 문서)
- Resource Quotas (Kubernetes 공식 문서)
- Pod Priority and Preemption (Kubernetes 공식 문서)