담당자가 프로모션 코드를 발송해 드립니다.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
WhaTap AI를 경험해 보세요.
LLM API 토큰 사용량 확인하는 3가지 방법
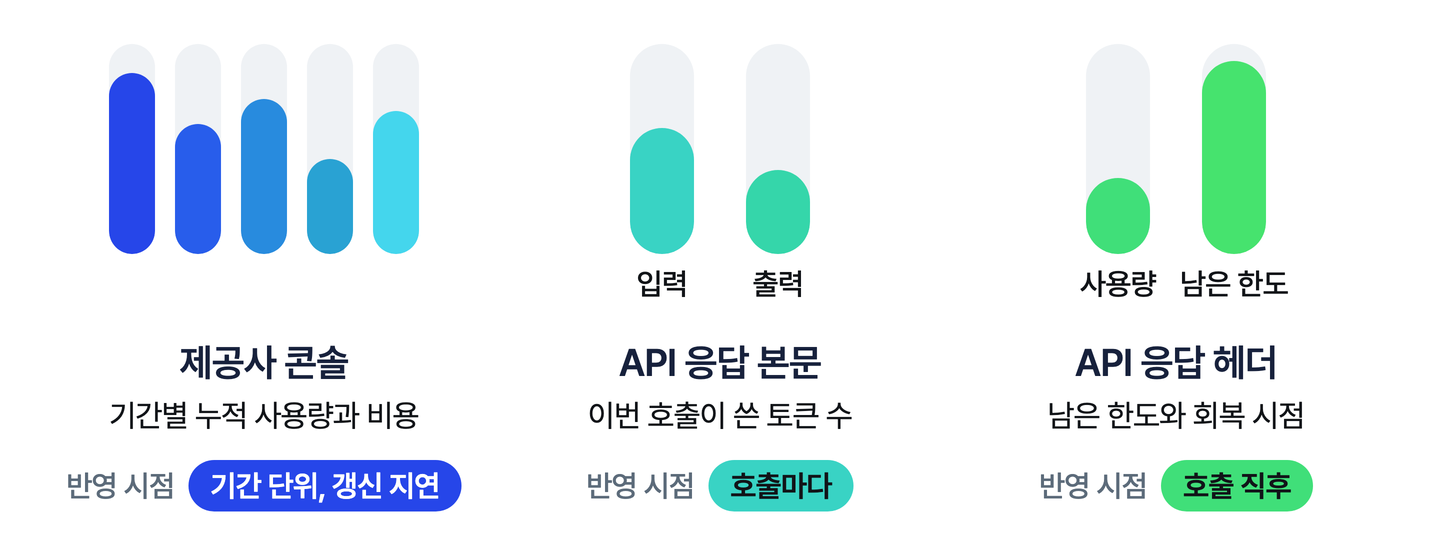
서비스에 OpenAI(GPT API)나 Anthropic Claude(클로드) API를 연동해 운영하고 있다면, 지금까지 쓴 토큰 양은 제공사 콘솔, API 응답 본문, 응답 헤더 세 곳에서 확인할 수 있습니다. 세 곳은 집계하는 범위와 반영 시점이 달라서, 같은 기간을 봐도 숫자가 다르게 나옵니다.
토큰 사용량은 LLM(대규모 언어 모델) API를 호출할 때 오간 텍스트를 모델이 처리하는 단위로 계산한 값입니다. 보낸 쪽은 입력 토큰, 받은 쪽은 출력 토큰으로 나눠 집계하고(출력 토큰에는 응답 텍스트에 나타나지 않는 추론 토큰도 포함됩니다), 제공사는 이 값을 기준으로 요금과 토큰 한도를 계산합니다. 그래서 사용량을 확인하지 않으면 요금이 얼마나 나가는지도, 한도까지 얼마나 남았는지도 알 수 없습니다.
토큰 사용량은 어디에서 확인하나
지금 알고 싶은 것이 누적 비용인지, 이번 호출의 토큰 수인지, 남은 한도인지에 따라 확인할 곳이 달라집니다.
1. OpenAI와 Anthropic 콘솔에서 누적 사용량 확인하기
OpenAI와 Anthropic 모두 콘솔에 Usage 페이지(OpenAI, Anthropic)를 두고, 기간별로 쓴 토큰 수와 청구 금액을 보여 줍니다. 모델별로 나눠 보는 것도 콘솔에서 할 수 있습니다.
Anthropic 콘솔의 Usage 페이지에는 사용량 차트와 별도로 한도 차트가 두 개 더 있습니다. 입력 토큰 차트는 시간대별로 캐시를 쓰지 않은 분당 입력 토큰의 최댓값과 현재 한도를 겹쳐 그려 주고, 입력 토큰 중 캐시에서 읽은 비율도 함께 보여 줍니다. 출력 토큰 차트는 시간대별 분당 출력 토큰의 최댓값과 현재 한도를 보여 줍니다. 두 한도 차트는 한도를 올려 달라고 요청하기 전에, 실제 사용량이 한도에 얼마나 가까웠는지 확인하는 용도입니다.
콘솔로 알 수 없는 것도 있습니다. 프로젝트, 워크스페이스, API 키처럼 제공사가 지원하는 단위로는 사용량을 나눠 볼 수 있지만, 여러 기능이 같은 프로젝트나 API 키를 함께 쓰면 챗봇과 요약 기능 중 어디에서 사용량이 늘었는지 구분하기 어렵습니다. 특정 사용자가 몰아서 쓴 것인지도 콘솔만으로는 알 수 없습니다. 갱신도 실시간이 아니어서, 방금 몰린 호출을 지금 확인하는 데는 맞지 않습니다.
2. API 응답 본문에서 호출별 토큰 수 읽기
호출 하나가 토큰을 얼마나 썼는지는 응답 본문에 들어 있습니다. 스트리밍이 아닌 일반 호출이라면 응답 본문의 usage 항목에서 바로 확인할 수 있습니다. 스트리밍은 API에 따라 사용량을 받는 옵션을 켜거나 특정 이벤트를 읽어야 합니다(자주 묻는 질문에서 다룹니다).
같은 토큰이라도 제공사와 API마다 필드 이름이 다릅니다.
캐시와 추론 항목은 입력과 출력의 세부 항목(이름이 _details로 끝나는 묶음) 안에 들어 있습니다. OpenAI의 Chat Completions API와 Responses API를 함께 쓰는 경우, 한쪽 API의 사용량 필드만 읽으면 다른 API의 출력 토큰이 집계에서 빠질 수 있습니다.
추론 토큰은 응답 텍스트에는 나타나지 않지만 출력 토큰에 포함돼 요금이 나갑니다. 추론 토큰을 따로 보지 않으면 출력이 짧은데 비용이 큰 이유를 설명하지 못합니다.
Anthropic의 input_tokens에는 마지막 캐시 지점 뒤에 새로 들어간 토큰만 담깁니다.
Anthropic의 input_tokens는 전체 입력이 아닙니다. 전체 입력 토큰은 cache_read_input_tokens, cache_creation_input_tokens, input_tokens 세 필드를 더한 값입니다.
input_tokens 하나만 더하면 캐시를 쓸수록 실제보다 작은 값이 나옵니다. 공식 문서의 예를 보면, 20만 토큰 분량의 문서를 캐시해 두고 50토큰 분량의 질문을 보내면 input_tokens는 50으로 표시되지만 실제 입력은 200,050 토큰입니다.
3. 응답 헤더에서 남은 한도 확인하기
지금 한도에 얼마나 가까운지는 응답 헤더에 있습니다. 응답 헤더는 콘솔보다 빨리 반영되고, 호출하는 코드 안에서 바로 읽을 수 있습니다.
OpenAI와 Anthropic 모두 한도 자체를 알려 주는 헤더를 함께 보냅니다. OpenAI는 x-ratelimit-limit-tokens, Anthropic은 입력 anthropic-ratelimit-input-tokens-limit과 출력 anthropic-ratelimit-output-tokens-limit입니다. 남은 값을 한도로 나누면 한도가 몇 퍼센트 남았는지 나옵니다.
Anthropic의 남은 토큰 값은 공식 문서 기준으로 천 단위에서 반올림해 내려옵니다. 정밀한 잔량 계산에는 맞지 않고 여유가 얼마나 남았는지 보는 용도입니다. 한도 회복 시점도 형식이 다릅니다. Anthropic은 한도가 다시 가득 차는 시각을 RFC 3339 형식의 절대 시각(2026-09-16T10:30:00Z 같은 값)으로 주고, OpenAI는 한도가 회복될 때까지 남은 시간으로 줍니다.
한도를 넘기면 429 응답이 돌아옵니다. Anthropic은 함께 오는 retry-after 헤더에 기다려야 할 시간(초)을 담아 보내고, 그보다 일찍 다시 보내면 그 요청도 실패한다고 안내합니다. OpenAI도 일시적인 한도 초과로 생긴 429에는 retry-after를 함께 보낼 수 있습니다. retry-after 헤더가 왔다면 헤더에 담긴 시간만큼은 기다리는 편이 안전합니다.
요청 수 한도(RPM)와 토큰 한도(TPM)가 따로 적용되는 이유
요청 수 한도에는 여유가 많은데 429 응답이 돌아오는 일이 있습니다. 한도가 하나가 아니라 여러 개이고, 그 가운데 먼저 소진된 한도에서 막히기 때문입니다.
한도를 나누는 기준은 제공사마다 다릅니다. OpenAI는 요청 수와 토큰 수에 분 단위 한도와 일 단위 한도를 따로 둡니다. Anthropic은 요청 수 한도와 함께 토큰 한도를 입력(ITPM)과 출력(OTPM)으로 나눠 두고, 모델별로 적용합니다.
Anthropic에서는 짧은 질문에 긴 답을 만드는 기능이 ITPM보다 OTPM 한도에 먼저 도달합니다.
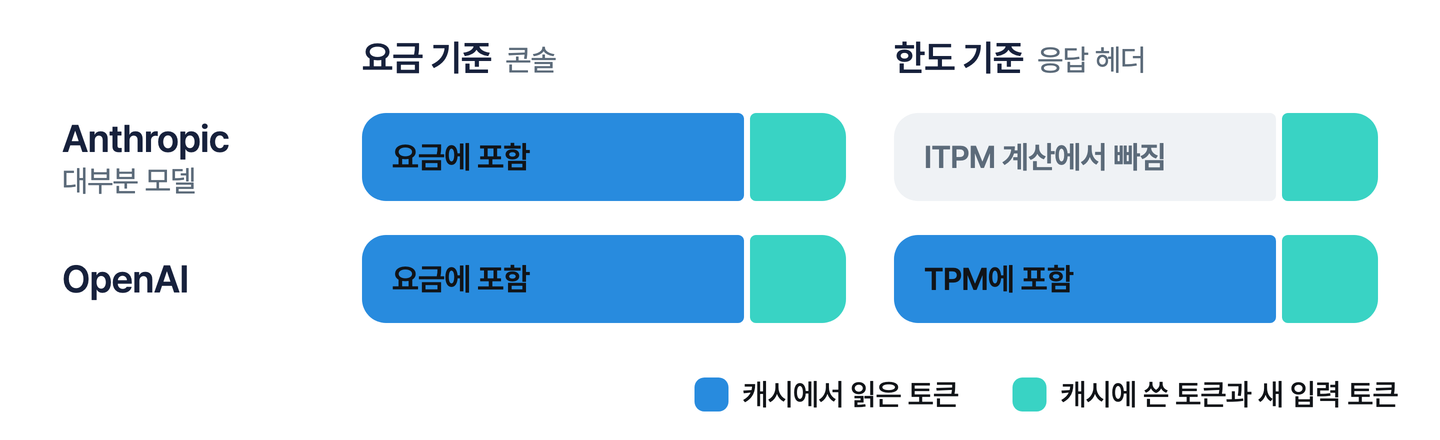
Anthropic 공식 문서는 대부분의 모델에서 캐시에서 읽은 토큰이 ITPM 한도에 포함되지 않는다고 설명합니다. 캐시에 쓰는 토큰과 캐시 뒤에 새로 들어간 토큰만 ITPM 한도에 포함됩니다. 공식 문서의 예를 보면, ITPM 한도가 200만이고 캐시 적중률이 80%일 때 분당 1,000만 토큰까지 처리할 수 있습니다. OpenAI는 캐시에서 읽은 입력 토큰도 TPM 한도에 포함된다고 안내합니다.
캐시 토큰을 집계하는 기준이 다르기 때문에 콘솔 숫자와 헤더 숫자가 어긋나 보이는 일이 생깁니다. Anthropic의 대부분 모델은 캐시에서 읽은 토큰에도 요금을 매기지만, ITPM 계산에서는 캐시에서 읽은 토큰을 뺍니다. 콘솔은 요금 기준으로, 헤더는 한도 기준으로 집계하기 때문에 두 값이 달라 보일 뿐 어느 한쪽이 틀린 것이 아닙니다.
짧은 구간에 호출이 몰리는 버스트에서도 429가 돌아옵니다. Anthropic 문서는 분당 60건 한도가 초당 1건으로 적용될 수 있다고 설명합니다. 버스트로 인한 429는 한도 상향만으로 해결되지 않을 수 있습니다. 호출 시점을 분산하고 동시 요청 수를 조절하는 방법도 함께 적용하는 편이 낫습니다.
호출마다 기록할 토큰 사용량 값
콘솔은 제공사가 정한 단위로만 사용량을 나누고, 응답 헤더는 지금 남은 한도만 보여 줍니다. 지난주 화요일 오후에 어느 기능이나 어느 사용자가 토큰을 몰아 썼는지 같은 질문에는 기능과 사용자를 구분하는 정보를 그때 함께 기록해 뒀을 때만 답할 수 있습니다.
호출 하나마다 아래 값을 함께 남겨 두면 지난 사용량을 따져 볼 때 필요한 질문에 답할 수 있습니다.
- 호출 시각, 제공사, 모델 이름: 기간별, 제공사별로 집계하고 모델을 바꾼 뒤의 변화를 비교하는 기준
- 입력 토큰과 출력 토큰: 어느 쪽이 늘었는지 구분하려면 나눠서 기록
- 캐시에서 읽은 토큰과 캐시에 쓴 토큰: 캐시 사용량을 구분하는 값. 요금과 토큰 한도에 반영되는 방식은 제공사와 모델마다 다름
- 추론 토큰: 출력 토큰에 포함되지만 응답 텍스트에는 나타나지 않는 값
- 기능과 사용자 구분값: 챗봇인지 요약인지, 어느 사용자나 테넌트의 호출인지 구분할 이름
- 요청 ID와 재시도 차수: 원래 요청과 재시도를 이어 보는 값
- 응답 상태와 소요 시간: 429와 재시도가 언제 몰렸는지 확인하는 값
- 사용량 수집 여부: 실제로 0인 호출과 스트림이 끊겨 사용량을 받지 못한 호출을 구분하는 표시
값의 이름을 OpenTelemetry GenAI 시맨틱 컨벤션에 맞춰 두면 나중에 도구를 바꿔도 그대로 쓸 수 있습니다. OpenTelemetry GenAI 시맨틱 컨벤션은 생성형 AI 호출 데이터의 이름을 정해 둔 공개 규격입니다.
OpenTelemetry 이름으로 기록할 때 주의할 점
OpenTelemetry에서는 토큰 사용량을 목적에 따라 세 가지 형태로 기록합니다. 개별 호출을 확인할 때는 스팬 속성, 전체 사용량을 누적할 때는 카운터, 호출별 분포를 볼 때는 히스토그램을 사용합니다.
전체 이름은 열 제목의 접두사 뒤에 표의 값을 붙인 형태입니다. 캐시에서 읽은 토큰의 누적 카운터라면 gen_ai.client.inference.usage.cache_read.input_tokens입니다.
히스토그램은 p95(전체 호출의 약 95%가 이 값 이하인 지점) 같은 분포를 확인하는 데 쓰고, 값을 더해 총량이나 비용을 계산하지는 않습니다.
규격상 캐시에서 읽거나 쓴 토큰은 전체 입력 토큰에, 추론 토큰은 전체 출력 토큰에 이미 포함됩니다. 전체 사용량을 계산할 때 세부 항목을 다시 더하면 중복으로 집계됩니다.
Anthropic 사용량을 옮길 때는 입력 토큰을 조심해야 합니다. 규격의 gen_ai.usage.input_tokens는 캐시를 포함한 전체 입력이므로, Anthropic은 cache_read_input_tokens, cache_creation_input_tokens, input_tokens 세 필드를 더한 값을 넣습니다.
GenAI 시맨틱 컨벤션은 아직 개발(Development) 단계라 이름이 바뀔 수 있습니다. 실제로 2026년 9월에 토큰 메트릭 이름이 gen_ai.client.inference.*로 바뀌었으니, 적용 전에 계측 라이브러리 버전과 기존 대시보드, 알림을 확인합니다. 규격 전반은 더 읽을거리의 OpenTelemetry GenAI 시맨틱 컨벤션 글을 참고하세요.
자주 묻는 질문
스트리밍으로 받으면 토큰 수를 어떻게 확인하나요
응답을 조각으로 나눠 받으면 사용량이 한 번에 오지 않습니다. Anthropic Messages API는 스트림 시작 이벤트에 입력 토큰을, 그 뒤 message_delta 이벤트에 누적 출력 토큰을 실어 보냅니다. 가장 마지막에 오는 종료 이벤트에는 사용량이 없으므로, 종료 신호만 기다리면 값을 놓칩니다. OpenAI Chat Completions API는 요청의 stream_options에 "include_usage": true를 넣어야 스트림 끝에 사용량 청크가 따로 옵니다. Responses API는 완료 이벤트(response.completed)에 담긴 응답 객체에서 사용량을 읽습니다. 제공사와 SDK마다 사용량이 실리는 이벤트와 옵션이 다르므로, 쓰는 API 문서에서 어느 이벤트를 읽어야 하는지 먼저 확인하는 편이 안전합니다.
사용자가 중간에 연결을 끊으면 사용량이 담긴 이벤트를 받지 못하는데(OpenAI 문서도 스트림이 끊기면 마지막 사용량 청크를 받지 못할 수 있다고 안내합니다), 그때까지 만들어진 출력 토큰에는 요금이 발생할 수 있습니다. 끊긴 호출을 따로 표시해 두지 않으면 집계가 콘솔 값보다 계속 작게 나옵니다.
콘솔 사용량과 직접 집계한 값이 다른데 왜인가요
원인은 크게 세 가지입니다. 첫째는 캐시 토큰입니다. Anthropic은 입력 토큰을 세 필드로 나눠 주므로 input_tokens 하나만 더하면 실제보다 작게 집계됩니다. 둘째는 추론 토큰으로, 응답 텍스트에는 나타나지 않지만 출력 토큰에 포함됩니다. 셋째는 실패한 호출입니다. 타임아웃이나 연결 끊김으로 끝나도 그때까지 처리한 토큰은 요금에 포함될 수 있습니다.
클로드나 챗GPT 구독 사용량도 같은 방법으로 볼 수 있나요
API 키로 호출하는 Claude와 GPT 모델 사용량은 응답 본문에서 호출별 토큰 수를, 응답 헤더에서 남은 한도를 읽으면 됩니다. 구독 요금제는 다릅니다. 계정도 한도도 API와 별개라 구독 쪽 사용량은 해당 서비스 화면에서 확인해야 하고, 응답 헤더와 응답 본문의 사용량 필드는 API 키로 호출할 때만 내려옵니다. 구독 계정으로 쓰는 개발 도구의 사용량을 보시려면 Claude Code 모니터링 가이드를 참고하세요.
토큰 수를 호출하기 전에 미리 알 수 있나요
입력 토큰은 보내기 전에 계산할 수 있습니다. 제공사마다 토큰 계산 도구나 사전 계산 엔드포인트가 있습니다. 출력 토큰은 생성이 끝나야 알 수 있어 미리 계산할 수 없고, 요청에 담는 최대 출력 길이로 상한만 정할 수 있습니다. 다만 Anthropic 문서는 최대 출력 길이(max_tokens)가 OTPM 한도 계산에는 들어가지 않는다고 설명합니다. 한도에는 실제로 생성된 토큰만 반영됩니다.
한도를 올리면 사용량 관리를 안 해도 되나요
한도를 올리면 429로 막히던 호출까지 처리되므로 그 호출분 요금이 더 나갑니다. 한도를 올린다고 적정 사용량이 정해지지는 않습니다. 상향을 요청하기 전에 콘솔의 한도 차트에서 실제 최대 사용량이 한도에 얼마나 가까웠는지 확인하고, 무엇 때문에 한도를 넘었는지 본 뒤에 올릴지 정하는 편이 낫습니다.
마치며
토큰 사용량은 세 군데에서 볼 수 있고, 어디를 보느냐에 따라 답할 수 있는 질문이 다릅니다. 이번 달 누적 사용량은 콘솔에서 봅니다. 이번 호출이 쓴 토큰은 응답 본문에, 남은 한도는 응답 헤더에 들어 있습니다. 콘솔, 응답 본문, 응답 헤더의 값이 서로 달라 보이는 것은 위치마다 집계 대상과 기준이 다르기 때문입니다.
지난 시점의 사용량을 확인하려면 그때 호출마다 값을 남겨 뒀어야 합니다. 와탭 AI Agent Observability는 애플리케이션이 보낸 LLM 호출을 모델별로 기록하고, 입력 토큰과 출력 토큰, 캐시 사용량과 응답 시간을 함께 남깁니다. AI Agent Observability 소개 (와탭 공식 문서)에서 주요 기능을 확인해 보세요.
더 읽을거리