담당자가 프로모션 코드를 발송해 드립니다.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
WhaTap AI를 경험해 보세요.
MTTR, MTBF, MTTD, MTTF 뜻과 차이, 계산법까지
월간 운영 보고서나 장애 회고 문서를 쓸 때는 첫 장에 장애 대응 성과를 숫자로 요약하는 경우가 많습니다. 이번 달 장애 3건, 평균 감지 12분(MTTD), 평균 복구 60분(MTTR)처럼 장애를 얼마나 빨리 알아차리고 서비스를 얼마나 빨리 복구했는지 보여 주는 숫자입니다.
장애 대응 지표와 신뢰성 지표로는 MTTD, MTTR, MTBF, MTTF 네 가지를 주로 씁니다. 네 약어 모두 MT(Mean Time, 평균 시간)로 시작해 이름만으로는 구분하기 어렵지만, 장애 타임라인에서 측정하는 구간은 서로 다릅니다.
MTTD는 장애를 알아차리기까지, MTTR은 장애가 난 서비스를 복구하기까지 걸린 평균 시간입니다. MTBF는 고쳐서 다시 쓰는 시스템이 장애 없이 동작한 평균 시간이고, MTTF는 고장 나면 교체하는 부품이 고장 나기까지 동작한 평균 시간입니다.
네 지표의 계산식은 단순하지만, 측정 기준을 어떻게 잡느냐에 따라 값이 달라집니다. 같은 MTTR이라도 장애 발생 시각부터 측정한 팀과 감지 시각부터 측정한 팀의 숫자는 나란히 비교할 수 없습니다.
MTTD, MTTR, MTBF, MTTF 뜻
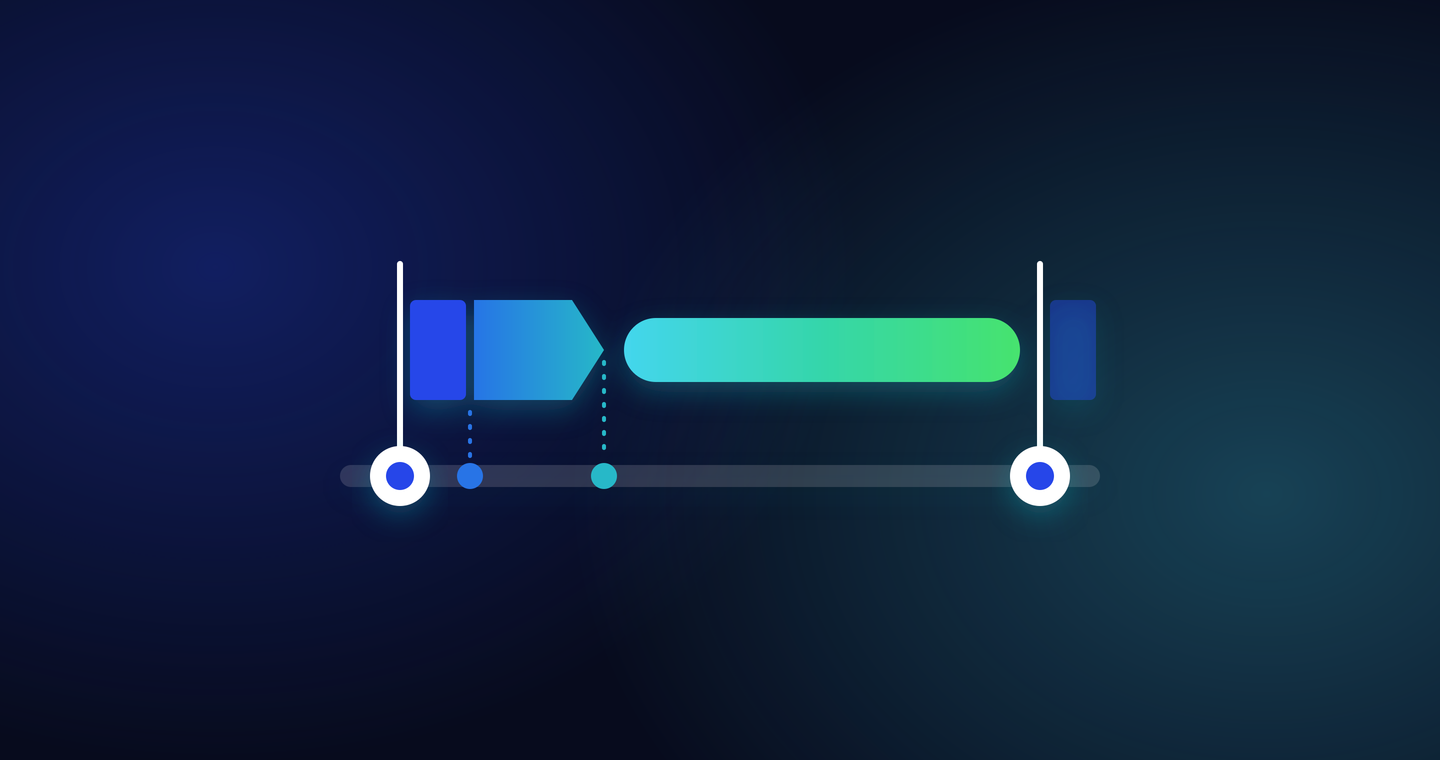
장애 하나가 지나가는 과정을 시간 순서로 보면 발생, 감지, 복구, 정상 운영을 거쳐 다음 장애로 이어집니다. 네 지표는 장애 타임라인을 서로 다른 구간으로 잘라 평균을 낸 값입니다.
| 지표 | 원어와 우리말 | 측정 구간 | 좋은 방향 | 주로 개선하는 곳 |
|---|---|---|---|---|
| MTTD | Mean Time To Detect, 평균 감지 시간 | 장애 발생부터 감지까지 | 짧을수록 좋음 | 모니터링과 알림 체계 |
| MTTR | Mean Time To Repair 또는 Recovery, 평균 복구 시간 | 장애 발생(또는 감지)부터 복구까지 | 짧을수록 좋음 | 장애 대응 절차 |
| MTBF | Mean Time Between Failures, 평균 고장 간격 | 복구부터 다음 장애까지 | 길수록 좋음 | 배포 전 테스트와 용량 확보 |
| MTTF | Mean Time To Failure, 평균 고장 시간 | 사용 시작부터 고장까지 | 길수록 좋음 | 부품 품질과 교체 주기 |
MTTD(평균 감지 시간)
MTTD는 장애가 시작된 시각부터 운영팀이 장애를 알아차린 시각까지 걸린 시간의 평균입니다. 감지 시점은 보통 알림이 울린 시각이나 사용자 문의가 처음 들어온 시각으로 잡지만, 팀마다 기준이 조금씩 다를 수 있습니다.
MTTD를 기록할 때 헷갈리기 쉬운 부분은 시작 시각입니다. 장애가 실제로 언제 시작됐는지는 장애가 진행되는 동안에는 알기 어렵고, 복구한 뒤에 로그와 지표 그래프를 거슬러 올라가 확인하는 경우가 많습니다. MTTD를 꾸준히 기록하려면 장애 회고 때 실제 시작 시각을 함께 남겨 둡니다.
MTTR(평균 복구 시간)
MTTR은 장애가 난 서비스를 정상 상태로 되돌리기까지 걸린 시간의 평균입니다. 계산은 간단하지만 팀마다 MTTR에 넣는 시간이 다른 경우가 많습니다. MTTR 숫자를 읽을 때는 약어 끝의 R이 무엇을 뜻하는지, 측정을 언제 시작했는지 두 가지를 먼저 확인합니다.
R은 조직과 분야에 따라 다음과 같이 다르게 쓰입니다.
- Repair(수리): 고장 난 장비나 부품을 고치는 데 걸린 시간. 하드웨어 유지보수에서 주로 씁니다.
- Recovery, Restore(복구, 복원): 사용자가 서비스를 다시 쓸 수 있게 되기까지 걸린 시간. 소프트웨어 서비스 운영에서 가장 흔한 뜻입니다.
- Resolve(해결): 근본 원인을 고치고 재발 방지 조치를 마치기까지 걸린 시간. 복구보다 길게 나옵니다.
- Respond(대응): 장애 대응에 걸린 시간을 가리키며, 어디서 시작해 어디서 끝나는지는 조직마다 다릅니다.
R의 뜻이 정해져도 측정을 시작하는 시점은 팀마다 다릅니다. 장애가 발생한 시각부터 측정하는 팀이 있고, 장애를 감지한 시각부터 측정하는 팀이 있습니다. 발생 시각부터 측정하면 MTTR에 감지까지 걸린 시간이 들어가고, 감지 시각부터 측정하면 빠집니다. 같은 장애라도 두 기준으로 계산한 MTTR은 감지에 걸린 시간만큼 차이가 납니다.
측정 범위를 어떻게 잡을지는 업계 기준에서도 바뀌어 왔습니다. 소프트웨어 배포 성과 지표를 연구하는 DORA(DevOps Research and Assessment)는 예전에 서비스 복원 시간(time to restore service)이라는 지표를 썼습니다. 2023년부터는 배포가 실패해 즉시 조치가 필요할 때 회복하기까지 걸린 시간(failed deployment recovery time)으로 측정 범위를 좁혔습니다.
MTTR을 보고서에 넣을 때는 R이 무엇이고 어디서 시작해 어디서 끝나는 시간인지 한 줄로 함께 밝혀 두면 좋습니다. 다른 팀이나 지난 분기의 MTTR과 비교할 때도 측정 기준이 같은지부터 확인합니다.
MTBF(평균 고장 간격)
MTBF는 고장을 고쳐 다시 쓰는 시스템에서, 한 번 복구한 뒤 다음 장애가 날 때까지 정상으로 동작한 시간의 평균입니다. 웹 서비스나 서버가 대표적입니다. MTBF가 길수록 장애가 드물게 난다는 뜻입니다.
MTTF(평균 고장 시간)
MTTF는 수리하지 않고 교체하는 부품을 처음 쓰기 시작한 뒤 고장 날 때까지 동작한 시간의 평균입니다. 디스크, 전원 장치, 팬처럼 고장 나면 새것으로 바꾸는 부품의 수명을 추정할 때 씁니다. 미국 국립표준기술연구소(NIST)의 통계 핸드북도 수리 가능한 시스템(repairable system)과 고장 나면 빠지는 부품 집단(non-repairable population)을 나눠 다룹니다. 신뢰성 공학에서는 대개 수리 가능한 시스템에 MTBF를, 교체하는 부품에 MTTF를 씁니다.
MTTD, MTTR, MTBF, MTTF 계산법과 예시
네 지표의 계산식은 모두 "구간 시간의 합 ÷ 건수"입니다. 어떤 구간을 더하느냐만 다릅니다.
| 지표 | 계산식 |
|---|---|
| MTTD | 각 장애의 (감지 시각 − 발생 시각) 합 ÷ 장애 건수 |
| MTTR | 각 장애의 (복구 시각 − 발생 시각) 합 ÷ 장애 건수. 감지 시각 기준이면 발생 시각 대신 감지 시각을 뺌 |
| MTBF | 정상 동작 시간 합 ÷ 장애 건수 |
| MTTF | 부품별 사용 시작부터 고장까지 시간 합 ÷ 고장 난 부품 수 |
한 달치 장애 기록으로 MTTD, MTTR, MTBF 계산하기
30일(720시간) 동안 운영한 서비스에서 장애가 세 번 났다고 가정합니다.
| 장애 | 발생부터 감지까지 | 감지부터 복구까지 | 서비스 중단 시간 |
|---|---|---|---|
| 장애 A | 20분 | 60분 | 80분 |
| 장애 B | 5분 | 25분 | 30분 |
| 장애 C | 11분 | 59분 | 70분 |
| 합계 | 36분 | 144분 | 180분 |
- MTTD: 36분 ÷ 3건 = 12분
- MTTR(발생 시각 기준): 180분 ÷ 3건 = 60분
- MTTR(감지 시각 기준): 144분 ÷ 3건 = 48분
- MTBF: 정상 동작 시간은 720시간에서 중단 시간 3시간을 뺀 717시간이므로 717시간 ÷ 3건 = 239시간
계산 결과를 장애 타임라인에 다시 놓으면, 발생 시각 기준 MTTR 60분은 장애를 알아차리기까지 걸린 12분(MTTD)과 알아차린 뒤 복구하기까지 걸린 48분으로 나뉩니다. 60분 가운데 감지 구간이 20%, 복구 구간이 80%를 차지합니다.
MTTR을 구간으로 나눠 보면 어디부터 개선할지 정할 수 있습니다. 감지 시간을 절반으로 줄여도 MTTR은 6분 줄어들지만, 감지 뒤 복구 시간을 4분의 1만 줄여도 12분이 줄어듭니다. 한 달치 장애 예시처럼 복구 구간이 긴 서비스라면 대응 절차와 롤백(문제가 생긴 배포를 이전 버전으로 되돌리는 작업) 방법을 먼저 점검하는 편이 MTTR을 더 많이 줄일 수 있습니다.
감지 구간도 장애별로 보면 개선할 곳이 드러납니다. 장애 A는 알아차리기까지 20분이 걸려 세 장애 가운데 가장 늦었습니다. 장애 A와 같은 유형을 잡아낼 알림 조건이 있었는지 확인하고 보완하면 다음 장애의 MTTD를 줄일 수 있습니다. 평소 패턴에서 벗어난 변화를 알림으로 잡는 방법은 정적 임계값과 동적 기준선 차이, 이상 탐지 알림 설계에 정리했습니다.
MTBF까지는 서비스의 장애 기록으로 계산했지만, MTTF는 교체 부품 기록으로 계산합니다. 서버 디스크 4개가 각각 20,000시간, 30,000시간, 25,000시간, 35,000시간을 쓰고 고장 났다면 MTTF는 110,000시간 ÷ 4개 = 27,500시간입니다.
MTBF와 MTTR로 가용성 계산하기
가용성(availability)은 전체 시간 가운데 서비스가 정상으로 동작한 시간의 비율입니다. MTBF와 MTTR을 알면 다음 식으로 계산할 수 있습니다.
가용성 = MTBF ÷ (MTBF + MTTR)
가용성 식에 넣는 MTTR은 서비스가 멈춘 시간 전체를 담은 발생 시각 기준 값이어야 합니다. 한 달치 장애 예시에 넣으면 239시간 ÷ (239시간 + 1시간) = 약 99.58%이고, 717시간 ÷ 720시간으로 직접 계산한 값과 같습니다. 감지 시각 기준 MTTR 48분을 넣으면 약 99.67%가 나와, 실제보다 가용성이 높게 계산됩니다.
MTTR, MTBF, MTTD, MTTF 차이와 관계
MTTR과 MTBF 차이
MTTR은 장애가 났을 때 서비스를 얼마나 빨리 복구하는지, MTBF는 장애가 얼마나 드물게 나는지 나타냅니다. 개선하는 방법도 다릅니다. MTTR은 감지 알림, 대응 절차, 롤백처럼 장애가 난 뒤의 대응을 개선해서 줄입니다. 반면 MTBF를 늘리려면 배포 전 테스트, 용량 확보, 이중화(같은 구성을 여러 벌 두어 하나가 멈춰도 서비스가 이어지게 하는 방식)처럼 장애를 예방하는 준비가 필요합니다.
가용성이 같아도 MTTR과 MTBF 조합은 다를 수 있습니다. 한 달에 1시간 걸린 장애가 3번 난 서비스와 20분 걸린 장애가 9번 난 서비스는 중단 시간이 똑같이 3시간입니다. 장애가 3번 난 서비스는 복구 속도를 먼저 살펴보고, 장애가 9번 난 서비스는 장애가 잦은 원인부터 확인하는 편이 맞습니다. 가용성 하나보다 MTTR과 MTBF를 함께 볼 때 대응 방향이 분명해집니다.
MTTD와 MTTR 차이, 함께 봐야 하는 이유
MTTD는 장애가 난 뒤 알아차리기까지 걸린 평균 시간이고, MTTR은 복구까지 걸린 평균 시간이라 발생 시각 기준 MTTR 안에는 MTTD가 들어 있습니다.
MTTR을 어느 시각부터 측정하느냐에 따라, 감지를 앞당긴 효과가 MTTR에 드러나기도 하고 드러나지 않기도 합니다. 발생 시각 기준 MTTR에서는 감지를 앞당긴 만큼 MTTR도 줄어듭니다. 감지 시각 기준 MTTR에서는 감지가 아무리 빨라져도 MTTR이 그대로라, 알림을 개선한 효과는 MTTD로만 확인할 수 있습니다. 그래서 MTTD와 MTTR은 보통 함께 기록하고 같은 보고서에 나란히 둡니다.
MTBF와 MTTF 차이
MTBF와 MTTF는 모두 장애 없이 동작한 시간의 평균이지만 적용하는 대상이 다릅니다. MTBF는 수리 가능한 시스템에, MTTF는 고장 나면 교체하는 부품에 씁니다.
다만 제조사 사양서는 디스크나 전원 장치처럼 교체하는 부품에도 관례상 MTBF로 표기합니다. 사양서의 MTBF는 교체 부품의 수치라서 MTTF와 같은 뜻으로 읽으면 됩니다.
MTBF를 계산하는 두 가지 기준
MTBF는 계산 기준이 두 가지라, 자료마다 MTBF 값이 조금씩 다르게 나온다면 어느 기준을 썼는지 먼저 확인합니다.
- 정상 동작 시간 기준: 정상으로 동작한 시간의 합을 장애 건수로 나눕니다. 한 달치 장애 예시의 239시간이 정상 동작 시간 기준 MTBF이고, 가용성 식 MTBF ÷ (MTBF + MTTR)에 넣는 값도 정상 동작 시간 기준 MTBF입니다.
- 장애 간격 기준: 장애가 시작된 시각부터 다음 장애가 시작된 시각까지를 한 간격으로 봅니다. 한 간격 안에는 정상 동작 구간과 복구 구간이 함께 들어 있어서, 정상 동작 구간의 평균을 따로 MTTF라고 부르고 MTBF = MTTF + MTTR로 계산합니다.
장애 간격 기준에서 쓰는 MTTF는 교체 부품의 MTTF와 이름만 같고 대상이 다릅니다. 교체 부품이 아니라 수리 가능한 시스템이 복구 뒤 다음 장애까지 정상으로 동작한 시간을 가리킵니다.
한 달치 장애 예시를 장애 간격 기준으로 바꾸면 239시간 + 1시간 = 240시간입니다. 240시간은 관측 기간 720시간을 장애 3건으로 나눈 값과 같습니다.
두 기준의 값은 모두 추정치입니다. 30일 안에는 관측 시작부터 첫 장애까지, 마지막 복구부터 관측 종료까지처럼 중간에 잘린 구간이 섞여 있습니다. 처음과 끝이 모두 관측된 장애 시작 사이의 간격은 두 개뿐이고, 간격 두 개의 평균은 장애가 언제 났느냐에 따라 달라집니다. 관측 기간이 길고 장애 건수가 많을수록 추정치는 실제 평균에 가까워집니다.
장애 간격 기준 MTBF로 가용성을 계산할 때는 식이 MTTF ÷ MTBF로 바뀝니다. 한 달치 장애 예시에 넣으면 239시간 ÷ 240시간 = 약 99.58%로, 정상 동작 시간 기준으로 계산한 가용성과 같습니다.
MTBF 100만 시간이면 부품이 114년을 버티나요
그렇지 않습니다. 디스크 사양서에 MTBF 100만 시간이라고 쓰여 있으면 시간으로는 약 114년이지만, 디스크 한 개가 114년 동안 버틴다는 뜻은 아닙니다. 사양서의 MTBF는 같은 부품을 많이 모아 함께 가동했을 때 얼마나 자주 고장 나는지를 나타내는 값입니다.
고장 확률이 일정하다고 가정하면, MTBF 100만 시간인 디스크 1,000개를 1년(8,760시간) 동안 가동했을 때 약 8.76개가 고장 난다고 예상할 수 있습니다. 연간 고장률로 바꾸면 약 0.88%입니다. 실제 부품은 오래 쓸수록 마모로 고장 확률이 높아질 수 있어서, 사양서 수치는 제조사가 정한 사용 조건과 기간 안에서 읽어야 합니다.
MTTR 평균값의 한계, 운영 보고서에서 함께 볼 값
MTTD, MTTR, MTBF, MTTF는 모두 여러 장애를 평균 낸 값이라, 장애 몇 건이 평균을 크게 움직일 수 있습니다. 장애 기간은 대부분 짧게 끝나고 몇 건만 아주 길게 늘어지는 모양으로 분포하는 경우가 많습니다. 장애가 한 달에 몇 건뿐인 팀에서는 긴 장애 하나가 들어오고 빠지는 것만으로 MTTR이 크게 흔들립니다. 한 달치 장애 예시에서도 80분 걸린 장애 A가 없었다면 MTTR은 60분이 아니라 50분이 됩니다.
Google SRE 엔지니어가 쓰고 O'Reilly와 Google이 2021년에 함께 펴낸 보고서 「Incident Metrics in SRE」는 세 회사의 공개 장애 데이터로 시뮬레이션해 평균이 흔들리는 정도를 보여 줍니다. 보고서가 분석한 장애 기간도 대부분 짧고 일부만 길게 늘어지는, 로그정규분포에 가까운 모양이었습니다. 장애 시간이 실제로는 그대로라고 가정한 시뮬레이션에서도, 한 회사 데이터에서는 MTTR이 30분 이상 좋아진 것처럼 보일 확률이 19%였습니다.
보고서는 MTTR 같은 통계로 장애 대응이 나아졌는지 판단하거나 추세를 분석하기는 어렵다고 결론 내립니다. 평균 대신 중앙값을 써도 같은 한계가 남는다고 설명합니다.
운영 보고서에 MTTR 평균 하나만 올리면 대응이 실제로 빨라졌는지, 긴 장애가 우연히 빠졌는지 구분할 수 없습니다. 평균값과 함께 다음 값을 올리면 숫자를 해석하기 쉬워집니다.
- 장애 건수: 평균을 낸 장애가 몇 건인지 밝힙니다. 건수가 적을수록 평균이 크게 흔들립니다.
- 장애별 복구 시간: 장애마다 걸린 시간을 표로 정리해, 평균을 끌어올린 장애가 어느 것인지 확인합니다.
- 가장 오래 걸린 장애: 가장 긴 장애의 시간과 원인을 따로 기록합니다. RTO(Recovery Time Objective, 장애가 났을 때 허용하는 최대 복구 시간) 같은 상한선을 넘긴 장애가 있었는지도 함께 확인합니다.
- 측정 기준: R의 뜻과 측정 시작 시점을 밝힙니다.
MTTR이 지난달보다 줄었다면 장애별 복구 시간을 나란히 놓고, 긴 장애 한두 건이 빠져서 생긴 변화는 아닌지 확인한 뒤 판단합니다.
자주 묻는 질문
MTTA는 MTTD와 어떻게 다른가요
MTTA(Mean Time To Acknowledge, 평균 확인 시간)는 보통 알림이 나간 뒤 담당자가 알림을 확인하기까지 걸린 시간의 평균을 가리킵니다. MTTD는 장애를 감지하기까지, MTTA는 알림을 받은 사람이 반응하기까지 걸린 시간이라 둘은 측정 구간이 이어져 있습니다. 알림은 제때 울렸는데 담당자가 바로 확인하지 못해 복구가 늦어졌다면 MTTD가 아니라 MTTA가 길어진 경우입니다. MTTA가 길다면 온콜(장애가 나면 연락을 받아 대응하는 당번) 순번과 알림 채널을 점검해 볼 만합니다.
MTTR이 RTO보다 짧으면 목표를 지키고 있다고 봐도 되나요
평균만으로는 알 수 없습니다. RTO는 장애 한 건 한 건에 적용하는 복구 시간의 상한선이고, MTTR은 여러 장애를 평균 낸 값입니다. MTTR이 60분이고 RTO가 2시간이어도 복구에 3시간 걸린 장애가 하나 있었다면, 3시간 걸린 장애는 목표를 넘겼습니다. RTO를 지키는지는 장애별 복구 시간으로 확인합니다. RTO를 정하는 방법은 RTO와 RPO란? 뜻과 차이, 재해복구(DR) 전략까지에 정리했습니다.
가용성 99.9%를 지키려면 MTTR은 얼마여야 하나요
30일(43,200분) 기준으로 가용성 99.9%가 허용하는 중단 시간은 약 43분입니다. 한 달에 장애가 한 번 난다면 장애 한 건을 43분 안에 복구해야 하고, 세 번 난다면 장애당 평균 14분 남짓에 복구해야 합니다. 장애 건수가 늘수록 같은 가용성을 지키는 데 필요한 MTTR이 짧아지므로, 목표 가용성을 정할 때는 한 달에 예상하는 장애 건수도 함께 따져 봅니다. 가용성 목표를 정하고 관리하는 방법은 SLO란 무엇인가? SLI, SLA 차이와 에러 예산으로 서비스 신뢰성 관리하기에서 다룹니다.
마치며
MTTD, MTTR, MTBF, MTTF는 계산식보다 측정 기준을 맞추는 일이 더 까다롭습니다. 숫자를 남길 때는 어느 구간을 측정했는지 함께 기록하고, 평균과 장애 건수, 장애별 시간을 같이 확인하면 어디부터 개선할지 정하기 쉬워집니다.
발생 시각 기준 MTTR에는 장애를 알아차리기까지 걸린 시간도 들어 있어서, 감지가 늦으면 복구를 아무리 서둘러도 MTTR이 길어집니다. 와탭 경고 알림으로 모니터링 대상의 이상 징후를 감지하고 여러 채널로 담당자에게 알릴 수 있습니다. 알림 방식과 설정 범위는 경고 알림 문서에서 확인해 보세요.
더 읽을거리