담당자가 프로모션 코드를 발송해 드립니다.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
WhaTap AI를 경험해 보세요.
OOMKilled와 Exit Code 137 원인과 해결 방법
쿠버네티스에 서비스를 올릴 때는 보통 배포 매니페스트의 resources에 컨테이너가 사용할 수 있는 메모리 상한(limits)과 파드를 노드에 배치할 때 기준이 되는 메모리 요청량(requests)을 설정합니다. 예를 들어 limits.memory: 512Mi처럼 지정합니다. 그런데 서비스를 운영하다 보면 파드의 재시작 횟수(RESTARTS)가 계속 늘어나는 경우가 있습니다. 이때 kubectl describe pod로 상태를 확인하면 컨테이너 항목에 다음과 같은 기록이 남아 있을 수 있습니다.
Last State:     Terminated
  Reason:       OOMKilled
  Exit Code:    137
Reason과 Exit Code는 뜻이 다릅니다. Exit Code 137은 프로세스가 SIGKILL(프로세스가 정리할 틈 없이 즉시 끝나는 강제 종료 신호)을 받고 종료됐다는 뜻입니다. 반면 Reason은 쿠버네티스가 기록한 종료 사유로, 메모리 부족으로 커널의 OOM 킬러가 프로세스를 종료했다면 OOMKilled가 표시됩니다. OOMKilled는 컨테이너가 메모리 한도를 넘었거나 노드 메모리가 고갈되어, 리눅스 커널의 OOM(Out of Memory) 킬러가 그 컨테이너의 프로세스를 강제로 종료했다는 종료 사유입니다. OOM 킬러는 메모리가 모자랄 때 프로세스를 골라 끝내는 커널 기능입니다.
OOMKilled를 확인했다면 다음으로 메모리가 부족해진 원인을 파악해야 합니다. 원인에 따라 한도를 올릴지, 파드 수를 늘릴지, 코드나 힙 설정을 고칠지가 달라집니다. CrashLoopBackOff에서 메모리 초과를 가려내는 방법은 시리즈 1편에서 정리했고, 이번 편은 OOMKilled를 확인한 다음 단계부터 다룹니다.
명령은 Kubernetes 1.30 이상, cgroup v2를 쓰는 리눅스 노드 기준입니다. cgroup은 리눅스가 프로세스 묶음별로 CPU와 메모리 사용량을 제한하는 기능이고, 쿠버네티스는 이 기능으로 컨테이너의 limits를 적용합니다.
OOMKilled가 보일 때 먼저 확인할 kubectl 명령 3가지
아래 명령은 kubectl로 클러스터에 접근할 수 있는 환경에서 실행합니다. 노드에 접속해야 볼 수 있는 커널 로그는 뒤의 "OOMKilled 원인이 안 보일 때, 노드 메모리 부족과 커널 로그 확인하기" 절에 따로 모았습니다.
# 1. 컨테이너별 직전 종료 사유, 종료 코드, 재시작 횟수
  kubectl get pod <파드> -n <네임스페이스> \
    -o jsonpath='{range .status.containerStatuses[*]}{.name}{"\t"}{.lastState.terminated.reason}{"\t"}{.lastState.terminated.exitCode}{"\t"}{.restartCount}{"\n"}{end}'

# 2. 네임스페이스에 남은 메모리 관련 이벤트
  kubectl get events -n <네임스페이스> --sort-by=.lastTimestamp | grep -iE 'oom|evict|killing|unhealthy|back-off'

# 3. 현재 메모리 사용량과 설정한 requests, limits (첫 줄은 metrics-server 필요)
  kubectl top pod <파드> -n <네임스페이스> --containers
  kubectl get pod <파드> -n <네임스페이스> \
    -o jsonpath='{range .spec.containers[*]}{.name}{"\t"}{.resources}{"\n"}{end}'
3번 첫 줄의 kubectl top은 클러스터에 metrics-server(노드와 파드의 현재 사용량을 모아 주는 구성 요소)가 설치돼 있어야 동작합니다. API 서버는 기본 설정에서 이벤트를 1시간 정도만 보관하므로 2번은 종료 직후에 먼저 확인하는 편이 좋습니다. 1번 결과로 컨테이너마다 직전 종료 사유와 종료 코드를 확인하고, 아래 표에서 다음에 볼 절을 찾습니다.
표의 kubelet은 노드마다 떠서 파드를 실행하고 관리하는 쿠버네티스 에이전트입니다. 힙은 Java 같은 런타임이 객체를 담는 메모리 영역입니다.
OOMKilled 원인 4가지와 해결 방법
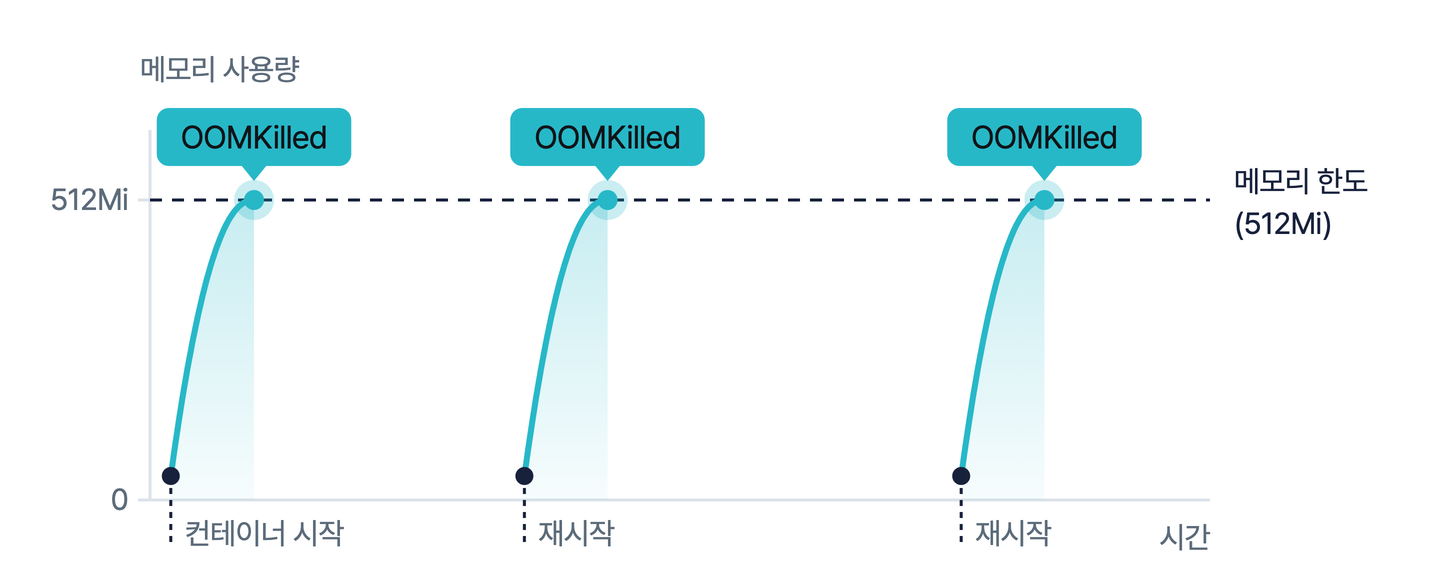
OOMKilled가 한 번이 아니라 반복된다면, 종료 시각을 트래픽 그래프나 배포 시각과 나란히 놓고 종료 패턴을 봅니다. 패턴마다 먼저 의심할 원인이 다릅니다.
종료 패턴으로 원인 후보를 좁히고, 원인은 앞의 명령 결과와 로그로 확인합니다. 네 번째 패턴처럼 노드 쪽 원인이 의심되면 "OOMKilled 원인이 안 보일 때, 노드 메모리 부족과 커널 로그 확인하기" 절의 커널 로그와 QoS 클래스 부분을 함께 봅니다.
OOMKilled 확인 사례, 트래픽 피크마다 파드가 재시작될 때
주문 API를 처리하는 파드 2개(replicas 2)에 limits.memory: 512Mi, requests.memory: 256Mi를 넣어 운영한다고 가정합니다. 점심시간마다 재시작 알림이 오고, 오후 3시에 앞의 명령 세 개를 실행한 결과는 다음과 같습니다.
# 1번 결과
  order-api	OOMKilled	137	6

# 2번 결과
  (출력 없음)

# 3번 결과
  POD                      NAME        CPU(cores)   MEMORY(bytes)
  order-api-6f7c9d-x2k4p   order-api   85m          290Mi
1번에서 OOMKilled와 재시작 6회를 확인했습니다. 2번은 정오 무렵의 이벤트가 보존 시간 1시간이 지나 나오지 않았지만, 1번 사유가 OOMKilled이고 같은 파드에서 재시작 횟수가 오르고 있으니 노드 축출은 아닙니다. 3번의 290Mi는 피크가 지난 뒤의 값이라 한도 512Mi와 거리가 멉니다. 수집해 둔 메모리 그래프를 보니 재시작 시각이 모두 정오 전후였고 그 직전 사용량은 512Mi 근처까지 올라 있었으므로, 종료 패턴 표의 첫 줄인 한도 부족을 먼저 의심할 수 있습니다.
해결 방법은 두 가지입니다. 한도를 올린다면 limits를 768Mi로, requests를 평상시 사용량 근처인 320Mi로 다시 정합니다. 사용량이 512Mi에서 잘려 실제 피크 수요가 그래프에 다 드러나지 않으므로, 다음 피크의 최대값을 보고 한 번 더 맞춥니다. 메모리가 동시 요청 수에 비례해 늘어나는 서비스라면 replicas를 2에서 4로 늘려 파드 하나가 받는 피크 요청을 줄이는 방법도 있습니다. 두 방법을 고르는 기준은 아래 replicas 절에 정리했습니다.
메모리 한도가 피크보다 낮을 때, limits와 requests 다시 정하기
부하 테스트로 정한 한도보다 실제 트래픽 피크나 야간 배치 때 사용량이 더 큰 경우가 있습니다. 평소 kubectl top 값이 한도의 절반이어도 피크 몇 분 동안 한도를 넘으면 그때 종료됩니다. kubectl top은 현재 값만 보여 주므로, 지난 피크는 cAdvisor(kubelet에 들어 있는 컨테이너 사용량 수집기)의 container_memory_working_set_bytes처럼 시계열로 수집한 메트릭에서 확인합니다. 워킹 셋(working set)은 전체 사용량에서 바로 회수할 수 있는 비활성 파일 캐시를 뺀 값으로, 쿠버네티스가 메모리 사용량을 판단할 때 쓰는 기준입니다.
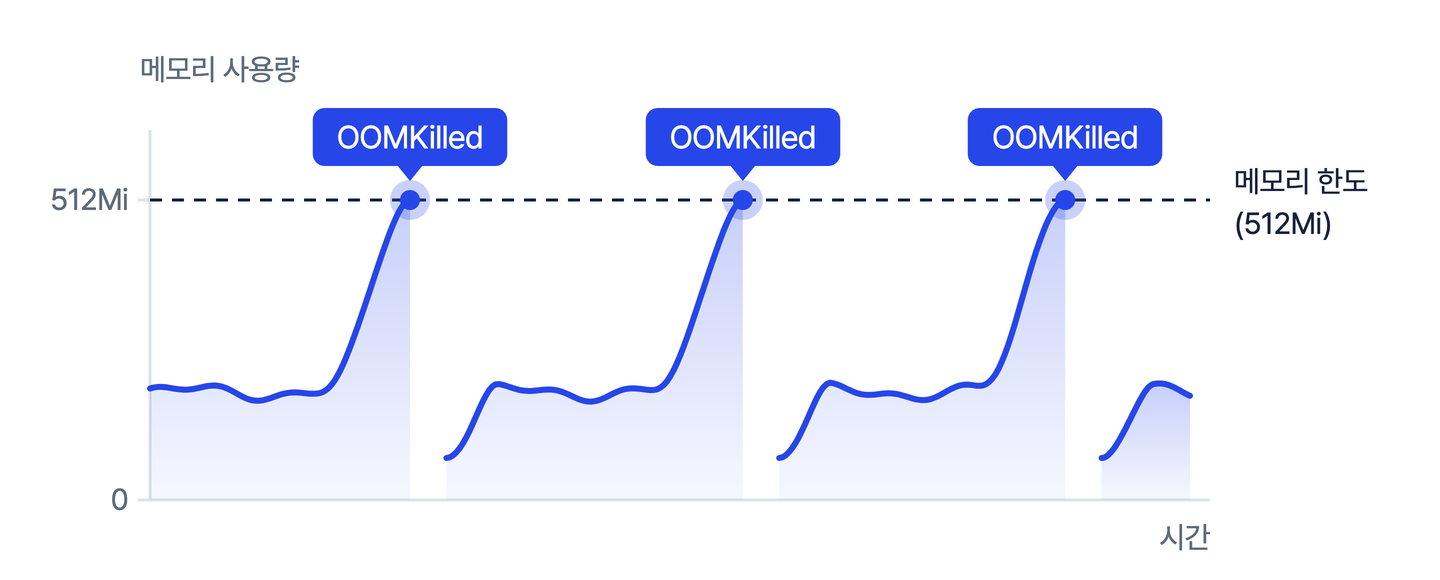
requests와 limits는 다음 순서로 다시 정합니다.
- 관측 기간 정하기: 평일 피크, 배치 시간, 배포 직후가 모두 들어가는 기간 동안 컨테이너별 워킹 셋의 최대값과 평상시 값을 모읍니다.
- limits 정하기: 관측한 최대값에 여유를 더합니다. 여유 크기는 사용량이 늘어나는 모양에 따라 다릅니다. 완만하게 오르는 서비스는 작게, 요청 하나로 순간 사용량이 크게 뛰는 서비스는 크게 둡니다.
- requests 정하기: 평상시 사용량 근처로 맞춥니다. requests가 실제 사용량보다 낮으면 노드 메모리가 부족할 때 먼저 종료될 수 있고, requests를 높이면 그만큼 노드 자원을 예약해 노드 하나에 올릴 수 있는 파드 수가 줄어듭니다.
- 런타임 힙 맞추기: limits를 바꾼 뒤 JVM 같은 런타임의 힙 최대 크기가 의도대로 바뀌었는지 아래 JVM 절의 jcmd 명령으로 확인합니다.
- 적용 후 확인: 피크를 한 번 이상 지나며 재시작 횟수가 더 오르지 않는지, 피크 때 워킹 셋이 새 limits 아래에 머무는지 확인합니다.
메모리 누수인지 확인하기
재시작 직후에, 낮았던 사용량이 트래픽과 상관없이 같은 기울기로 계속 오르다 한도에서 종료되고, 재시작 후 같은 모양이 반복되면 누수를 의심합니다. 그래프로 보면 톱니 모양입니다. 누수가 원인이면 한도를 올려도 종료 간격만 길어집니다.
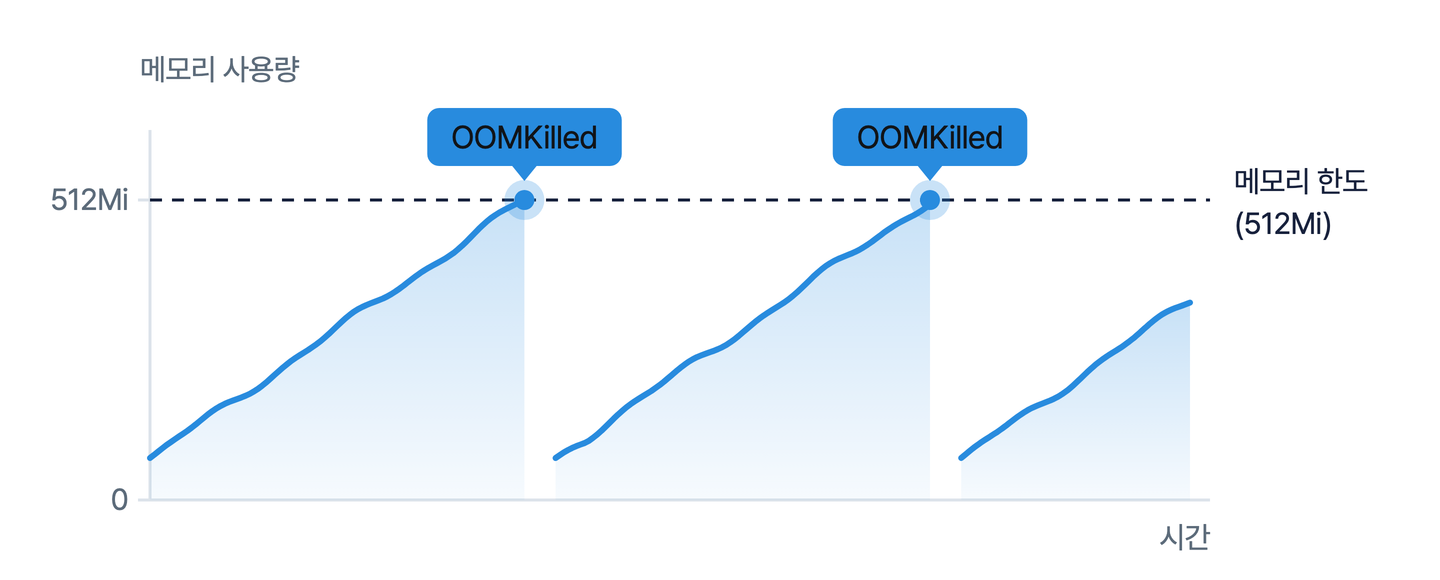
GC를 쓰는 런타임은 확보한 메모리를 바로 운영체제에 돌려주지 않기 때문에 사용량이 오른다는 사실만으로 누수라고 단정하기는 어렵습니다. 전체 GC(Full GC)가 끝난 직후의 바닥 값이 시간이 지날수록 올라가는지를 기준으로 봅니다. Java라면 종료 전에 힙 덤프(그 순간 힙에 있는 객체를 파일로 저장한 것)를 만들어 어떤 객체가 쌓이는지 확인합니다.
# 힙 덤프 생성 후 로컬로 복사 (JDK 이미지, PID 1이 java인 경우)
kubectl exec <파드> -n <네임스페이스> -- jcmd 1 GC.heap_dump /tmp/heap.hprof
kubectl cp <네임스페이스>/<파드>:/tmp/heap.hprof ./heap.hprof
JVM 힙 설정 확인, MaxRAMPercentage 기본값 25%
힙 최대 크기를 컨테이너 한도와 같게 정하면 힙 밖의 메모리 때문에 한도를 넘는다는 점은 1편에서 소개했습니다. 이번에는 힙 최대 크기를 따로 정하지 않은 경우입니다.
-XX:+UseContainerSupport가 기본으로 켜져 있어(cgroup v2 노드는 JDK 8u372, 11.0.16, 15 이후 버전부터), JVM이 컨테이너 한도를 전체 메모리로 보고 그중 일정 비율을 힙 최대 크기로 정합니다. 비율을 정하는 -XX:MaxRAMPercentage의 기본값은 25%입니다(Oracle Java 21 문서 기준). 한도가 2Gi인데 힙을 따로 정하지 않았다면 힙 최대 크기는 약 512Mi라서, 컨테이너 메모리는 넉넉한데 힙이 먼저 바닥나 OutOfMemoryError와 잦은 GC가 나타납니다. -Xmx를 한도보다 지나치게 낮게 넣은 경우도 증상이 같습니다.
실행 중인 JVM이 실제로 정한 힙 최대 크기와 힙 밖 메모리 구성은 다음 명령으로 확인합니다.
# 실행 중인 JVM의 힙 최대 크기와 컨테이너 인식 관련 플래그
kubectl exec <파드> -n <네임스페이스> -- sh -c "jcmd 1 VM.flags -all | grep -E ' (MaxHeapSize|MaxRAMPercentage|UseContainerSupport) '"

# 힙 밖 메모리 구성 (-XX:NativeMemoryTracking=summary로 시작한 JVM만)
kubectl exec <파드> -n <네임스페이스> -- jcmd 1 VM.native_memory summary
VM.native_memory 결과에서 Java Heap을 뺀 나머지 항목(메타스페이스, 스레드 스택, JIT 코드 캐시, 다이렉트 버퍼 등)을 더하면 힙 밖에 남겨야 할 메모리가 나옵니다. 힙을 -XX:MaxRAMPercentage로 정하면 한도를 바꿀 때 힙도 같은 비율로 따라 바뀌니, 비율은 측정한 힙 밖 사용량을 남기도록 정합니다.
replicas나 HPA 확장이 해결책이 되는 경우와 아닌 경우
파드 수를 늘리면 파드 하나가 받는 요청이 줄어, 메모리가 동시 요청 수에 비례해 늘어나는 서비스에서 OOMKilled가 줄어듭니다.
HPA(Horizontal Pod Autoscaler, 지표에 따라 파드 수를 자동으로 조절하는 기능)는 메모리 사용률을 requests 대비로 계산합니다. 앞서 본 것처럼 GC 런타임은 메모리를 늦게 돌려주므로, 메모리 기준 HPA는 늘린 파드를 줄이지 못할 수 있습니다. 또 HPA는 지표를 수집한 다음에 반응하므로, 몇 초 만에 치솟는 사용량은 파드가 늘어나기 전에 OOMKilled로 끝납니다. 순간 피크가 큰 서비스는 요청 수나 CPU 같은 부하 지표로 확장하고, 순간 피크에 대비해 limits에 여유를 둡니다.
OOMKilled 원인이 안 보일 때, 노드 메모리 부족과 커널 로그 확인하기
명령 세 개와 종료 패턴으로 원인이 좁혀지지 않으면 컨테이너 밖이나 OOM이 아닌 쪽에서 원인을 찾습니다.
OOMKilled와 Evicted, OutOfMemoryError 구분하는 법
메모리가 모자라 컨테이너가 멈추는 경로는 네 가지이고, 경로마다 종료하는 쪽과 남는 기록이 다릅니다.
컨테이너 한도 초과는 OOMKilled로 기록되는 대표적인 경우입니다. 사용량이 memory.max(limits.memory를 cgroup v2에 반영한 값)에 이르면 커널은 회수할 수 있는 캐시를 먼저 비우고, 그래도 모자라면 컨테이너 안의 프로세스를 한꺼번에 종료합니다(kubelet 기본 설정 기준. 프로세스 하나만 종료되는 예외는 자주 묻는 질문 참고).
노드의 물리 메모리 자체가 고갈되면 커널은 노드 전체에서 프로세스를 골라 종료합니다. 자기 한도를 넘지 않은 컨테이너도 이웃 파드 때문에 종료될 수 있고 이때도 OOMKilled가 남을 수 있어, 컨테이너 한도 초과와는 아래 노드 커널 로그로 구분합니다.
kubelet 축출(Evicted)은 노드의 남은 메모리가 임계값 아래로 떨어질 때 kubelet이 파드를 내보내는 경우입니다. 같은 파드를 재시작하는 대신 Deployment 같은 컨트롤러가 새 파드를 만듭니다.
Java처럼 힙을 따로 관리하는 런타임은 커널보다 먼저 런타임 힙 고갈로 멈추기도 합니다. 로그에 OutOfMemoryError가 남으니 kubectl logs로 로그를 열고, 컨테이너가 재시작됐다면 --previous를 붙여 직전 컨테이너 로그를 봅니다.
Exit Code 137인데 OOMKilled가 아닌 경우
Exit Code 137은 128에 SIGKILL 번호 9를 더한 값이고, OOM 킬러 말고도 SIGKILL을 보내는 쪽이 있습니다.
- 종료 유예 시간 초과: 파드 삭제, 롤링 업데이트, livenessProbe 실패로 컨테이너를 멈출 때 kubelet은 SIGTERM(정리할 시간을 주는 종료 요청 신호)을 보낸 뒤
terminationGracePeriodSeconds(기본 30초) 안에 프로세스가 끝나지 않으면 SIGKILL을 보냅니다. 1번 결과에 Error와 137이 함께 나오고, 이벤트에 Killing이나 Unhealthy가 남습니다. - 직접 보낸 kill -9나 래퍼 스크립트: 사람이나 운영 스크립트가 SIGKILL을 보냈거나, 애플리케이션을 띄운 셸 스크립트가 자식 프로세스의 137을 그대로 돌려준 경우입니다.
SIGTERM을 받고 스스로 끝난 프로세스는 보통 143(128+15)으로 종료합니다.
노드 커널 로그로 컨테이너 한도 초과와 노드 메모리 고갈 구분하기
커널 로그는 노드에 접속할 권한이 있어야 볼 수 있습니다. 관리형 쿠버네티스처럼 노드 접속이 막혀 있다면 클러스터 운영자에게 종료 시각과 노드 이름을 전달해 확인을 요청합니다.
# 노드에서 실행 (2시간 이내 OOM 기록)
journalctl -k --since "2 hours ago" | grep -iE 'out of memory|oom-kill'
# 컨테이너 한도 초과 (cgroup OOM)
oom-kill:constraint=CONSTRAINT_MEMCG,...Memory cgroup out of memory: Killed process 23514 (java) total-vm:..., anon-rss:...
# 노드 전체 메모리 고갈
oom-kill:constraint=CONSTRAINT_NONE,...
Out of memory: Killed process 23514 (java) total-vm:..., anon-rss:...constraint가 CONSTRAINT_MEMCG이고 문구가 Memory cgroup out of memory로 시작하면 컨테이너 한도 초과, CONSTRAINT_NONE에 Out of memory면 노드 전체 메모리 고갈입니다. SystemOOM 노드 이벤트는 환경에 따라 남지 않으므로 커널 로그를 기준으로 봅니다.
QoS 클래스와 노드 메모리 압박
QoS(Quality of Service) 클래스는 컨테이너에 requests와 limits를 어떻게 넣었느냐로 쿠버네티스가 정하는 파드 등급입니다. 모든 컨테이너의 CPU와 메모리에 requests와 limits를 같은 값으로 넣으면 Guaranteed, 일부만 넣었거나 requests와 limits를 서로 다른 값으로 넣으면 Burstable, 아무것도 넣지 않으면 BestEffort입니다. 앞 사례처럼 requests 256Mi, limits 512Mi인 파드는 Burstable입니다.
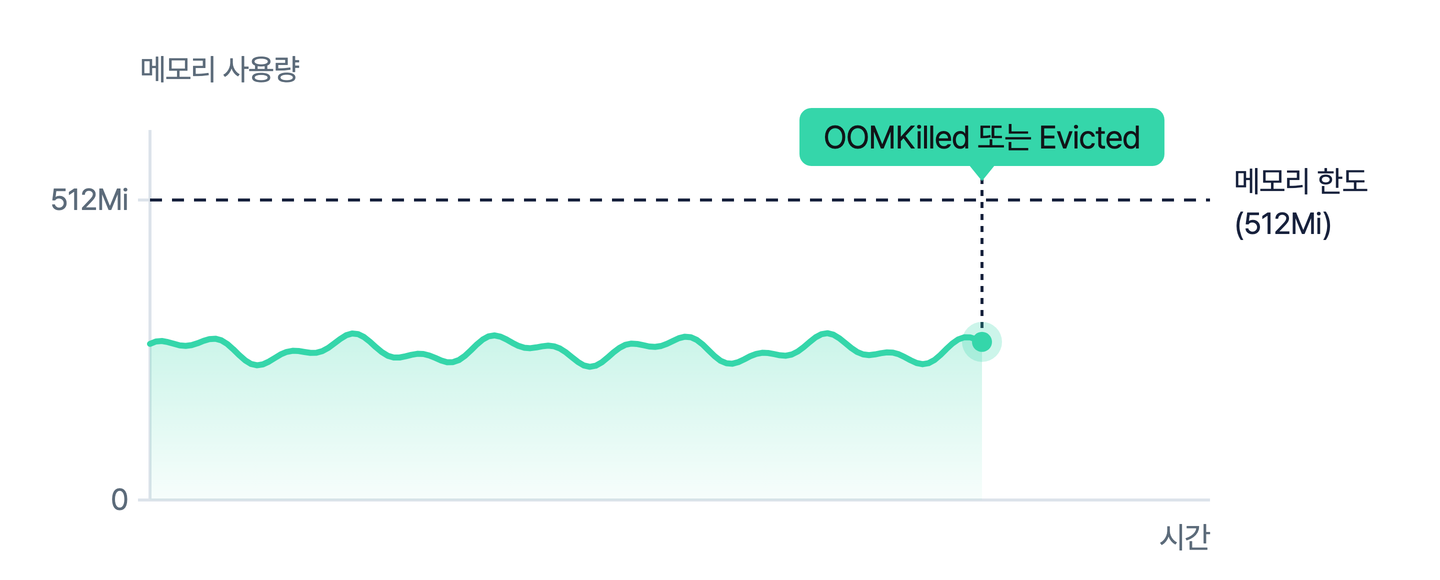
노드 메모리가 부족할 때 커널 OOM 킬러는 kubelet이 QoS 클래스별로 넣어 둔 점수 보정값(oom_score_adj)을 반영하므로, 메모리 사용량이 비슷하면 BestEffort가 먼저, Guaranteed가 나중에 종료 대상이 됩니다. kubelet 축출은 QoS 클래스 대신 사용량이 requests를 넘었는지와 파드 우선순위로 대상을 고르므로, 두 경로 모두 requests를 실제 사용량보다 낮게 둔 파드가 먼저 종료 대상이 되기 쉽습니다. QoS 클래스와 노드 상태는 다음 명령으로 봅니다(노드 조회는 클러스터 읽기 권한 필요).
kubectl get pod <파드> -n <네임스페이스> -o jsonpath='{.status.qosClass}'
kubectl describe node <노드> | grep MemoryPressure

# memory 행의 Limits 비율이 100%를 크게 넘으면 limits 합계가 노드 메모리보다 큰 오버커밋 상태
kubectl describe node <노드> | grep -A8 'Allocated resources'
자주 묻는 질문
kubectl top으로 본 메모리는 한도보다 낮았는데 왜 OOMKilled가 났나요?
kubectl top 값은 metrics-server가 일정 주기로 모은 표본이라 수집 사이의 순간 피크는 빠집니다. 애플리케이션 밖에서 메모리를 쓰는 경우도 있습니다. medium: Memory로 만든 emptyDir 볼륨은 tmpfs(메모리를 디스크처럼 쓰는 파일 시스템)라서 그 안에 쓴 파일이 컨테이너 메모리 사용량에 들어가고, sizeLimit을 정하지 않으면 그 볼륨이 파드의 메모리 한도까지 찰 수 있습니다. 커널이 지원하면 memory.peak 파일로 지금 컨테이너가 뜬 뒤의 최대 사용량을 확인할 수 있습니다.
memory limits를 빼면 OOMKilled가 사라지나요?
컨테이너 한도 초과로 생기는 OOMKilled는 사라지지만, 그 컨테이너가 노드 메모리를 제한 없이 쓰게 됩니다. 노드 메모리가 고갈되면 한도가 없는 컨테이너가 먼저 종료되기 쉽고, 같은 노드의 다른 파드까지 축출될 수 있습니다. requests까지 비우면 BestEffort가 되어 노드 OOM 때 가장 먼저 종료됩니다.
OOMKilled 기록 없이 컨테이너 안의 워커 프로세스만 사라질 수 있나요?
cgroup v1 노드이거나, cgroup v2 노드에서 kubelet 설정 singleProcessOOMKill: true(1.32 이상)를 켠 경우에는 그럴 수 있습니다. OOM 킬러가 컨테이너 안의 프로세스를 하나씩 종료하므로, 주 프로세스(PID 1)가 살아 있으면 컨테이너는 끝나지 않고 OOMKilled나 재시작 기록도 남지 않습니다. cgroup v2라면 memory.events의 oom_kill 값이 오르는지, cgroup v1이라면 노드 커널 로그에 해당 프로세스의 Killed process 기록이 있는지 확인합니다. memory.events는 컨테이너 안의 /sys/fs/cgroup/memory.events 파일이라 kubectl exec로 cat해서 봅니다.
오래된 JDK나 Node.js도 컨테이너 메모리 한도를 읽나요?
쿠버네티스 문서 기준으로 cgroup v2를 완전히 지원하는 OpenJDK는 8u372, 11.0.16, 15 이후 버전이고, Node.js는 20.3.0부터 cgroup v2 한도를 읽습니다. 그 이전 버전은 노드 전체 메모리를 기준으로 힙 최대 크기를 계산해 OOMKilled로 이어질 수 있으므로, Node.js는 --max-old-space-size로 힙 크기를 직접 정합니다.
마치며
OOMKilled가 보이면 kubectl 명령 세 개로 종료 사유, 이벤트, 메모리 사용량을 확인하고 종료 패턴으로 원인 후보를 좁힙니다. 그래도 원인이 보이지 않으면 노드 커널 로그와 QoS 클래스까지 확인합니다. 컨테이너가 재시작되면 cgroup 값은 처음부터 다시 쌓이고 이벤트도 1시간 남짓이면 사라집니다. 컨테이너별 메모리 사용량과 OOMKilled 발생 시각을 시계열로 남겨 두면 다음 종료 때 그래프 모양으로 원인 후보를 바로 고를 수 있습니다.
신규 서비스를 열면서 컨테이너 OOM과 Java 힙 부족을 차례로 겪은 고객사가 replicas 확장과 힙 재설정으로 해결한 과정은 와탭으로 쿠버네티스 OOM을 해결한 사례에서 확인할 수 있습니다.
더 읽을거리